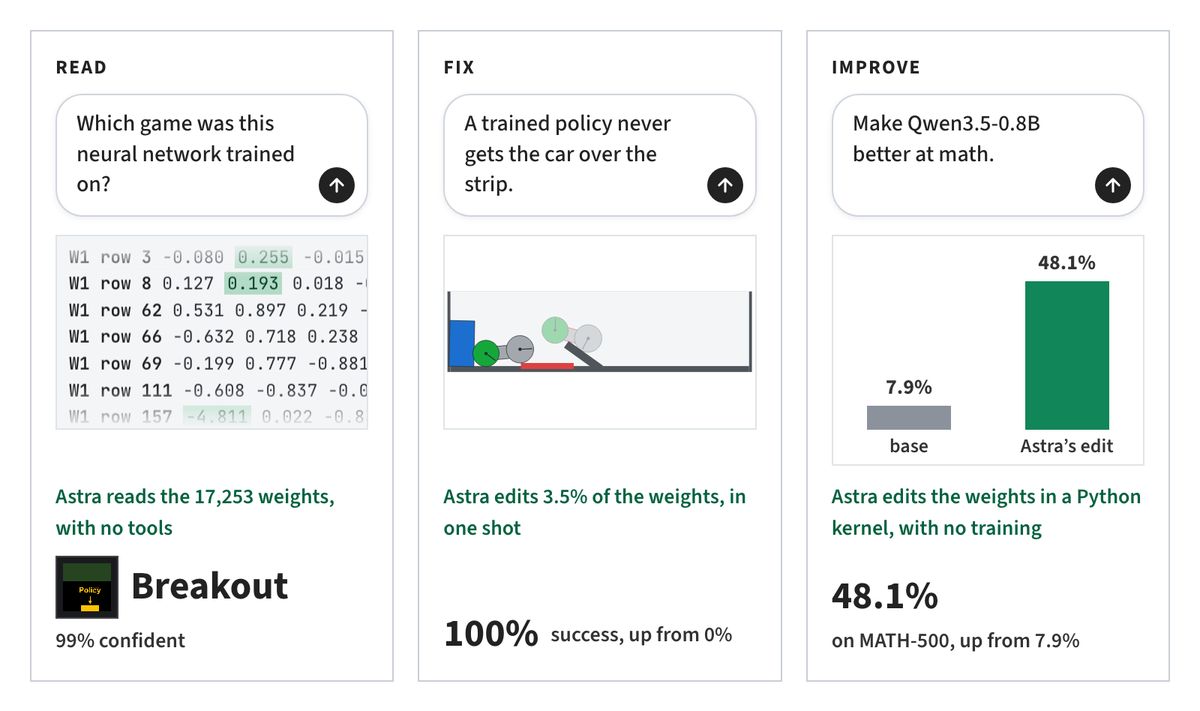
Исследователи MIT CSAIL (Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab) 2 ноября 2026 года опубликовали блог-пост Sparks of Weight-Space Programming: фронтирная модель GPT-6 Astra умеет читать и записывать веса нейросетей напрямую, без градиентного спуска и циклов обучения. В главном примере она нашла в Qwen3.5-0.8B одно направление в весах, из-за которого рассуждения зацикливались, вычла его и подняла точность на MATH-500 с 7,9% до 48,1%, изменив 0,016% параметров модели. Это пока исследовательский блог-пост, а не готовый продукт.

Что произошло
Пост описывает восемь экспериментов с одной моделью-редактором GPT-6 Astra. В первых она по одним только весам определила, на какой из игр (Breakout, Pong, Pac-Man, Freeway) обучена MLP из 17 253 весов и какой язык (Python, Romaji, English) выучил трансформер на 7,2M параметров. В другой серии Astra написала с нуля политики для окружений MinAtar, которые превзошли PPO после 100M+ шагов обучения. Главный инженерный результат — ремонт Qwen3.5-0.8B: модель нашла в весах MLP-слоёв 15 и 19 направление, вызывавшее зацикливание рассуждений, и вычла его из 131 072 весов. После правки GSM8K вырос с 13,8% до 67,1%, IFEval с 21,0% до 62,3%, а доля ответов, упирающихся в лимит токенов, упала с 93% до 33,1%.
Контекст
Обычно параметры нейросети меняются только в обучающем цикле: алгоритм вроде backpropagation считает градиенты, и тысячи шагов постепенно сдвигают веса. Авторский термин Weight-Space Programming описывает другой режим: языковая модель читает чекпоинт как данные, рассуждает о функциях слоёв и вносит целевые правки в конкретные веса. Авторы сами ограничивают интерпретацию: показанный рост метрик — это repair, а не gain, потому что на моделях без зацикливаний такая же правка не дала ничего. Важен и формат: публикация сделана в жанре блог-поста с демонстрациями, а не рецензируемой работы, поэтому это пока заявка и приглашение к повторению, а не установленная практика.
Почему это важно для индустрии
Если правки весов подтвердятся на других моделях, у индустрии появится ещё один режим работы с весами рядом с обучением и fine-tuning: диагностика дефекта, точечный патч и проверочная серия прогонов вместо полного training run. Привлекательно это потенциальной ценой, потому что правка затрагивает крошечную долю параметров против дорогого дообучения, но зрелости нет: ни API, ни прайсинга, ни оценок латентности, а редактор — одна закрытая фронтир-модель. Сейчас командам доступны два практических шага: дешёвый мониторинг зацикливаний по доле ответов, которые упираются в лимит токенов, и разбор оригинального поста, чтобы оценить, какие шаги реплицируемы на маленьких открытых моделях. Если появятся код и независимые повторения, вероятны первые open-source утилиты точечного ремонта малых моделей и бенчмарки регрессий после правок; в отдалённой перспективе обсуждается контур «мониторинг патологий, полуавтоматический патч с diff-ревью человеком» как отдельный этап обслуживания моделей.
Почему это важно для пользователей
Использовать это сегодня нельзя: нет API, инструмента или открытой реализации, а доступен только оригинальный пост MIT CSAIL с цифрами — пока это способ лучше понять тему, а не возможность что-то применить. Симптом при этом знаком каждому, кто пользуется чат-моделями: когда модель из раза в раз упирается в лимит токенов, повторяя одну и ту же цепочку рассуждений, это ровно тот класс дефекта, который чинили авторы. Отслеживать стоит два сигнала: выкладку кода и независимые повторения на открытых моделях; только после них точечный ремонт весов может дойти до реальных продуктов, влияющих на повседневный опыт работы с моделями.
Что пока неизвестно / ограничения
Подтверждение каждой правки требует 50 пробных прогонов, а проверка того, не деградировали ли прочие способности модели, не проводилась, хотя авторы сами оговаривают риск побочных эффектов. Всё показано на одной паре моделей: закрытая GPT-6 Astra в роли редактора и маленькая Qwen3.5-0.8B в роли пациента, при этом данных о переносе на большие модели нет. Capability-заявка о написанных с нуля политиках для MinAtar требует более строгой проверки, чем repair-эксперименты. Наконец, публикация не проходила рецензирование, поэтому любая цифра пока держится на честном слове авторов.
Источники
- Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights (MIT CSAIL)
- Weight-Space Programming — GPT-6 Astra reads and writes weights (AI/TLDR)
- GPT-6 Astra Edits Neural Weights Directly, No Gradients (Emergent)
Автор
Look at AI, редакция