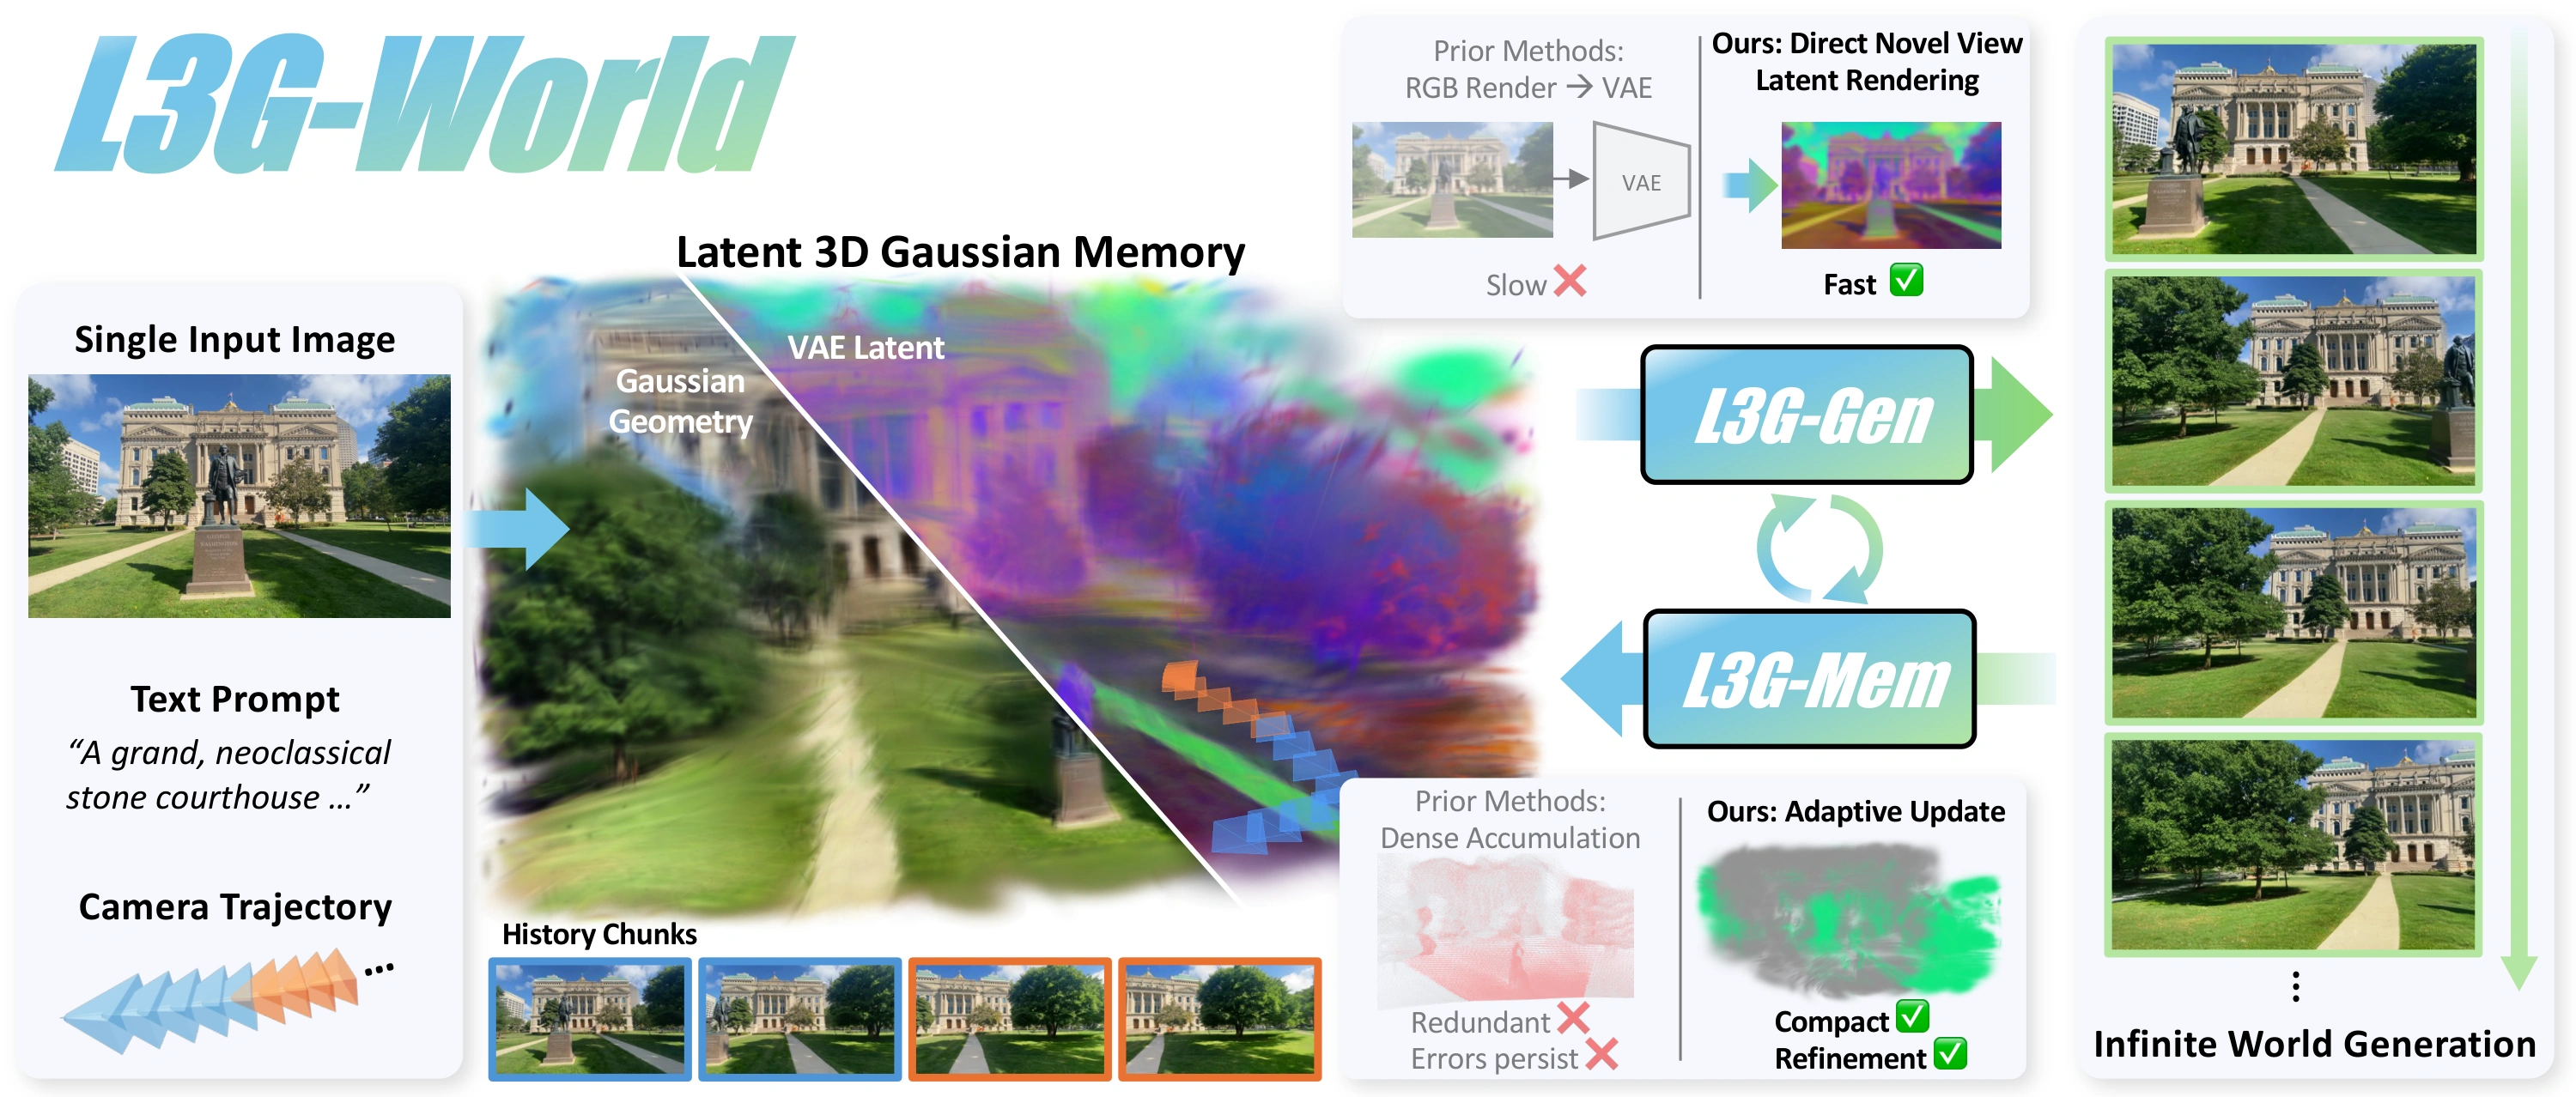
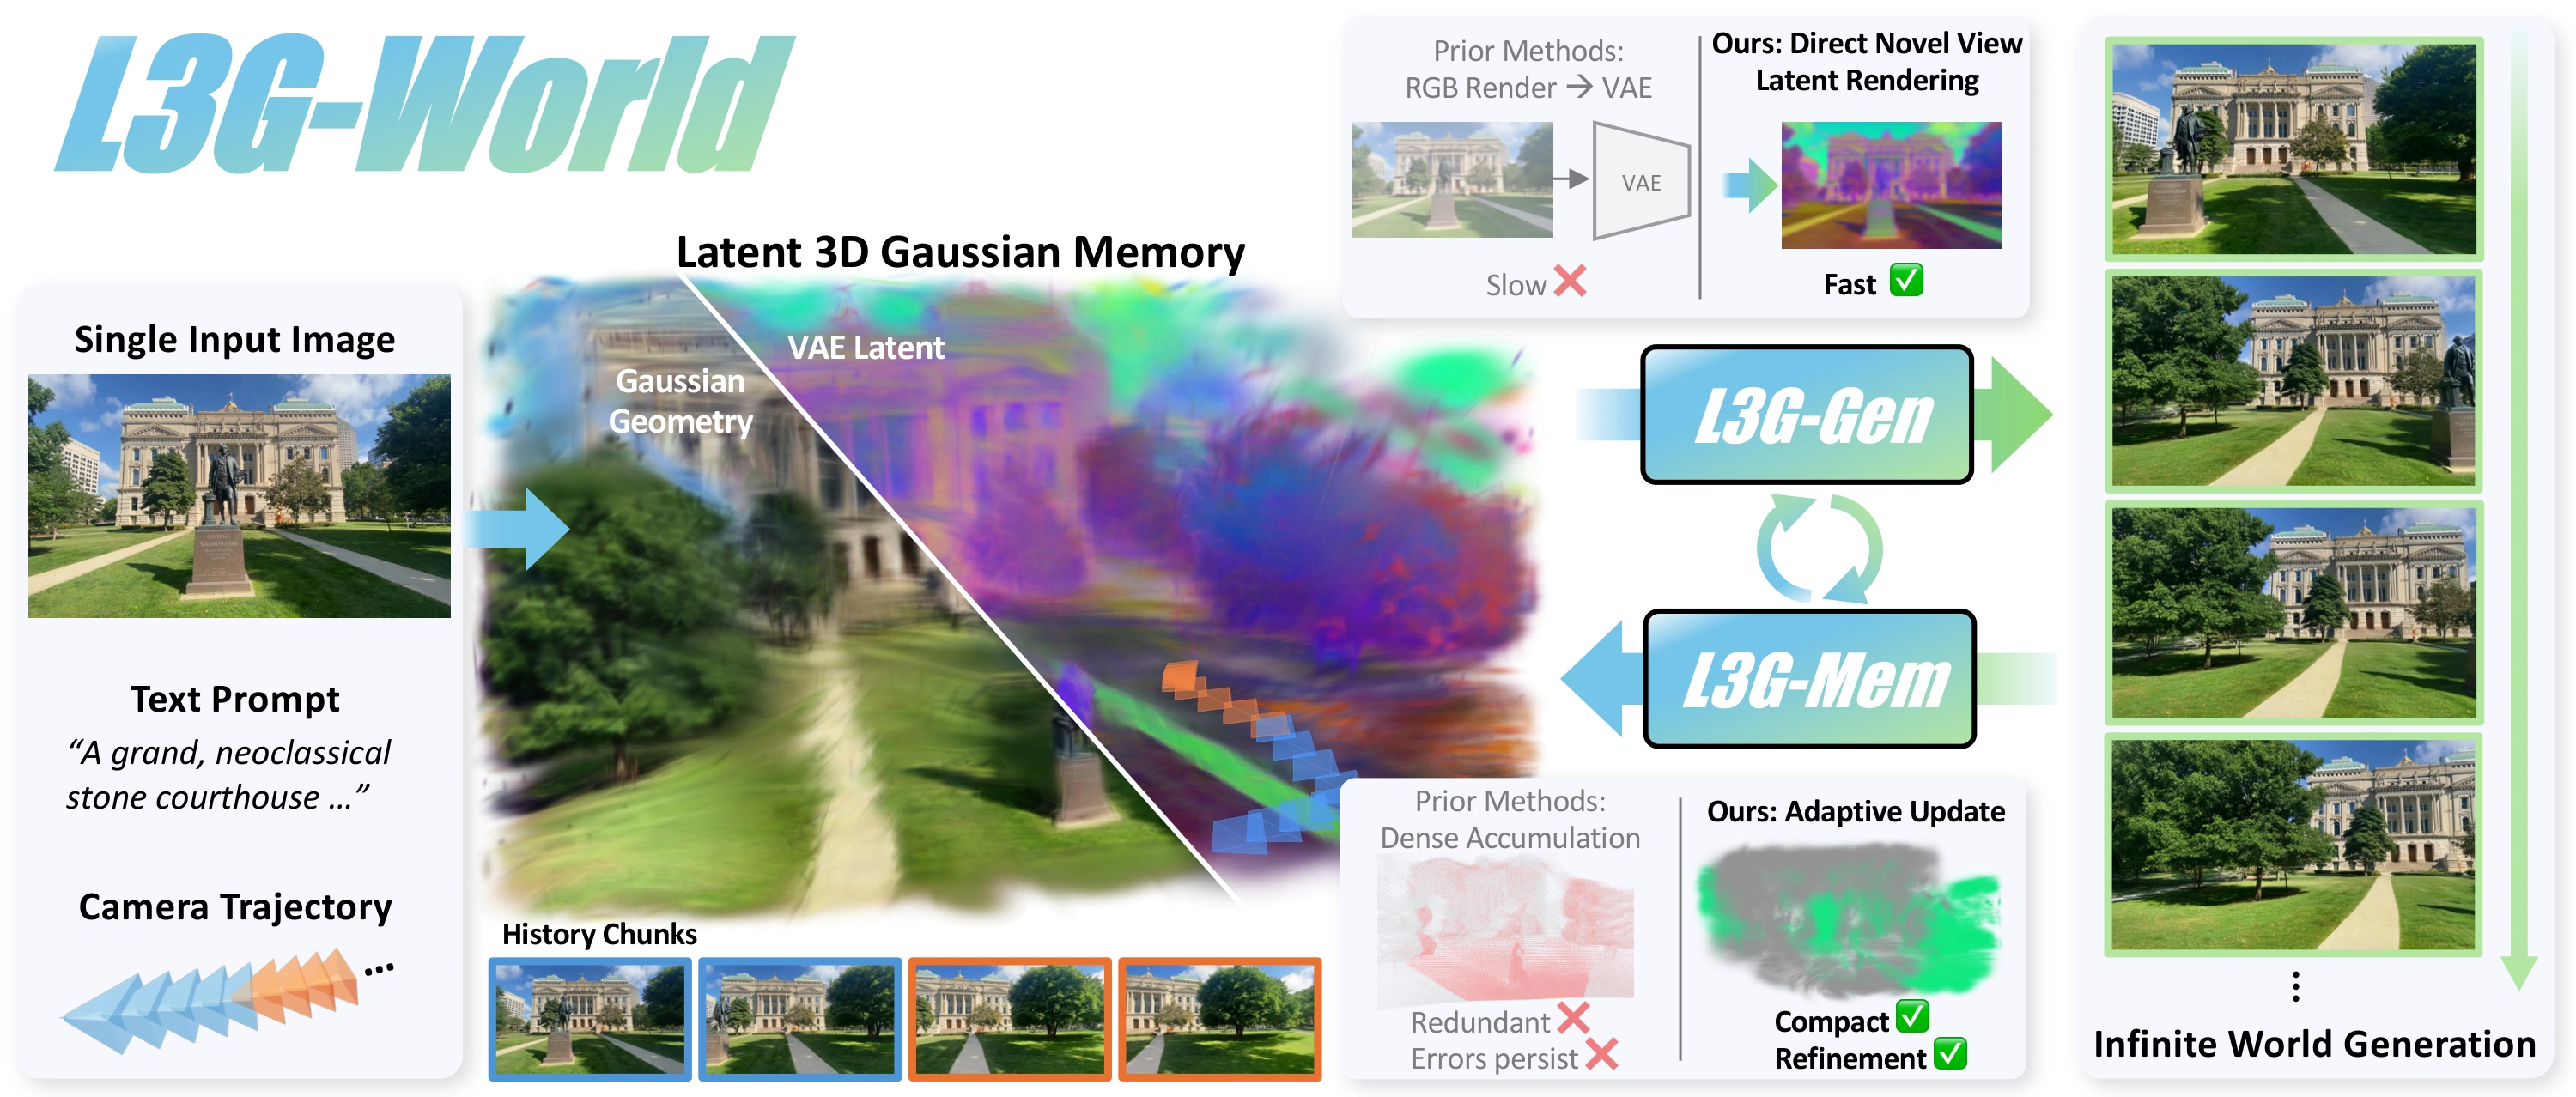
Лаборатория компьютерного зрения KAIST (Jinhyeok Choi, JoungBin Lee, Seungryong Kim и соавторы) представила L3G-World — фреймворк, который генерирует бесконечные 3D-миры в реальном времени из одного изображения, текста и траектории камеры. В основе лежит латентная 3D-гауссова память L3G-Mem: система достраивает мир на лету, помнит исследованные области и сохраняет согласованность сцены при возвращении камеры, а работает в реальном времени на одной NVIDIA A100. Открытого кода и весов пока нет: посмотреть можно демо-видео на странице проекта, а релиз обещан в репозитории cvlab-kaist/L3G-World.

Что произошло
29 октября 2026 года на arXiv вышла работа под названием L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory (arXiv:2610.40614). Фреймворк состоит из двух частей. Первая — L3G-Mem, латентная 3D-гауссова память, в которой каждый гауссов примитив хранит VAE-латент и рендерится прямо в latent-пространство видео-диффузионного трансформера (DiT) под названием L3G-Gen, минуя RGB-рендеринг и повторное кодирование VAE. Вторая особенность — модель роста памяти: она растёт по мере исследованной сцены, а не по длине сгенерированного потока, новые области получают новые гауссины, а уже отмеченные при повторных визитах камеры уточняются. По авторским измерениям на A100 обновление памяти идёт на 47 FPS, генерация мира — на 9 FPS, а чтение памяти — на уровне 1000+ FPS VAE-рендеринга. Против самого экономичного 3D-memory бейзлайна у L3G-World до 38.6x меньше примитивов (25–33 тысячи против тысяч и сотен тысяч), обновление памяти в 3.2x быстрее, чтение в 359x быстрее, а пиковое потребление памяти на 2.56x ниже. Базовыми компонентами системы служат NVIDIA Cosmos-Predict2.5 и ZipSplat.
Контекст
Явная 3D-память давно выглядела естественным способом держать мир согласованным у world-моделей, но мешал формат обмена данными: видео-диффузионные модели работают в латентном пространстве VAE, а 3D-память удобнее читать геометрически, поэтому существующие системы рендерили кадры в RGB и заново прогоняли их через VAE-энкодер. Этот RGB→VAE round-trip съедал реальное время и не давал world-моделям с явной 3D-памятью работать в рилтайме. Вторая проблема — масштабирование памяти по длине сгенерированного потока: чем дольше генерация, тем больше память, что делало длинные сессии дорогими независимо от того, сколько мест в кадре реально было посещено. Идея привязать память к размеру исследованной сцены, а не к длительности видео, раньше оставалась скорее проектной гипотезой — L3G-World стал публичной попыткой довести её до конкретных измерений.
Почему это важно для индустрии
Для индустрии главное в работе — не цифры FPS, а архитектурный прецедент: латентный рендеринг 3D-гауссовой памяти прямо в latent-пространство видео-DiT как способ убрать RGB→VAE round-trip и добиться рилтайма у world-моделей с явной памятью. Команды, которые строят собственные world-model пайплайны, могут примерить этот паттерн и пересмотреть узкие места — обмен RGB↔латенты и рост памяти по длине потока. Для интерактивного 3D-контента, симуляций и игровых движков связка «память растёт по размеру сцены» впервые делает минутные консистентные миры практически достижимыми на одной A100 как инженерное направление. Прямо сейчас деплоить нечего: кода, чекпоинтов и API нет. Осмысленно — разобрать архитектуру по arXiv:2610.40614, спроектировать UX вокруг траектории камеры, подготовить сценарии интеграции в движки, фото-приложения и симуляторы агентов, а также наблюдать за репозиторием: обещанная few-step модель может заметно сдвинуть заявленные 9 FPS, а после релиза вероятны независимые воспроизведения и волна follow-up работ с прямым латентным рендерингом памяти.
Почему это важно для пользователей
Для читателя это один из первых генераторов «бесконечных миров» из одной фотографии, работающих в реальном времени и сохраняющих согласованность сцены при каждом возвращении камеры: прогуляться по локации, уйти и вернуться можно в тот же мир, а не в его новую версию. Пока попробовать L3G-World нельзя — доступно только демо-видео на странице проекта. Практичный шаг сейчас один: включить наблюдение за репозиторием cvlab-kaist/L3G-World, куда авторы обещают выложить inference-код, чекпоинты L3G-Mem и L3G-Gen и few-step модель. Если результаты подтвердятся после релиза, такие миры могут дойти до личного применения: персональные 3D-пространства из фотографий и интерактивный контент, где мир не «переезжает» под камерой при повторных заходах.
Что пока неизвестно / ограничения
Ключевые цифры — 47 FPS обновления памяти, 9 FPS генерации и 1000+ FPS чтения — это авторские измерения на A100, которые третьи стороны пока не могут воспроизвести: кода, весов и API нет, репозиторий пуст. Рост памяти по размеру сцены, а не по длине потока — пока проектное утверждение авторов, а не проверенная гарантия; статус гарантии он получит только после независимого воспроизведения на выложенном коде. Часть качества система наследует от базовой видео-модели NVIDIA Cosmos-Predict2.5, и без ablations из полной версии статьи вклад L3G-Mem нельзя отделить от вклада базы. Поведение на длинных траекториях, включая возможный дрейф, остаётся открытым вопросом, а лицензия на будущие код и веса не объявлена.
Источники
- L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory — научная работа на arXiv:2610.40614
- L3G-World — официальная страница проекта KAIST CV Lab
- cvlab-kaist/L3G-World — официальный репозиторий реализации на GitHub
Автор
Look at AI, редакция