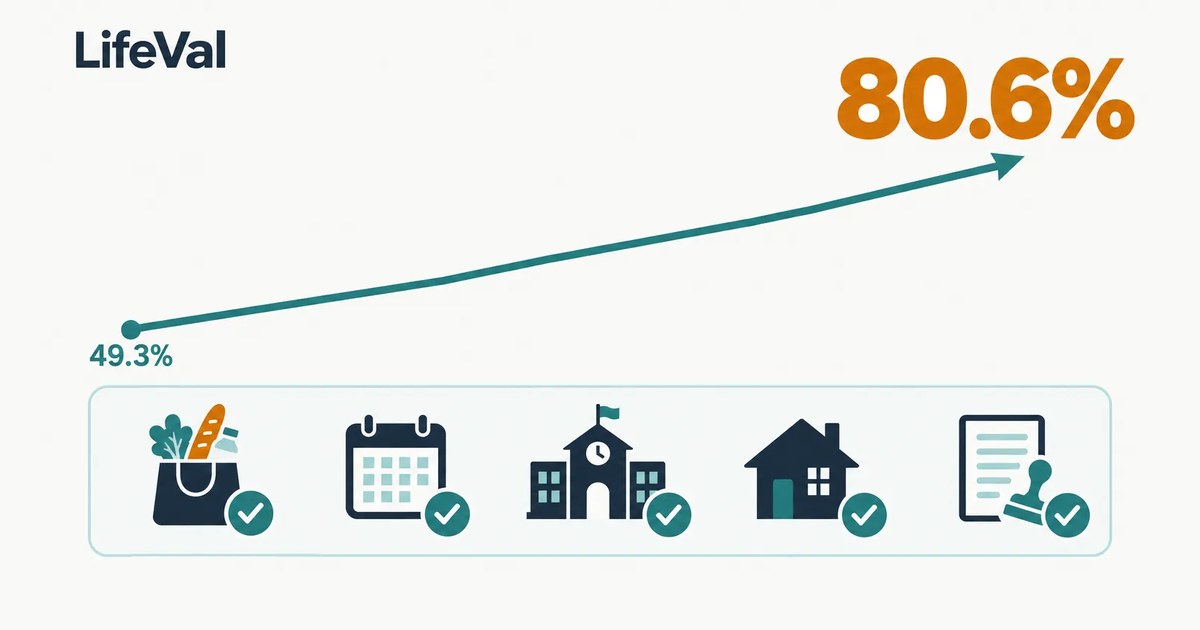
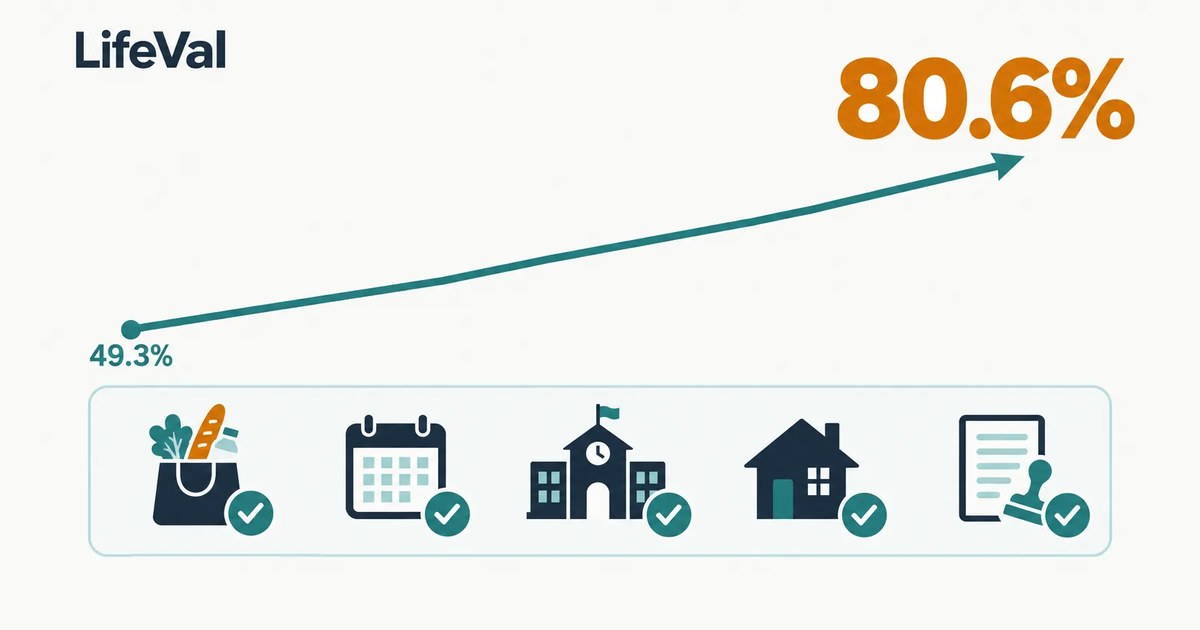
2 ноября 2026 года OpenAI опубликовала LifeVal — бенчмарк, по которому компания целый год внутри себя измеряла прогресс агентов ChatGPT на реальных повседневных задачах пользователей. Средняя награда за доведённое до конца дело выросла более чем на 30 процентных пунктов и достигла 80,6% у GPT-6 Astra, однако темп прогресса быстро упёрся в потолок около 80%. При этом цифра 80,6% — оценка самого разработчика: задачник и методика закрыты, независимой проверки пока нет.
Что произошло
OpenAI раскрыла LifeVal — внутренний тест, который в течение года служил мерилом прогресса агентов ChatGPT. Задания охватывают семь категорий повседневной жизни: уход за близкими, здоровье, образование, домашние дела, личные финансы, покупки и государственные сервисы. Сценарии построены не синтетически, а на данных American Time Use Survey от BLS, Multinational Time Use Study и на опросе 3 995 человек. Агенту требуются browser use, computer use и коннекторы к сервисам, а оценивается не качество совета, а доведение дела до конца. По данным OpenAI, средняя награда выросла с 49,3% у GPT-5.2 (11 декабря 2025 года) до 73,0% у GPT-5.4 (март 2026 года), затем до 77,4% у GPT-5.5, 80,0% у GPT-5.6 и 80,6% у GPT-6 Astra (сентябрь 2026 года). Сам задачник, где по данным трекера BenchLM перечислено 169 задач, и методика оценки закрыты.
Контекст
LifeVal фиксирует сдвиг в самой логике оценки агентов: OpenAI прямо признаёт, что модель «может выполнить все нужные клики и всё равно дать неподходящий результат», поэтому тест смотрит на конечное состояние дела, а не на отдельные шаги. Показательна и роль бенчмарка внутри компании: целый год LifeVal был не только линейкой, но и целью, под которую целенаправленно улучшали модели. Траектория результатов при этом рисует затухание темпа: релиз GPT-5.4 добавил сразу 23,7 процентного пункта к GPT-5.2, тогда как три следующих релиза суммарно дали лишь 7,6 п.п. Точка для контраста появилась в то же утро: независимая оценка GDPx от SemiAnalysis показала, что лучшие из 20 моделей набирают лишь около 12% на экспертной работе, — индустрии ещё предстоит договориться, что вообще считать «выполненной задачей».
Почему это важно для индустрии
Для билдеров главный сигнал — не цифра 80,6%, которую некому и нечем проверить, а подтверждённый самой OpenAI сдвиг целевой функции: агентов оптимизируют под «доведённое дело», а не под полезный совет. Логичный шаг для команд, строящих агентов, — перенести фокус внутренних оценок качества с качества ответа на долю задач, доведённых до конца, и добавить обязательный шлюз подтверждения человеком перед финальным действием. Вокруг сценариев, показанных в примерах LifeVal, уже можно прототипировать вертикальные потоки «агент делает черновую работу целиком, человек только подтверждает», но валидировать такие потоки следует на собственном задачнике, собранном из реальных задач компании. Нишевые ассистенты в категориях LifeVal теряют дифференциацию «мы доводим дела до конца», потому что бытовая рутина быстро становится фичей платформы с крупнейшей дистрибуцией. Заявления вида «80,6% на повседневных задачах» начнут циркулировать как proof point, поэтому первым вопросом при продуктовых и инвестиционных решениях должна быть открытость задачника и методики. Ожидаемо и подражание: вендоры начнут отчитываться собственными закрытыми «бытовыми» eval'ами, и рынок заполнится несопоставимыми цифрами с разными определениями успеха.
Почему это важно для пользователей
Плато около 80% означает, что ассистент уже реально пригоден для рутины, которую можно перепоручить целиком. В лучших прогонах GPT-6 Astra на 100% забронировал осмотр машины перед поездкой, заказал халяльные продукты в рамках заданного бюджета с таблицей-расчётом и избавил пользователя от спам-рассылок; в показанных примерах агент зачислил ребёнка в сад после переезда на 93,1% и скорректировал питание родителя с диабетом на 90,4%. Показательная деталь из материалов OpenAI: агент останавливается перед финальным шагом, оставляя подтверждение за человеком. Отсюда практический вывод: делегировать ассистенту бытовую черновую работу — сбор вариантов, расчёты, рутинные коммуникации — стоит уже сейчас, а финальные решения и подтверждения лучше оставлять себе.
Что пока неизвестно / ограничения
Главное ограничение: 80,6% нельзя проверить независимо. Задачник (169 задач по данным BenchLM — небольшая выборка) и методика оценки закрыты, все цифры проставила сама OpenAI, а среда выполнения — живые сайты или тестовые копии — не уточняется. Показанные кейсы с бронированием осмотра машины, зачислением ребёнка в сад и корректировкой питания родителя с диабетом — это витринные примеры, а не статистика: единичные кейсы с оценками от самого OpenAI не подтверждают стабильность результата. Стоимость и латентность одной агентной сессии не опубликованы. Поскольку год оптимизации шёл прямо под этот бенчмарк, без независимой репликации нельзя отделить рост реальной агентности от подгонки под задачник — классический риск Goodhart. OpenAI также не поясняет, что именно стало потолком — способности моделей или конструкция задач, — и не сравнивает результаты с Claude и Gemini.
Источники
Автор
Look at AI, редакция