Объединение CLEAR (Coalition for Language Equity in AI Research) 29 сентября 2026 года опубликовало исследование «The Tokenizer Tax»: токенизаторы LLM, обученные в основном на английском и десятке высокоресурсных языков, разбивают текст остальных языков на заметно больше токенов, а тарифы API считают деньги за токен, поэтому один и тот же смысл на другом языке обходится дороже. В замерах на известном наборе FLORES-200 из 203 пар язык-письменность ввод на амхарском у GPT-5 обходится примерно в шесть раз дороже английского, а разрыв между токенизаторами тянется от 2.7x у NLLB-200 до 17x у Falcon 3. CLEAR перевела эту надбавку из разрозненных наблюдений в публичный бенчмарк с понятной шкалой оценок A–F и открытым кодом, который любой может прогнать на своих языках.

Что произошло
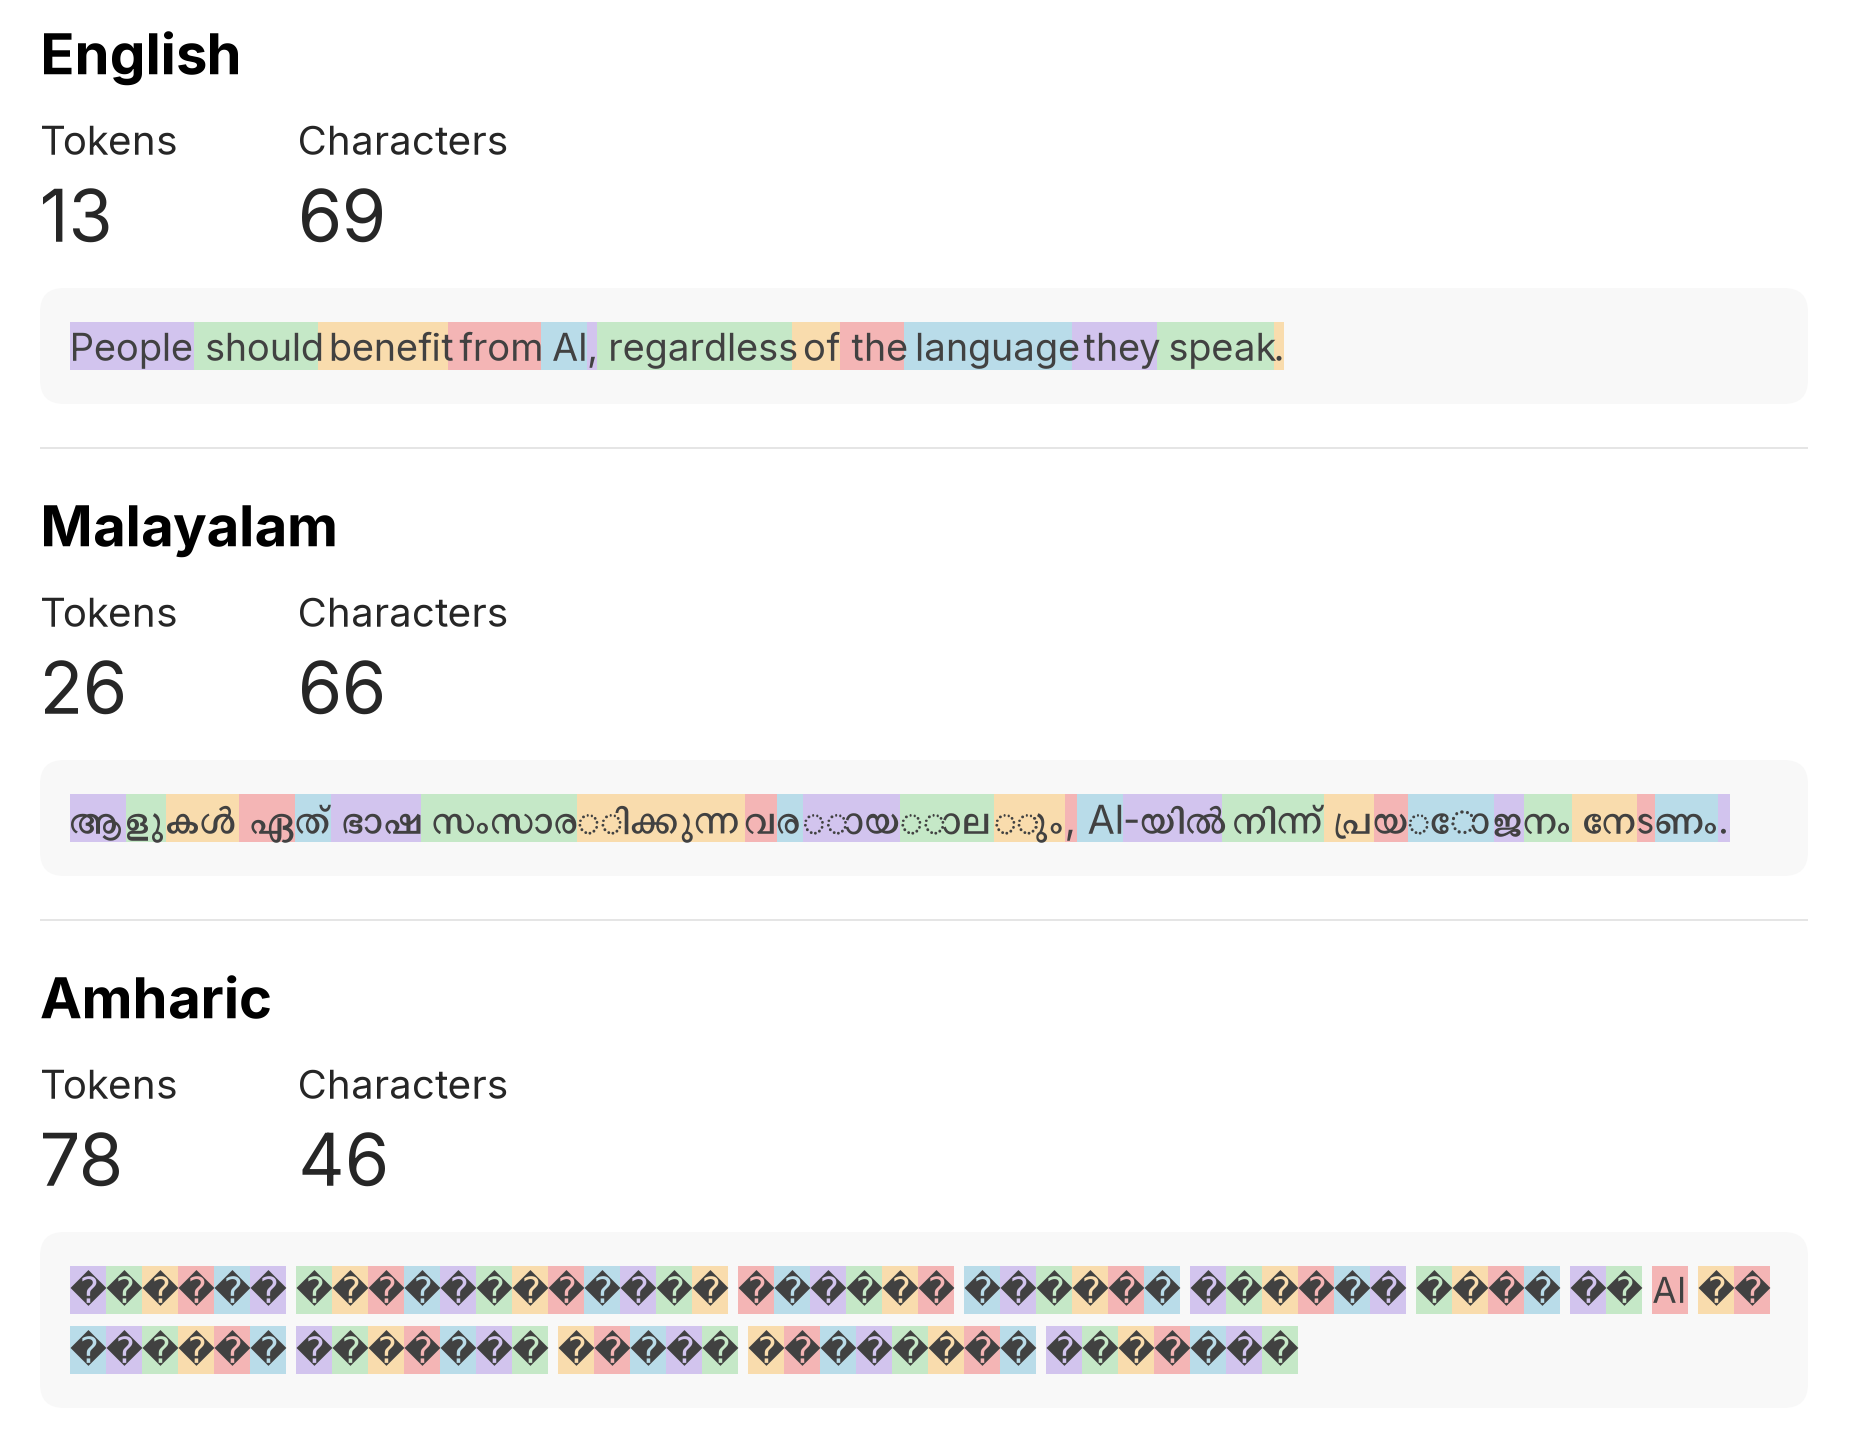
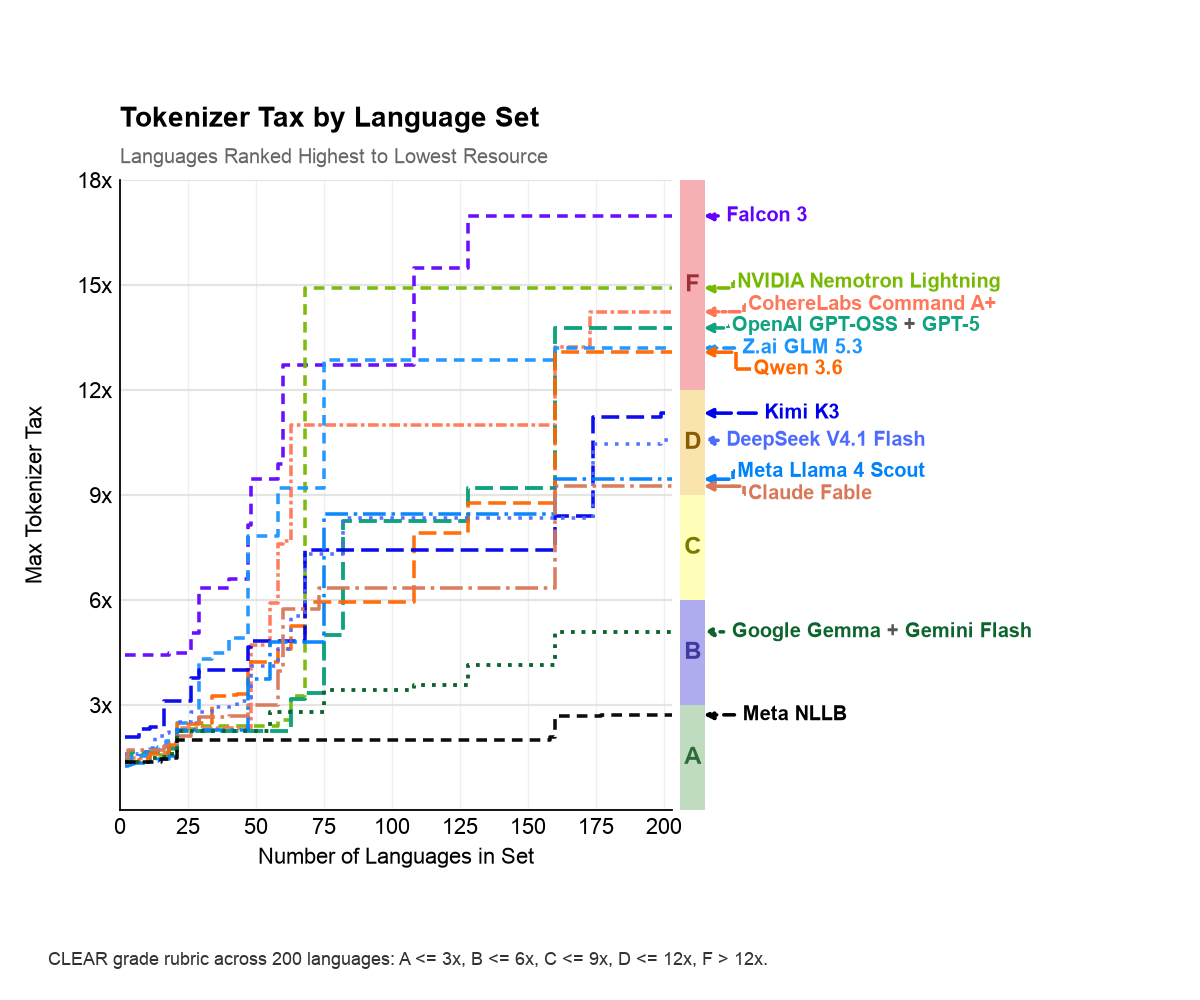
CLEAR подготовила измерительную, а не обзорную работу: одинаковым текстом прогнали токенизаторы главных модельных семейств и для каждой модели посчитали, во сколько раз самый дорогой язык дороже самого дешёвого по числу токенов. Базой стал известный набор FLORES-200 со 203 парами язык-письменность, метрикой — отношение max/min числа токенов плюс коэффициент Джини, а по соотношению выставлены оценки от A при разрыве до 3x до F при разрыве выше 12x. Наглядный замер: фраза «People should benefit from AI, regardless of the language they speak» у GPT-5 занимает 13 токенов на английском, 26 на малаялам и 78 на амхарском, поскольку каждый знак письменности Ge'ez распадается на два однобайтных токена. По итоговой шкале NLLB-200 от Meta получила единственную оценку A с соотношением 2.7x, семейство Gemini 3.8 Flash, Gemini 3.1 Pro, Gemma 3 и Gemma 4 — оценку B с 5.1x, GPT-5 и gpt-oss — оценку F с 13.8x, а худший результат около 17x показал Falcon 3. Код воспроизведения выложен в репозитории clear-coalition-ai/token-cost-equity на GitHub, а для привязки к деньгам исследование приводит тариф Anthropic Fable 5: 10 долларов за миллион входных и 50 долларов за миллион выходных токенов.
Контекст
Разрыв закладывается на этапе сборки словаря токенизатора, а не в момент запроса. BPE-токенизаторы обучают на англоязычном массиве и десятке высокоресурсных языков, а знакам, для которых в словаре нет заготовок, остаётся byte-fallback: символ заменяется его байтовым представлением, из-за чего редкие письменности платят за каждый знак. Тяжесть налога зависит от того, сколько языков отражено в словаре, что отдельно разбирается в публикации на графиках зависимости налога от количества языков. Показателен и единственный обладатель оценки A: NLLB-200 со словарём около 256 тысяч токенов задумана как переводческая система, а не универсальный чат-LLM. Из этого следует аккуратный вывод: проблему решают состав и размер словаря, но пока нет доказательств, что современные большие модели способны нарастить словарь без компромиссов по размерности эмбеддингов и вычислительной цене.
Почему это важно для индустрии
Для отрасли язык перестаёт быть незаметной деталью и становится измеримой переменной юнит-экономики: при тарифе за токен языковой коэффициент напрямую умножает счёт любого мультиязычного продукта. CLEAR формулирует конкретные требования — публиковать max/min-отношение по FLORES-200 и долю языков с соотношением меньше 2x в model cards, закладывать квоты словаря под малоиспользуемые письменности и переходить к ценообразованию, нормированному по символам или языкам, и первый провайдер, кто это сделает, задаст стандарт и получит аргумент в закупках. Практика меняется уже сейчас: команды могут прогнать открытый код CLEAR на собственном многоязычном трафике, посчитать свои коэффициенты и пересобрать сметы фич, а «дорогие» языки перераспределить на модели класса B по соотношению токенов, например Gemini 3.8 Flash или Gemma 4, вместо моделей класса F. Следующий шаг, на который указывают рекомендации, — включение токен-эффективности по языкам в eval-пайплайны и в обычные пункты сравнения моделей при закупках.
Почему это важно для пользователей
Если вы вызываете LLM-API на языке, отличном от английского, языковой коэффициент из замеров бенчмарка напрямую попадает в ваш счёт: тот же промпт занимает больше токенов, а заявленный длинный контекст, например 128 тысяч токенов, реально вмещает меньше текста, потому что дорогие письменности съедают квоту быстрее. Для тех, кто строит RAG и агентные сценарии на неанглийских документах, это означает, что эффективная длина контекста и стоимость пайплайна зависят от языка промптов, и сметы, посчитанные на англоязычных данных, окажутся заниженными. Выбор модели тоже меняется: кроме качества и цены за «средний» токен появляется третий критерий, токенная справедливость, и разница грейдов между моделями превращается в прямую разницу в счёте, особенно в бюджетных тарифах, где цена за токен критична. Свой язык и свой трафик можно проверить прямо сейчас открытым кодом бенчмарка, не дожидаясь отчётов вендоров.
Что пока неизвестно / ограничения
Цифры 13, 26 и 78 токенов — замер одной конкретной фразы, а не статистика по языку: для смет и пайплайнов нужны распределения по языкам и типам текста, и фактический множитель может заметно отличаться. Уровень эффекта для конкретного языка, включая русский, требует собственного замера на своём трафике по открытому коду: опубликованные соотношения измерены для перечисленных версий моделей и не переносятся автоматически на все версии и тарифы. Единственная модель с оценкой A является переводческой системой, что показывает работоспособность подхода, но не доказывает, что чат-LLM смогут расширить словарь без издержек на размерность эмбеддингов и вычисления. Наконец, ожидаемая публикация языковых метрик в model cards и сдвиг к ценообразованию по символам или языкам — это интерпретация рекомендаций CLEAR и прогноз, а не объявленные решения вендоров.
Источники
- The Tokenizer Tax — CLEAR (Coalition for Language Equity in AI Research)
- The Tokenizer Tax: Why non-english AI users pay more for tokens — Rest of World
- clear-coalition-ai/token-cost-equity — код воспроизведения бенчмарка (GitHub)
Автор
Look at AI, редакция