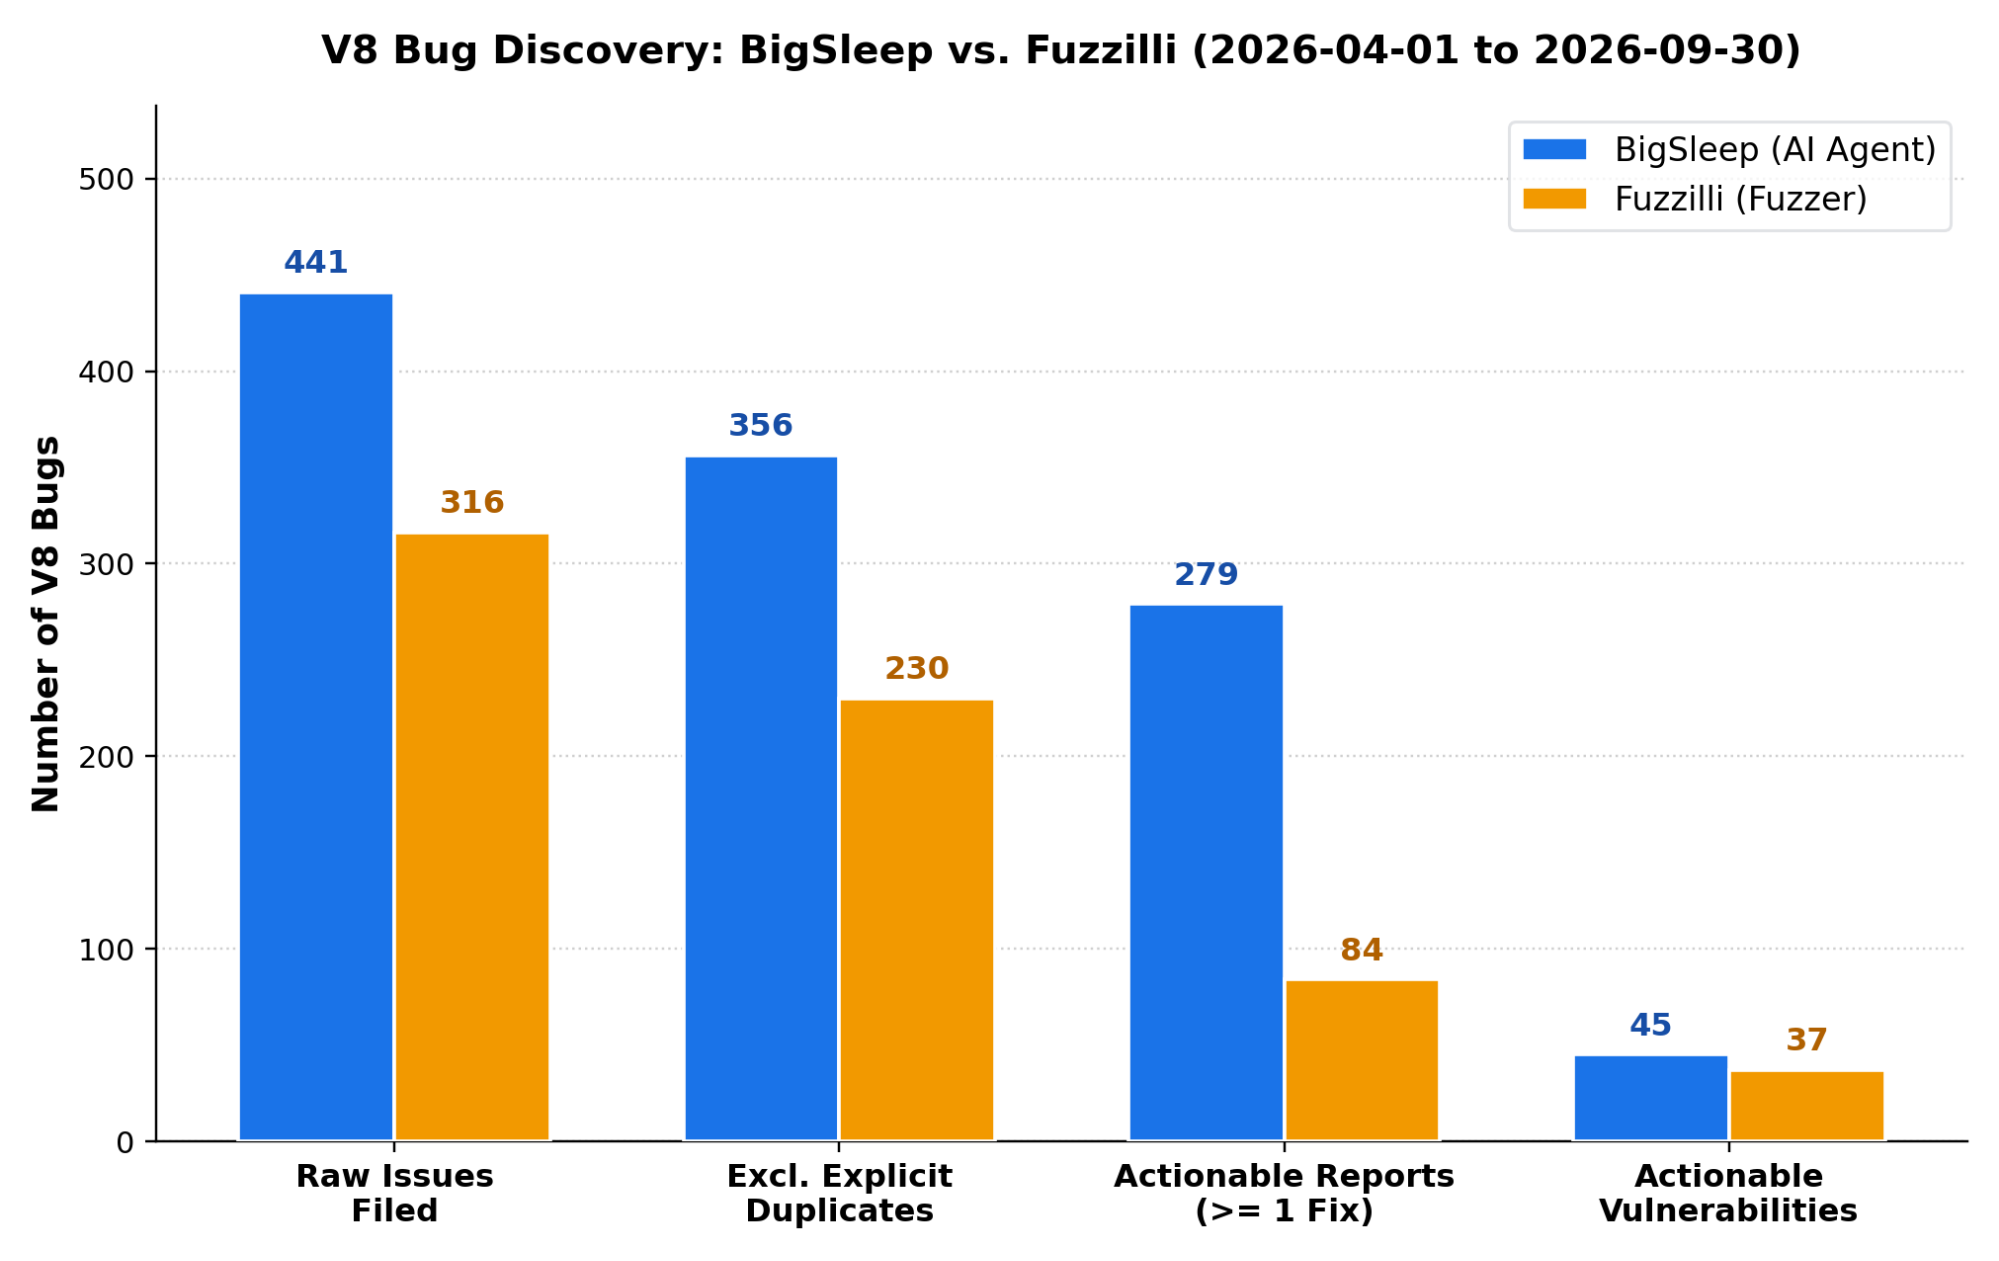
Google Project Zero провёл прямое количественное сравнение классического генеративного фаззера Fuzzilli и агентной системы BigSleep, построенной вокруг большой языковой модели, на движке V8, на котором работает браузер Chrome. За апрель-сентябрь 2026 года BigSleep нашёл 45 пригодных к исправлению уязвимостей против 37 у Fuzzilli, а пересечение находок в продакшене составило лишь около четверти. Вывод исследователей: два подхода ищут в разных участках пространства ошибок и дополняют друг друга, поэтому вендорам имеет смысл запускать и фаззинг, и агентный анализ параллельно.
Что произошло
Сравнение опубликовано в блоге Project Zero в октябре 2026 года. С апреля по сентябрь 2026 года обе системы работали на движке V8: BigSleep нашёл за это время 45 уязвимостей, пригодных к исправлению, Fuzzilli — 37, а пересечение найденных багов в продакшене составило 20 из 81, то есть около 25%. Отдельной серией авторы проверили, как агент справляется с уже известными ошибками: из 112 исторических багов Fuzzilli 2023-2026 годов BigSleep на модели Gemini 3.6 flash воспроизвёл около 62% при фиксированном промпте и до 70% при изменении промпта и точки входа, при этом на каждый коммит отводился бюджет в 25 попыток. Чтобы исключить подсказки из обучающих данных, была проведена проверка контаминации: заметного запоминания багов, найденных до cutoff модели в январе 2026 года, не обнаружено — агент ищет ошибки самостоятельно, а не воспроизводит их по памяти.
Контекст
Fuzzilli представляет классический coverage-guided фаззинг: инструмент массово генерирует JavaScript-программы и ориентируется по сигналу покрытия кода, благодаря чему годами считался основным способом вылавливать специфичные ошибки JIT-компиляции в движках. BigSleep устроен иначе: это агент Project Zero на базе языковой модели, который сам решает, какие участки кода исследовать, и целенаправленно конструирует тесты вместо слепого перебора входов. Для интерпретации результатов важно именно это методологическое различие: у coverage-фаззера есть плотный градиент обратной связи, но нет понимания логики программы, у агента — наоборот, способность рассуждать о задуманном поведении кода. Сочетание массовости и целенаправленности и определяет, какие классы ошибок способен находить каждый из инструментов.
Почему это важно для индустрии
Для индустрии безопасности это первый крупный количественный замер того, насколько LLM-агенты реально конкурируют с зрелым coverage-guided фаззингом на боевом движке. Картина симметричная: агент выигрывает на сложных логических багах — например, пропуске TDZ-проверок в JIT, — где coverage-фаззер не получает награды за нужную комбинацию конструкций, но фаззер остаётся сильнее на специфичных JIT-багах. Отсюда прямой вывод для вендоров и security-команд: методы стоит запускать параллельно, а из-за малого пересечения находок дедупликация и единый триаж становятся обязательными частями такого конвейера. Сам BigSleep остаётся исследовательской системой Project Zero, а не продуктом, поэтому реалистичный ближайший шаг — офлайн-пилоты агентного анализа рядом с существующим фаззингом плюс перенос методики публикации в собственные evals: replay на исторических багах, проверка контаминации и фиксированный бюджет попыток дают честный шаблон сравнения агентов с классическими инструментами.
Почему это важно для пользователей
Для читателей, которые следят за тем, где большие языковые модели реально полезны, а где нет, замер Project Zero даёт трезвый ориентир: агентный анализ по результативности вышел на уровень зрелого специализированного инструмента, но это не история о том, что ИИ победил фаззеры, — «сложные» для фаззера баги во многом сложны и для ИИ, а пересечение находок больше на лёгких ошибках. Пользователи Chrome получают прямой, хоть и не мгновенный эффект: чем больше независимых методов охотятся за ошибками движка, тем выше шанс, что уязвимость закроют до того, как ею воспользуются злоумышленники. Тем, кто выбирает инструменты для аудита собственного кода, полезно ориентироваться на подобные замеры, а не на маркетинговые обещания.
Что пока неизвестно / ограничения
Читать «45 против 37» как рейтинг возможностей нельзя: измерение шло на одном движке и в течение полугода, а в источниках нет дисперсии между запусками и доверительных интервалов, поэтому разница в 8 багов на таком горизонте статистически неубедительна. Оценка воспроизведения чувствительна к конфигурации: расхождение между фиксированным промптом и вариацией промпта и точки входа составило около 8 процентных пунктов, так что результаты агентных пайплайнов зависят от настроек. Неизвестна и экономика внедрения — в источниках нет данных о стоимости, латентности и API агентного прогона, — а независимых репликаций на других движках вроде SpiderMonkey и JavaScriptCore или в других доменах пока нет.
Источники
- Fuzzers vs. AI: Comparing Fuzzilli and BigSleep on JavaScript Engines — Project Zero
- Fuzzers vs. AI: Comparing Fuzzilli and BigSleep on JavaScript Engines — Hacker News
Автор
Look at AI, редакция