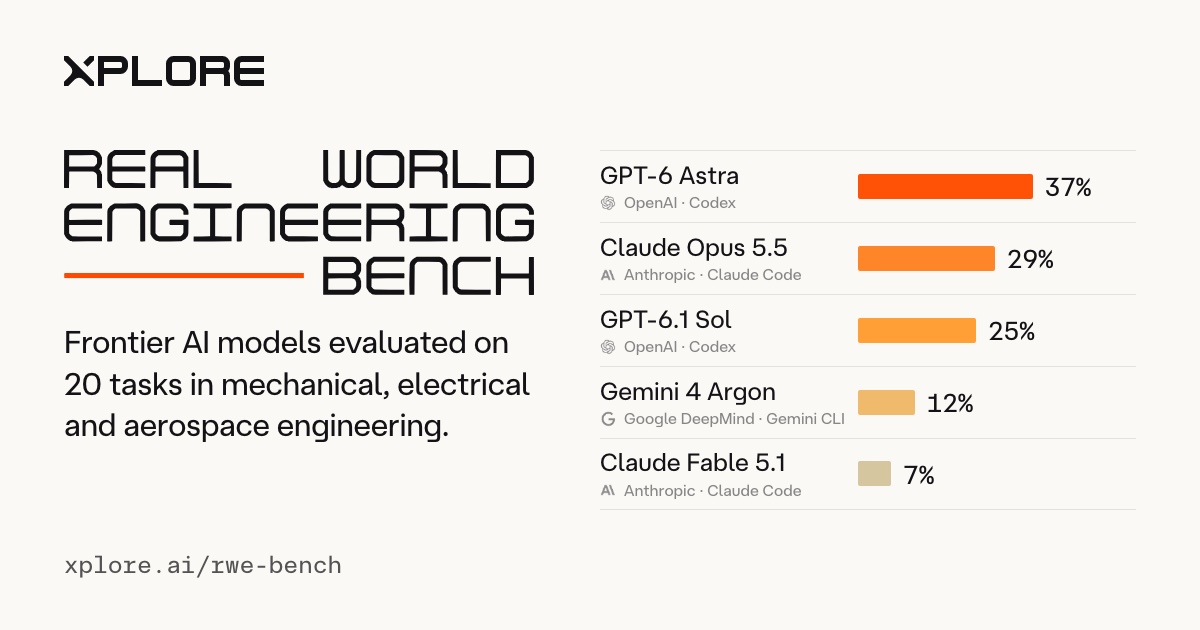
🤖 RWE-bench: проверка ИИ-моделей на реальных инженерных задачах
Стартап Xplore опубликовал закрытый бенчмарк из 20 инженерных задач: механика (9), электроника (5), авиатехника (6). Модель должна в песочнице с CadQuery, Gmsh, CalculiX и Python выдать работающую конструкцию, а проверяет её автоматический верификатор физическими решателями — без человека и LLM-судьи.
🌍 Ниша для инженеров-людей не закрыта: лучший GPT-6 Astra решает 37% задач (58,83 доллара за запуск), Claude Opus 5.5 — 29%, GPT-6.1 Sol — 25%. Четыре из 20 задач за 1100 запусков не решила ни одна из 11 моделей.
👤 «Модель проектирует как инженер» — пока маркетинг: DeepSeek V4.1 Flash и ещё четыре модели решили ноль задач. Для инженерии рациональнее по цене и качеству GPT-6.1 Sol, а проверить результаты можно на открытом EngiWorld: 1301 задача, у Claude Opus 5 — 44,7 из 100.
Источник 1: https://xplore.ai/rwe-bench Источник 2: https://engiworld.github.io/