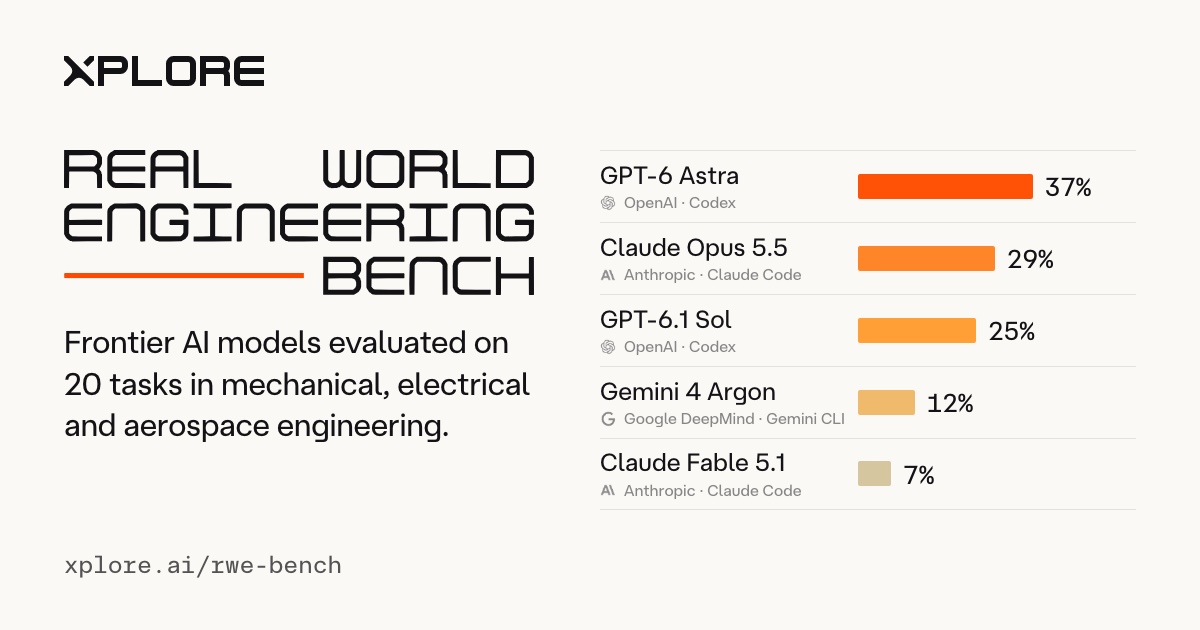
Стартап Xplore опубликовал RWE-bench (Real World Engineering Bench) — закрытый бенчмарк из 20 инженерных задач: 9 по механике, 5 по электронике и 6 по авиационной технике. Модель должна в песочнице с CadQuery, Gmsh, CalculiX и Python выдать работающую конструкцию, а не текст о ней; проверка полностью автоматическая, детерминированный верификатор пересчитывает каждое требование физическими решателями, без человека и LLM-судьи. Лучший средний результат — 37% у GPT-6 Astra при цене 58,83 доллара за запуск, а четыре задачи из двадцати за 1100 запусков не решила ни одна из одиннадцати моделей.


Что произошло
В тесте модели работают как инженеры: нужно спроектировать цельный коленчатый вал трёхцилиндрового дизеля на 2400 об/мин, развести 32-разрядную шину DDR3L от Zynq-7000 на восьмислойной плате или выполнить CFD-расчёт обтекания лопатки турбины. Верификатор проверяет не текст, а саму конструкцию: пересчитываются напряжения, жёсткость, допуски рассинхронизации и сходимость CFD, причём ошибка по единственному параметру означает незачёт задачи. Всего за 1100 запусков 11 моделей показали следующую картину: GPT-6 Astra — 37% при 58,83 доллара за запуск, Claude Opus 5.5 — 29% при 57,52 доллара, GPT-6.1 Sol — 25% при 10,28 доллара. Нижнюю часть списка занимают DeepSeek V4.1 Flash, Qwen3.8 Max, GLM-5.3, Muse Wonder и Grok 4.7 — у них не засчитано ни одной задачи.
Контекст
Ключевая идея методологии — убрать LLM-судью из оценки. Физический решатель выдаёт детерминированный бинарный вердикт по каждому требованию, что устраняет субъективность и подсказывание, характерные для суда языковой моделью, и делает сравнения воспроизводимыми. Сам RWE-bench при этом закрыт: задачи не передаются для обучения, а тестирование сторонних моделей возможно только по договорённости с Xplore. Параллельная открытая ветвь уже оформилась: команда во главе с Tsinghua выпустила бенчмарк EngiWorld на 1301 открытую задачу со статьёй arXiv:2609.37686, кодом и датасетами на Hugging Face, где зафиксирован воспроизводимый базлайн Claude Opus 5 — 44,7 из 100.
Почему это важно для индустрии
Для AI-индустрии меняется сама логика оценки и закупки: считать нужно не рейтинг моделей, а стоимость успешного прогона, потому что у инженерных задач цена ошибки измерима. GPT-6.1 Sol даёт 25% при цене в 5,7 раза ниже, чем у GPT-6 Astra, тогда как неудачный запуск топ-2 обходится в 57–59 долларов. Продукты на инженерных агентах сегодня жизнеспособны не вокруг «умной модели», а вокруг детерминированной проверки: физический решатель в роли верификатора превращает ненадёжный вывод LLM в цикл «спроектировал — пересчитал — поправил», и такой результат уже можно продавать как «принятый верификатором». В горизонте полугода этот паттерн, скорее всего, тиражируется: ожидаются бенчмарки-последователи в других инженерных доменах, плагины физических решателей к агентским фреймворкам и оптимизация агентов вендорами под симуляторные проверки. Автономная автоматизация при этом пока не наступила, поэтому пилоты «полностью автоматической инженерии» разумно переупаковывать в процессы human-in-the-loop, где агент генерирует и перебирает варианты, а решение и ответственность за допуск остаются за инженером. Через два года по этим данным реалистичнее не вытеснение инженеров, а автоматизация рутины между ними: генерации первых вариантов конструкций, разводки типовых узлов и прогонов параметрических свипов.
Почему это важно для пользователей
Практический вывод для читателя, который выбирает модель под инженерные задачи: оптимум по цене и качеству сейчас у GPT-6.1 Sol — 25% решённых задач за 10,28 доллара за запуск, а не у флагманов, где попытка стоит выше 57 долларов. Дешёвые универсальные модели в этом узком домене пока бесполезны: DeepSeek V4.1 Flash за 1,03 доллара за запуск не приносит ни одного засчитанного решения, то есть экономия на модели напрямую превращается в ноль результата. Формулу «модель проектирует как инженер» пока корректно считать маркетингом: даже лучший агент проходит меньше половины заданий. Пользу можно извлечь уже сегодня без доступа к закрытому бенчмарку: открытый стек (CadQuery, Gmsh, CalculiX, Python) и открытый EngiWorld с кодом и датасетами на Hugging Face позволяют собрать автоматическую проверку конструкции на допуски до передачи работы человеку.
Что пока неизвестно / ограничения
Главные ограничения связаны с дизайном бенчмарка. Выборка всего в 20 задач с ручным отбором: разрыв между 37% у GPT-6 Astra и 29% у Claude Opus 5.5 — это разница в несколько задач, и без per-task разбивки с доверительными интервалами по 1100 запускам ранжирование топ-3 статистически неустойчиво. Авторами задач выступают сами инженеры Xplore, которые продают тренировочные среды на основе этих же задач, а набор закрыт для независимого аудита, поэтому риск предвзятого отбора исключить нельзя. Наконец, выводы о тиражировании методологии и сдвиге к гибридным процессам в горизонте полугода и двух лет — это прогнозы, которые нужно проверять новыми измерениями, а не установленные факты.
Источники
- RWE-bench: Real World Engineering Benchmark — Xplore
- EngiWorld — Professional Engineering Agent Benchmark (Tsinghua-led team)
- EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments? (arXiv:2609.37686)
Автор
Look at AI, редакция