🤖 Stanford Hazy Research: генерация текста в 21 раз быстрее диффузии
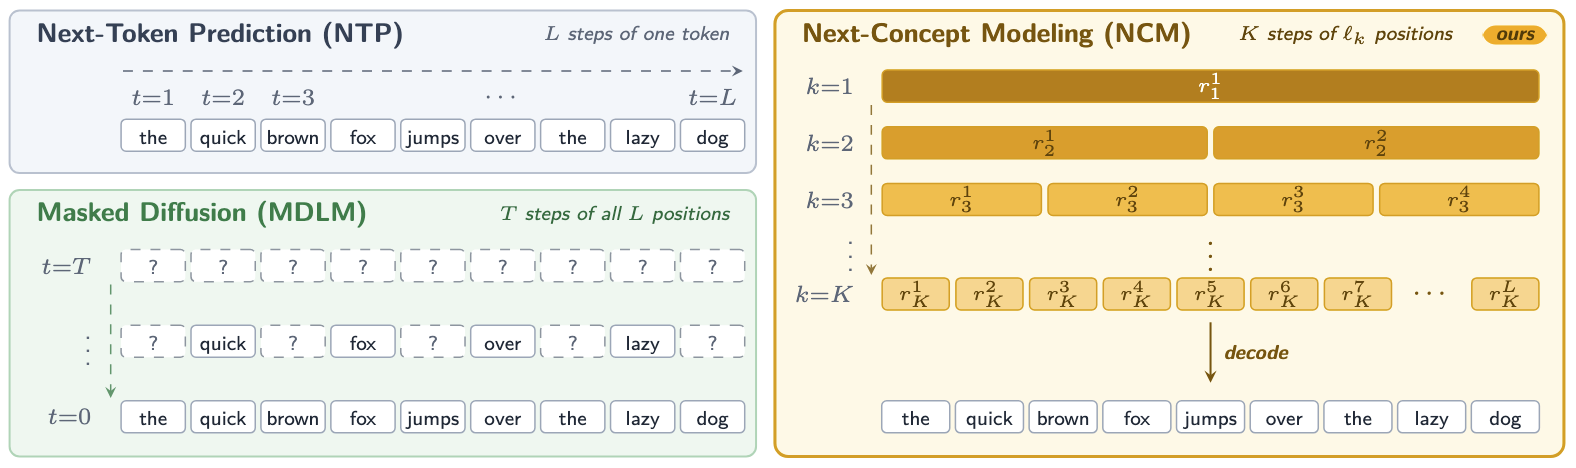
Команда Stanford Hazy Research представила неавторегрессивный фреймворк Next-Concept Modeling (NCM): модель строит иерархию дискретных кодов от грубых «концептов» к деталям и предсказывает все коды уровня параллельно.
🌍 Третий путь между авторегрессией и диффузионными LM: на одном NVIDIA H100 NCM генерирует в 10–31 раз быстрее диффузионных базовых линий (на LM1B — в 21 раз) при сопоставимом качестве, а обучение требует в 4–5 раз меньше токенов. Инференс — ключевой растущий расход LLM-сервисов — дешевеет.
👤 Проверяемо на одном H100: код под MIT, веса и датасеты (XSum, WMT14 De-En, судоку и другие) открыты на GitHub и Hugging Face. В задаче рассуждения NCM решает 99,5% лёгких и 86,1% сложных досок против 14,6% и 1% у авторегрессивных моделей.
Источник 1: https://hazyresearch.stanford.edu/blog/2026-10-12-ncm Источник 2: https://arxiv.org/abs/2610.14162