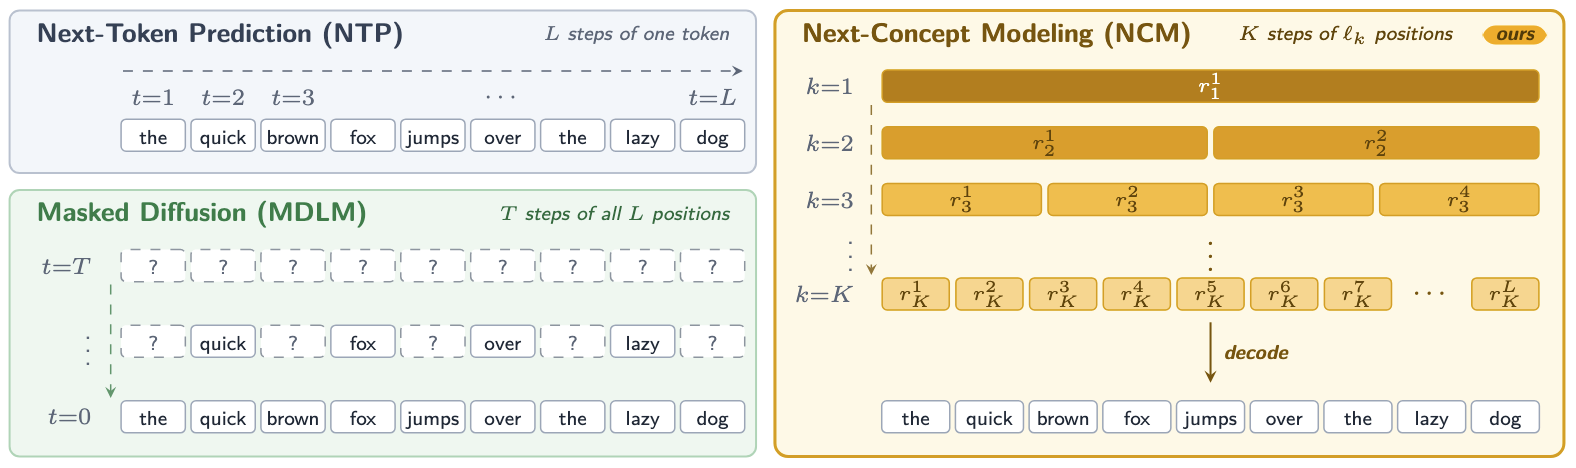
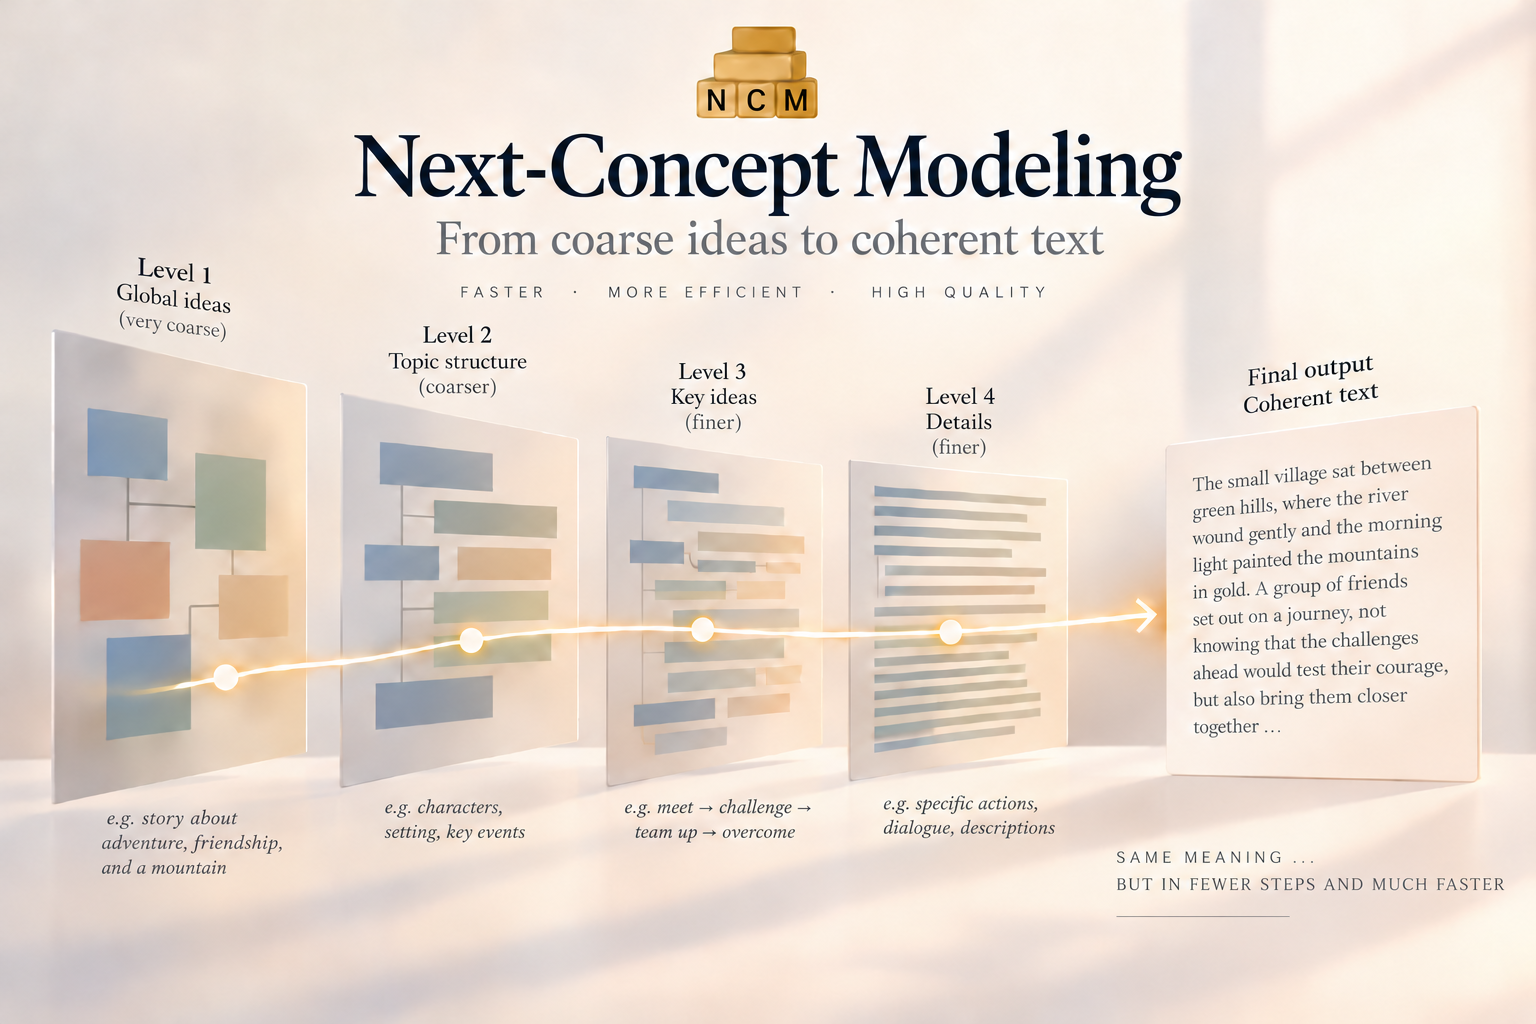
Исследователи Stanford Hazy Research — Hermann Kumbong, Ishan S. Khare, Simran Arora, Azalia Mirhoseini и Christopher Ré — представили Next-Concept Modeling (NCM), неавторегрессивный фреймворк генерации текста. Модель пишет текст от грубых «концептов» к деталям, обходя иерархию дискретных кодов, вместо пословечного развертывания, привычного для сегодняшних LLM. По опубликованным измерениям команды, на одном GPU NCM обгоняет сильнейшие диффузионные базовые линии в десятки раз, а на обучение расходует заметно меньше данных. Код, веса и датасеты выложены в открытый доступ, так что все ключевые результаты статьи можно проверить самостоятельно.


Что произошло
Работа вышла в несколько шагов: 9 октября 2026 года на arXiv появился препринт 2610.14162, 12 октября 2026 года лаборатория опубликовала разъясняющий блог-пост, а вместе с ними в открытый доступ попали код, веса и датасеты. Фреймворк построен так: текст представляется иерархией дискретных кодов, где верхние уровни кодируют крупные смысловые «концепты», а нижние — детали, и все коды одного уровня модель предсказывает сразу одним параллельным проходом трансформера. На одиночной NVIDIA H100 SXM 80GB авторы сообщают о генерации в 21 раз быстрее сильнейшей диффузионной базовой линии на LM1B с лучшим перплексити, в 10 раз быстрее на OpenWebText и в 31 раз быстрее на суммаризации XSum при сопоставимом качестве. На задаче рассуждения, судоку, NCM решает 99.5% легких, 96.5% средних и 86.1% сложных досок против 14.6, 5.1 и 1.0% у авторегрессивных моделей. Код открыт под лицензией MIT; веса задачных моделей (XSum, WMT14 De-En, судоку, LM1B, TinyStories, OpenWebText) и датасеты лежат в GitHub-репозитории HazyResearch/ncm и в коллекции на Hugging Face.
Контекст
Оценить новость проще на фоне двух действующих семейств генерации. Авторегрессивные модели пишут текст токен за токеном: каждый следующий токен требует отдельного прохода трансформера, поэтому обработка растягивается вместе с длиной ответа, а диффузионные языковые модели несколько раз перерабатывают последовательность целиком и тоже тратят множество проходов. Next-Concept Modeling занимает третью нишу между этими крайностями: генерация организована уровнями иерархии, а не токенами и не итерациями по всей последовательности. Важный фон для восприятия: ускорение генерации в этой области почти всегда покупается качеством, прежде всего перплексити, поэтому сообщенное командой сочетание скорости, качества и экономии обучающих данных выглядит редким и заслуживает внимания шире, чем очередная инженерная оптимизация.
Почему это важно для индустрии
Для AI-индустрии работа напрямую касается самой растущей статьи расходов LLM-сервисов — стоимости инференса. Генерация кодов уровнями, а не по токену за раз, сокращает число проходов трансформера на данную длину текста; если соотношение подтвердится на больших моделях, обслуживание больших объемов текста станет дешевле в пропорции, пока известной только из авторских измерений. Второе экономическое обещание — обучение: заявленное сокращение обучающего корпуса в 4–5 раз, если оно переживет масштабирование, удешевит эксперименты с новыми архитектурами и пересчитает бюджеты крупных проектов. Проверкой обоих обещаний станет масштабирование: сравнения NCM в диапазоне 1–10B с оптимизированной авторегрессией при равном compute покажут, жизнеспособно ли направление для сервисной генерации. До тех пор изменение продуктовых стеков не идет: публичных API и прайсинга нет, а открытые веса покрывают небольшие задачные модели, а не универсального ассистента. В ближайшие месяцы логично ждать независимых репликаций на открытых весах и follow-up работ, а на дистанции двух лет возможна вилка сценариев: в оптимистичной ветке иерархическая coarse-to-fine генерация становится третьим стандартным семейством инференса для задач с регулярной структурой — суммаризации, перевода, задач с проверяемым решением, в пессимистичной метод остается исследовательской новинкой.
Почему это важно для пользователей
Для читателя главный практический эффект сейчас — проверяемость: публикация снабжена открытым кодом, весами и датасетами, и, по расчетам авторов, вся проверка укладывается в одну GPU NVIDIA H100, что редкий уровень прозрачности для совсем свежей архитектуры. Инженер с такой картой может воспроизвести заявленные ускорения и уже сегодня собрать демо быстрой суммаризации или черновик-генератора, правда, всю интеграционную обвязку придется написать самому: hosted-доступа и готовых подключений к популярным стекам в материалах не представлено. Читателю без собственной H100 остается следить за репликациями: если независимые проверки подтвердят цифры на больших моделях, первым ощутимым эффектом станут более быстрые и дешевые пакетные сервисы вроде массовой суммаризации или заготовки черновиков, а позже, потенциально, и более отзывчивые ассистенты.
Что пока неизвестно / ограничения
Осторожности требуют несколько обстоятельств. Доказательная база построена на малых корпусах (LM1B, OpenWebText, XSum, TinyStories) и специализированных задачах (судоку, WMT14 De-En), поэтому распространять выводы на большие модели, длинные контексты и боевой продакшн пока нет оснований; данные о latency и throughput реального обслуживания также не опубликованы. Далее, заявленное ускорение измерено против диффузионных базовых линий, а прямого сопоставления с оптимизированной авторегрессивной генерацией в материалах нет, так что называть NCM быстрым относительно привычных LLM-сервисов из этих цифр нельзя. Судоку — задача с единственным решением и детерминированной проверкой, и результат на ней не доказывает способность рассуждать в свободной форме, например в математике или программировании. Наконец, независимых репликаций и заметного отклика комьюнити пока практически нет, поэтому все ключевые цифры остаются авторскими заявлениями до независимой проверки, и уверенность в них стоит держать умеренной.
Источники
- Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation — блог Stanford Hazy Research
- Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation (статья arXiv:2610.14162)
- GitHub-репозиторий HazyResearch/ncm — код, веса и датасеты NCM
Автор
Look at AI, редакция