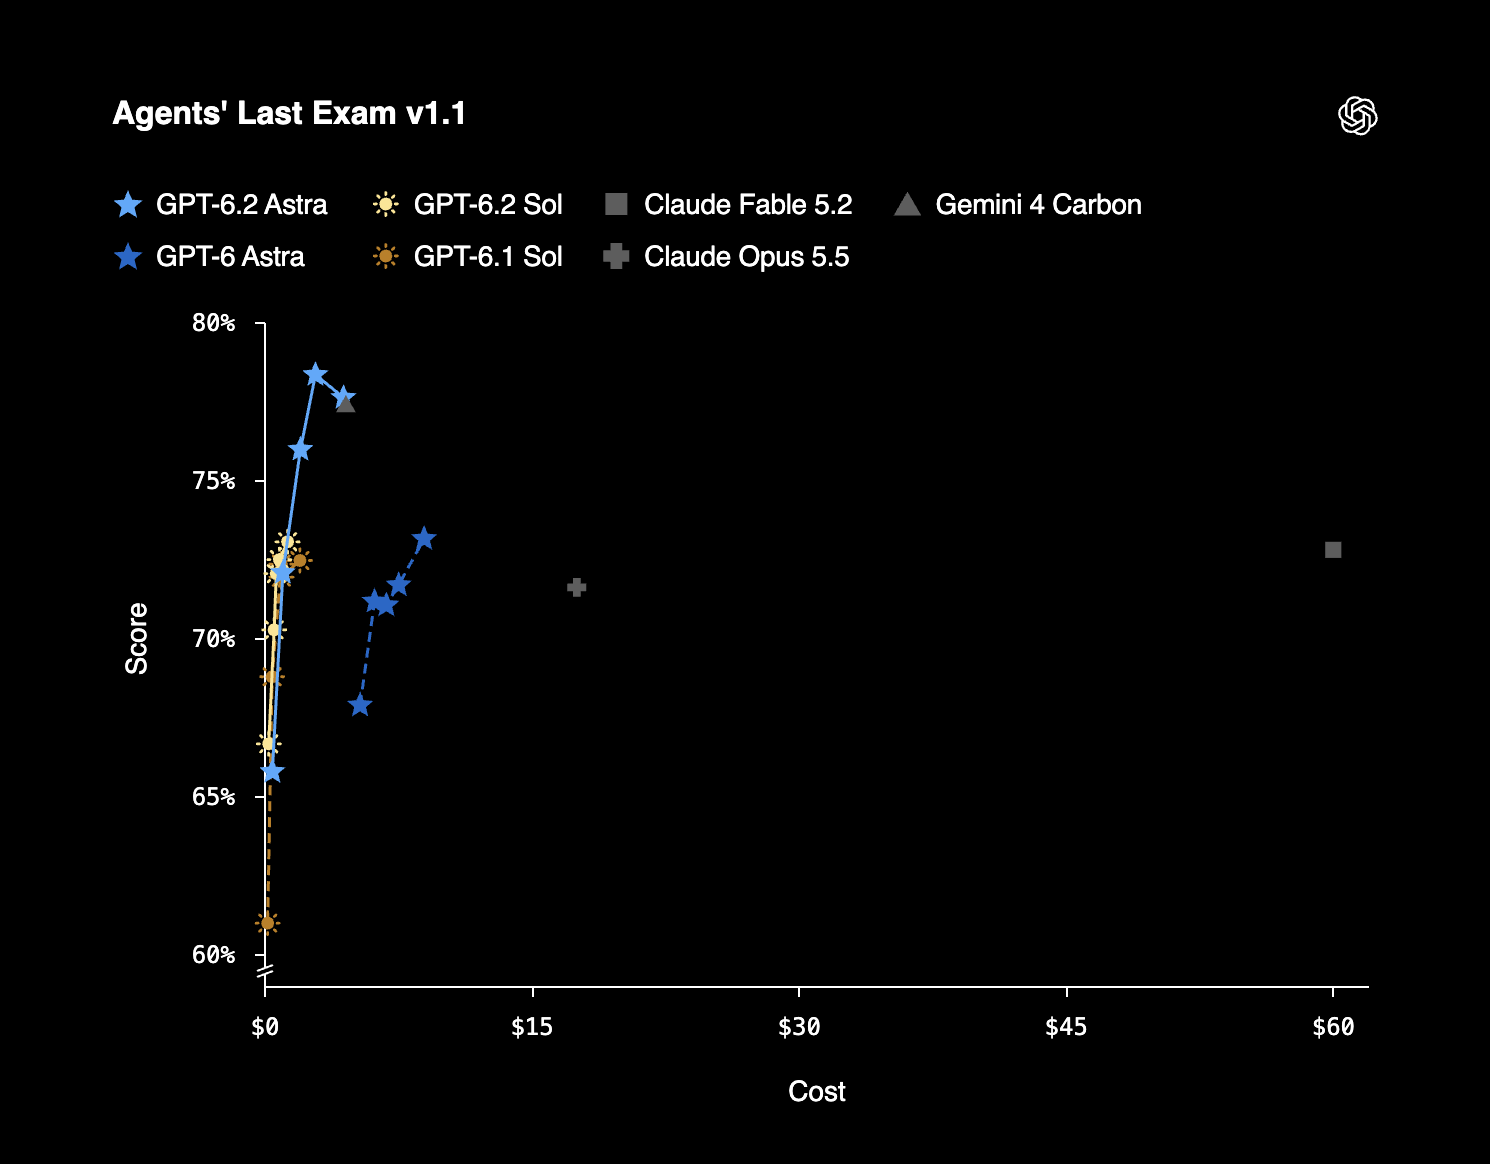
OpenAI 17 ноября 2026 года выпустила сразу две модели: фронтир-модель GPT-6.2 Astra для сложных задач и GPT-6.2 Sol для повседневной рутины. Входные токены у Astra подешевели на 20%, до $8 за миллион, выходные стоят $40; кэш подешевел на 60%, а срок его жизни больше не ограничен. Sol осталась на прежнем тарифе $2/$10 за миллион токенов, где первая цифра — вход, вторая — выход. Обе модели уже работают в ChatGPT Work, Codex и API, поэтому экономию и качество можно проверить на собственных задачах в тот же день, однако ключевые цифры качества пока опираются на вендорские бенчмарки и ждут независимой проверки.


Что произошло
17 ноября 2026 года OpenAI выпустила две модели линейки GPT-6.2: Astra и Sol. Astra адресована сложным сценариям — коду, работе с документами, 3D и кибербезопасности; её тариф $8 за миллион входных и $40 за миллион выходных токенов на 20% дешевле предшественницы GPT-6 Astra. Стоимость кэша снижена на 60%, а его срок жизни стал неограниченным. Sol ориентирована на повседневные задачи и сохранила прежний тариф $2/$10 за миллион токенов без изменения цены. Обе модели уже доступны в ChatGPT Work, Codex и API для подписчиков Plus, Pro, Enterprise и Edu, а режим Ultrafast, прежде закреплённый только за тарифом Pro 500, распространён на Pro 200. По вендорским данным, Astra прибавила 22 пункта на бенчмарке ExploitBench Internal Port в кибербезопасности и 5,2 пункта на Agents' Last Exam; одновременно опубликована карточка модели GPT-6.2 Astra & Sol System Card на портале OpenAI Deployment Safety Hub.
Контекст
GPT-6.2 — не смена поколения, а инкрементальная итерация внутри линейки GPT-6.x, и расценивать её как научный прорыв нет оснований: ядро релиза лежит в экономике, а не в новых способностях. OpenAI снижает цену доступа к фронтир-интеллекту и переводит кэш из служебной технической опции в первоклассный механизм тарификации, от которого теперь зависит стоимость длинных сессий. Действует и конкурентное давление: на рынке уже работают Anthropic с Claude 5.2 и Google с Gemini 4, а в сравнительных материалах самой OpenAI модель Gemini Carbon на приватном бенчмарке GDPval v2 выглядит дешевле и качественнее, чем Opus и Fable. Прежний перевес OpenAI по сочетанию цены и качества, таким образом, перестал быть самоочевидным, и удешевление Astra логично рассматривать как ответ на этот сдвиг, а не как жест щедрости. Ещё одна деталь, которую нужно держать в голове при чтении цифр релиза: значимые сравнения проходят на бенчмарках, контролируемых самим вендором, включая приватный GDPval v2, поэтому к заявленным приростам разумно сразу прикладывать методологический скепсис.
Почему это важно для индустрии
Для индустрии смысл релиза в юнит-экономике, а не в скачке способностей. Дешевле всего он бьёт по сценариям с длинными сессиями: агентные пайплайны, coding-ассистенты и RAG-приложения с активным переиспользованием контекста получают двойное снижение — на вход и на кэш, и экономия растёт вместе с длиной рабочей сессии. Само ценообразование навязывает архитектуру: тяжёлые шаги пайплайна переводятся на Astra, рутинные остаются за Sol, и роутер с эскалацией превращается в дефолтную конструкцию агентных продуктов, при этом Astra становится кандидатом для enterprise-сценариев, где критична цена за решённую задачу, а не за токен. Ожидаемая реакция конкурентов — ответное снижение цен или новые итерации, поэтому цикл «benchmark wars» ускорится, и следить за прайсами станет важнее, чем за анонсами. Для стартапов поверх API картина двоякая: маржа тонких обёрток продолжит сжиматься, ценность смещается к оркестрации, роутингу между моделями и собственным данным, зато персистентный кэш открывает окно на переупаковку продуктов — проектная память, фоновые агенты, работающие сутками, и архитектура «длинного тёплого контекста» вместо агрессивной нарезки промптов под короткое окно. Если траектория снижения цен сохранится в следующих поколениях, стоимость единицы агентной работы упадёт на порядок, и главным ограничителем станет не цена токена, а надёжность и верификация агентов.
Почему это важно для пользователей
Для читателей всё новое доступно немедленно, без листа ожидания и миграции. Впервые расширенный на более широкий Pro-тариф ускоренный режим Ultrafast для Sol означает быструю повседневную работу для тех, у кого такого доступа раньше не было. Персистентный кэш экономит квоту в длинных сессиях: контекст больше не приходится пересобирать заново после истечения, поэтому длительные диалоги и агентные сценарии начинают стоить дешевле при том же подписочном плане. Поскольку модели уже включены в приложение и API, разумный шаг — прогнать Astra на собственных сложных задачах вроде кода, документов или 3D, Sol — на рутине, и сравнить результат не с вендорскими графиками, а со своей базовой линией. Владельцам API-проектов хватит одного вечера, чтобы перевести один длинный workflow на Astra с агрессивным переиспользованием кэша и замерить счёт до и после, оценив экономию на фактической нагрузке.
Что пока неизвестно / ограничения
Главное ограничение касается качества. Прирост на кибербенчмарке получен на наборе ExploitBench Internal Port с пометкой Internal, который не воспроизводится вне OpenAI, поэтому 22 пункта пока остаются вендорским заявлением, подлежащим проверке, а не установленным фактом; 5,2 пункта на Agents' Last Exam — скромный инкремент, а не прорыв в оценках. Приватный GDPval v2 принадлежит самой OpenAI, и модели обычно подгоняются под такие наборы, поэтому информативнее будут не абсолютные победы, а сравнение с предшественниками Sol 6.1 и Astra 6, а также независимые репликации на внешних датасетах — их стоит ожидать в ближайшие месяцы, как и ценовое движение со стороны Anthropic и Google. Формулировка «лучшая модель для ученых» остаётся обещанием до третьесторонней проверки. Наконец, фактические цифры latency и реальный кэш-эффект на конкретных типах трафика в открытых материалах не подтверждены, поэтому командам следует проверять эти параметры замерами на собственных сценариях.
Источники
- GPT-6.2 Astra and Sol are now available — OpenAI Developer Community
- GPT-6.2 Astra & Sol System Card — OpenAI Deployment Safety Hub
Автор
Look at AI, редакция