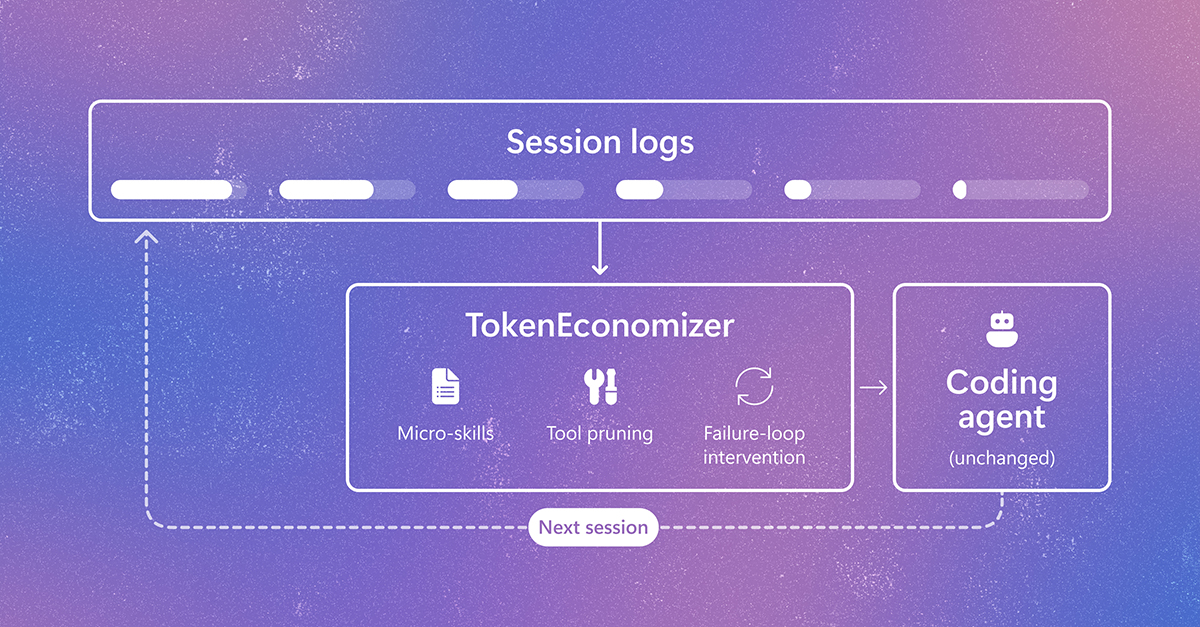
Microsoft Research совместно с UC Berkeley, Microsoft Security и Voyage AI выпустила в открытый доступ TokenEconomizer — плагин, который снижает стоимость работы AI-агентов для написания кода за счёт обучения на логах прошлых сессий в том же репозитории. Плагин не вносит изменений ни в модель, ни в агента: он действует как внешний black-box контроллер, отсекающий повторяющуюся рутину. На 277 задачах SWE-Bench из шести репозиториев средняя экономия составила 18,4–30,9% при том, что Pass@1 сохранился или вырос в четырёх из пяти комбинаций агентов и моделей. Код опубликован в репозитории microsoft/TokenEconomizer на GitHub.


Что произошло
Исследователи Microsoft Research при участии UC Berkeley, Microsoft Security и Voyage AI представили открытый плагин TokenEconomizer, который подключается поверх готовых агентов программирования, включая Claude Code, и управляет их расходами без дообучения и без замены модели. Контроллер работает через три механизма: micro-skills добавляет в стартовый контекст однострочные заметки о накопленном опыте работы с репозиторием, tool pruning отключает инструменты, которые агент в этом репозитории почти не использует, а failure-loop intervention распознаёт циклы повторных ошибок и прерывает их подсказкой судейской модели. Оценка проведена на 277 реальных задачах SWE-Bench из шести репозиториев в пяти комбинациях агентов и моделей: средняя экономия стоимости составила 18,4–30,9%, а Pass@1 сохранился или вырос в четырёх комбинациях из пяти. Экономия подтвердилась и на независимом наборе Web-Bench. Материалы исследования включают публикацию на портале Microsoft Research и открытую реализацию в репозитории microsoft/TokenEconomizer.
Контекст
Мотивация работы подробно описана в самой диагностике, выполненной командой: они профилировали Claude Code на 60 задачах SWE-Bench и выявили характерный рисунок потерь. Оказалось, что после пяти завершённых задач в одном репозитории 30% вызовов инструментов дублируют действия из прошлых задач того же репозитория, из 23 описаний инструментов, передаваемых агенту за один ход, 16 никогда не вызываются, а 17% провальных задач потребляют 32% всех расходов. Это картина типичного агентного пайплайна: каждая новая сессия решает задачу как будто с чистого листа, заново прощупывает репозиторий, перебирает инструменты и повторяет неудачные попытки, которые остаются главным пожирателем бюджета. Стандартные способы снизить расходы — переход на более дешёвую модель или ручная настройка промптов — либо угрожают качеству, либо требуют постоянного присмотра. Предложенный подход стоит на другой опоре: это репозиторий-специфичный опытный слой (experience layer) поверх существующих агентов, который управляет рутиной на уровне сессий, пока сама модель занимается задачей.
Почему это важно для индустрии
Для AI-индустрии это прежде всего переоценка того, куда реально уходит бюджет агентных продуктов: значительная часть расходов — не «интеллект», а повторяющаяся рутина, которой можно управлять отдельным контуром оркестрации, не меняя модель и не переписывая существующий стек. Для команд, разворачивающих агентные флоты в production, это напрямую касается юнит-экономики: стоимость завершённой задачи становится управляемой переменной наряду с выбором модели, причём без потери качества решения в проверенных конфигурациях. Внедрение выглядит низкорисковым: поверх действующего агента подключается внешний контроллер, откат на прежнюю схему тривиален, а открытый код позволяет проверить механику до пилота. Авторы фактически описывают новый класс продукта — репозиторий-специфичный опытный слой (experience layer) поверх готовых агентов; если результаты подтвердятся на независимых замерах, такие слои могут стать штатными компонентами агентных платформ, а накопленный по репозиторию опыт — переносимым активом между агентами и моделями.
Почему это важно для пользователей
Практическая польза касается тех, кто работает с агентами вроде Claude Code в постоянных репозиториях. Плагин ставится рядом с существующим агентом без отдельного API-ключа и без смены модели, сам учится на логах ваших сессий, а обучающие данные остаются локально. Экономия достигается без ручного тюнинга промптов, но она не мгновенная: кумулятивные затраты опускаются ниже базового уровня лишь примерно к шестой задаче в репозитории. Поэтому реальная выгода ожидается в проектах, где задачи идут потоком по одной и той же кодовой базе, а на разовых задачах и в незнакомых репозиториях выигрыш скромнее средних результатов по SWE-Bench. Разумная стратегия — теневой пилот на одном активном репозитории с замером стоимости, Pass@1 и латентности до и после подключения, закладывая экономию ближе к нижней границе, пока репозиторий не накопил опыт.
Что пока неизвестно / ограничения
Результаты получены силами самой команды разработки, и независимых воспроизведений пока нет. Ожидать единый диапазон средней экономии во всех сценариях нельзя: на задачах security-аудита в новых репозиториях он составил 6,4–19,6%, на Web-Bench — 16,0–21,2%, то есть выигрыш заметно зависит от того, насколько знакома агенту кодовая база и каков тип задач. В одной из пяти комбинаций агентов и моделей Pass@1 не сохранился, а материалы не раскрывают, о какой комбинации идёт речь и почему; границы применимости по типу модели и агента также не описаны. Репрезентативность шести выбранных репозиториев для отрасли в целом остаётся открытым вопросом. Кроме того, метод принципиально зависит от накопления опыта внутри одного репозитория: на одноразовых задачах и в незнакомых кодовых базах окупаемость наступает медленно или не наступает вовсе.
Источники
- Microsoft Research Blog — TokenEconomizer: Learning from Experience to Make AI Coding Agents More Efficient
- GitHub — microsoft/TokenEconomizer
- Microsoft Research Publication — TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents
- Hacker News — обсуждение TokenEconomizer
Автор
Look at AI, редакция