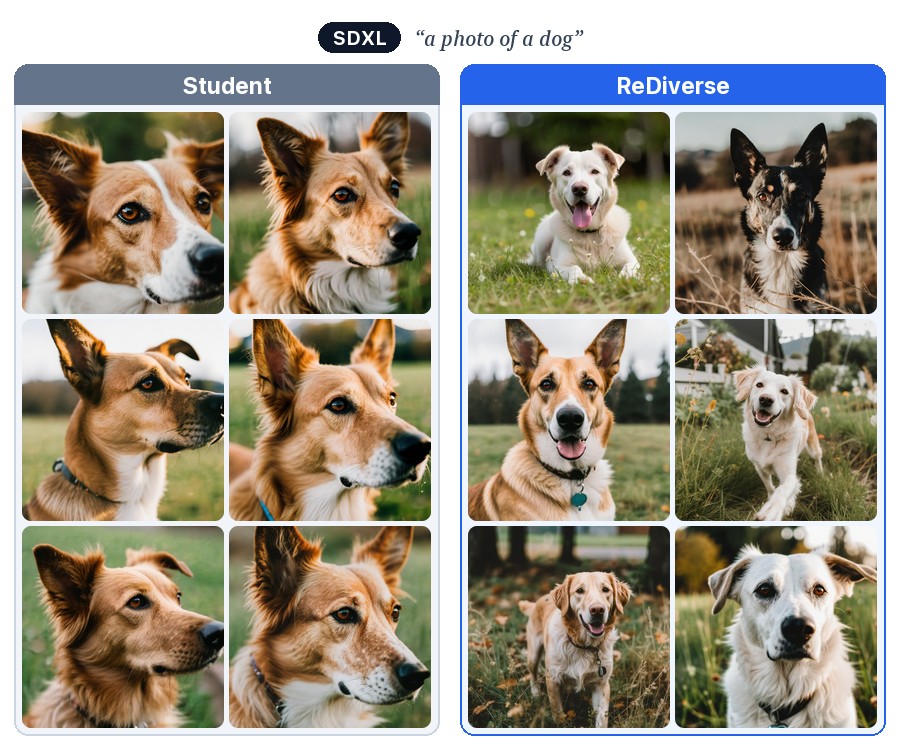
Исследователи из UIUC, fal и Johns Hopkins опубликовали препринт ReDiverse (arXiv:2611.18550): малошаговая дистилляция не теряет способность к вариативности, а сжимает дисперсию активаций в малое число направлений, из-за чего разные сиды дают почти одинаковые изображения и клипы. Сбой локализован в одном промежуточном блоке на первом шаге денойзинга, поэтому чинится точечно — лёгкий LoRA rank 32 только на первом шаге или вовсе без обучения. На SDXL, SD3, Wan 2.1 и MiniMax-H3 при тех же четырёх шагах разнообразие по DINO возвращается почти до уровня полношагового учителя, адаптеры на 216–612 МБ уже выложены на Hugging Face, код открыт. Для всех, кто использует быстрые дистиллированные генераторы, коллапс разнообразия превращается из скрытого ограничения в исправимую настройку.


Что произошло
13 ноября 2026 года команда из UIUC, fal и Johns Hopkins — Furkan Horoz, Ozgur Kara, Kaan Oktay, Adil Kaan Akan, Atakan Kara, Anand Bhattad и James Matthew Rehg — выложила препринт ReDiverse (arXiv:2611.18550). Авторы зондировали активации дистиллированных генераторов и получили однозначную картину: ученик сохраняет общий уровень дисперсии учителя, но ужимает её в заметно меньшее число направлений, а сам эффект достигает максимума в одном промежуточном блоке на первом шаге денойзинга. Для DMD2 на SDXL participation ratio падает до 0.40 при сохранном общем variance 1.63. Предложено два исправления: ReDiverse-FT — LoRA rank 32, работающая только на первом шаге, и ReDiverse-TF — вариант без обучения, где направления возвращаются по PCA-калибровке на прогонах учителя с добавлением случайных коэффициентов вдоль главных направлений. На пяти моделях при неизменных четырёх шагах (DINO-метрика: GenEval — 553 промпта × 100 сидов, VBench — 300 промптов × 10 клипов) DINO-разнообразие выросло с 59.4 до 65.0 при учителе 66.3 на SDXL, с 48.4 до 60.1 при учителе 61.6 на SD3, с 31.6 до 52.2 при учителе 51.6 на Wan 2.1 и с 36.5 до 50.9 при учителе 52.5 на MiniMax-H3. Адаптеры и код опубликованы в открытом доступе.
Контекст
Малошаговая дистилляция — стандартный способ ускорения диффузионных моделей: рецепты вроде DMD2, TDM, lightx2v и Turbo сжимают сотни шагов учителя до четырёх-шести шагов ученика, и на этом построены десятки генераторных пайплайнов. Жалоба на то, что разные сиды дают почти одинаковые результаты, давно ходила среди тех, кто работает с быстрыми генераторами, но оставалась наблюдением без объяснения. Препринт перевёл её в измеримую плоскость: пробинг активаций и participation ratio показывают, сколько направлений дисперсии реально используется до и после дистилляции. Отсюда ключевой сдвиг в постановке проблемы: коллапс разнообразия оказался не фундаментальным пределом малошаговой генерации, а локальной ошибкой распределения в конкретном блоке, что открывает путь к точечным исправлениям вроде подключаемых адаптеров вместо переобучения всей модели.
Почему это важно для индустрии
Для команд, где 4-шаговая генерация уже работает в продакшне, это готовый ингредиент, а не исследовательская идея. Адаптеры 216–612 МБ подключаются к существующим пайплайнам SDXL (DMD2), SD3 (TDM) и Wan 2.1 (lightx2v) без смены планировщика и числа шагов и в том же инференс-бюджете, а ReDiverse-TF позволяет обойтись без единого шага обучения, хотя требует калибровочных прогонов учителя. На этом собирается конкретная продуктовая механика — выдача N действительно разных вариантов по одному промпту за тот же бюджет. Если независимые репликации подтвердят цифры, ожидаемо, что разнообразие по сид-свипам станет стандартной осью оценки дистиллированных генераторов наравне с качеством и скоростью, а восстановление направлений дисперсии начнёт встраиваться в сами рецепты дистилляции.
Почему это важно для пользователей
Если вы гоняете SDXL, SD3 или Wan 2.1 в 4–6 шагов и при смене сида получаете по сути одну и ту же картинку или клип, проблема решается за вечер: скачайте адаптер своей модели с Hugging Face (hf.co/ReDiverse) и включите его в текущий процесс, либо запустите ReDiverse-TF и обойдитесь без всякого обучения. Соответствие промпту при этом не страдает: CLIPScore остаётся в пределах 0.5 пункта от исходного ученика, а разнообразие поднимается почти до полношагового учителя. Отдельная оговорка касается MiniMax-H3 и Pika H3 Flex: их лицензия запрещает использование в ЕС, Великобритании, Южной Корее и США, поэтому для практического внедрения эти модели открыты только в юрисдикциях вне ограничений, а в остальных случаях остаются исследовательскими сценариями.
Что пока неизвестно / ограничения
Это препринт, не прошедший рецензирование, и все цифры пока не подтверждены независимыми репликациями. Качество в работе закрыто ровно двумя метриками — CLIPScore и DINO-разнообразием, — человеческих оценок в материале нет. Настораживает аномалия на Wan 2.1: исправленный ученик (52.2) обгоняет полношагового учителя (51.6), из чего следует, что метрику разнообразия, возможно, можно накачать, вариативность не тождественна качеству, и без человеческих оценок этот разрыв интерпретировать нельзя. Измерений латентности в препринте нет, поэтому влияние на реальную скорость инференса остаётся открытым вопросом, а вариант без обучения требует 25 запусков полношагового учителя для калибровки направлений — это прямой инференс-расход.
Источники
- Restoring Diversity in Distilled Image and Video Generators by Probing Activations (arXiv:2611.18550)
- GitHub: H-furkan/rediverse — код, пробы активаций и адаптеры ReDiverse-FT
- Hugging Face: ReDiverse — организация с адаптерами для SDXL, SD3, Wan 2.1, MiniMax-H3, Pika H3 Flex
Автор
Look at AI, редакция