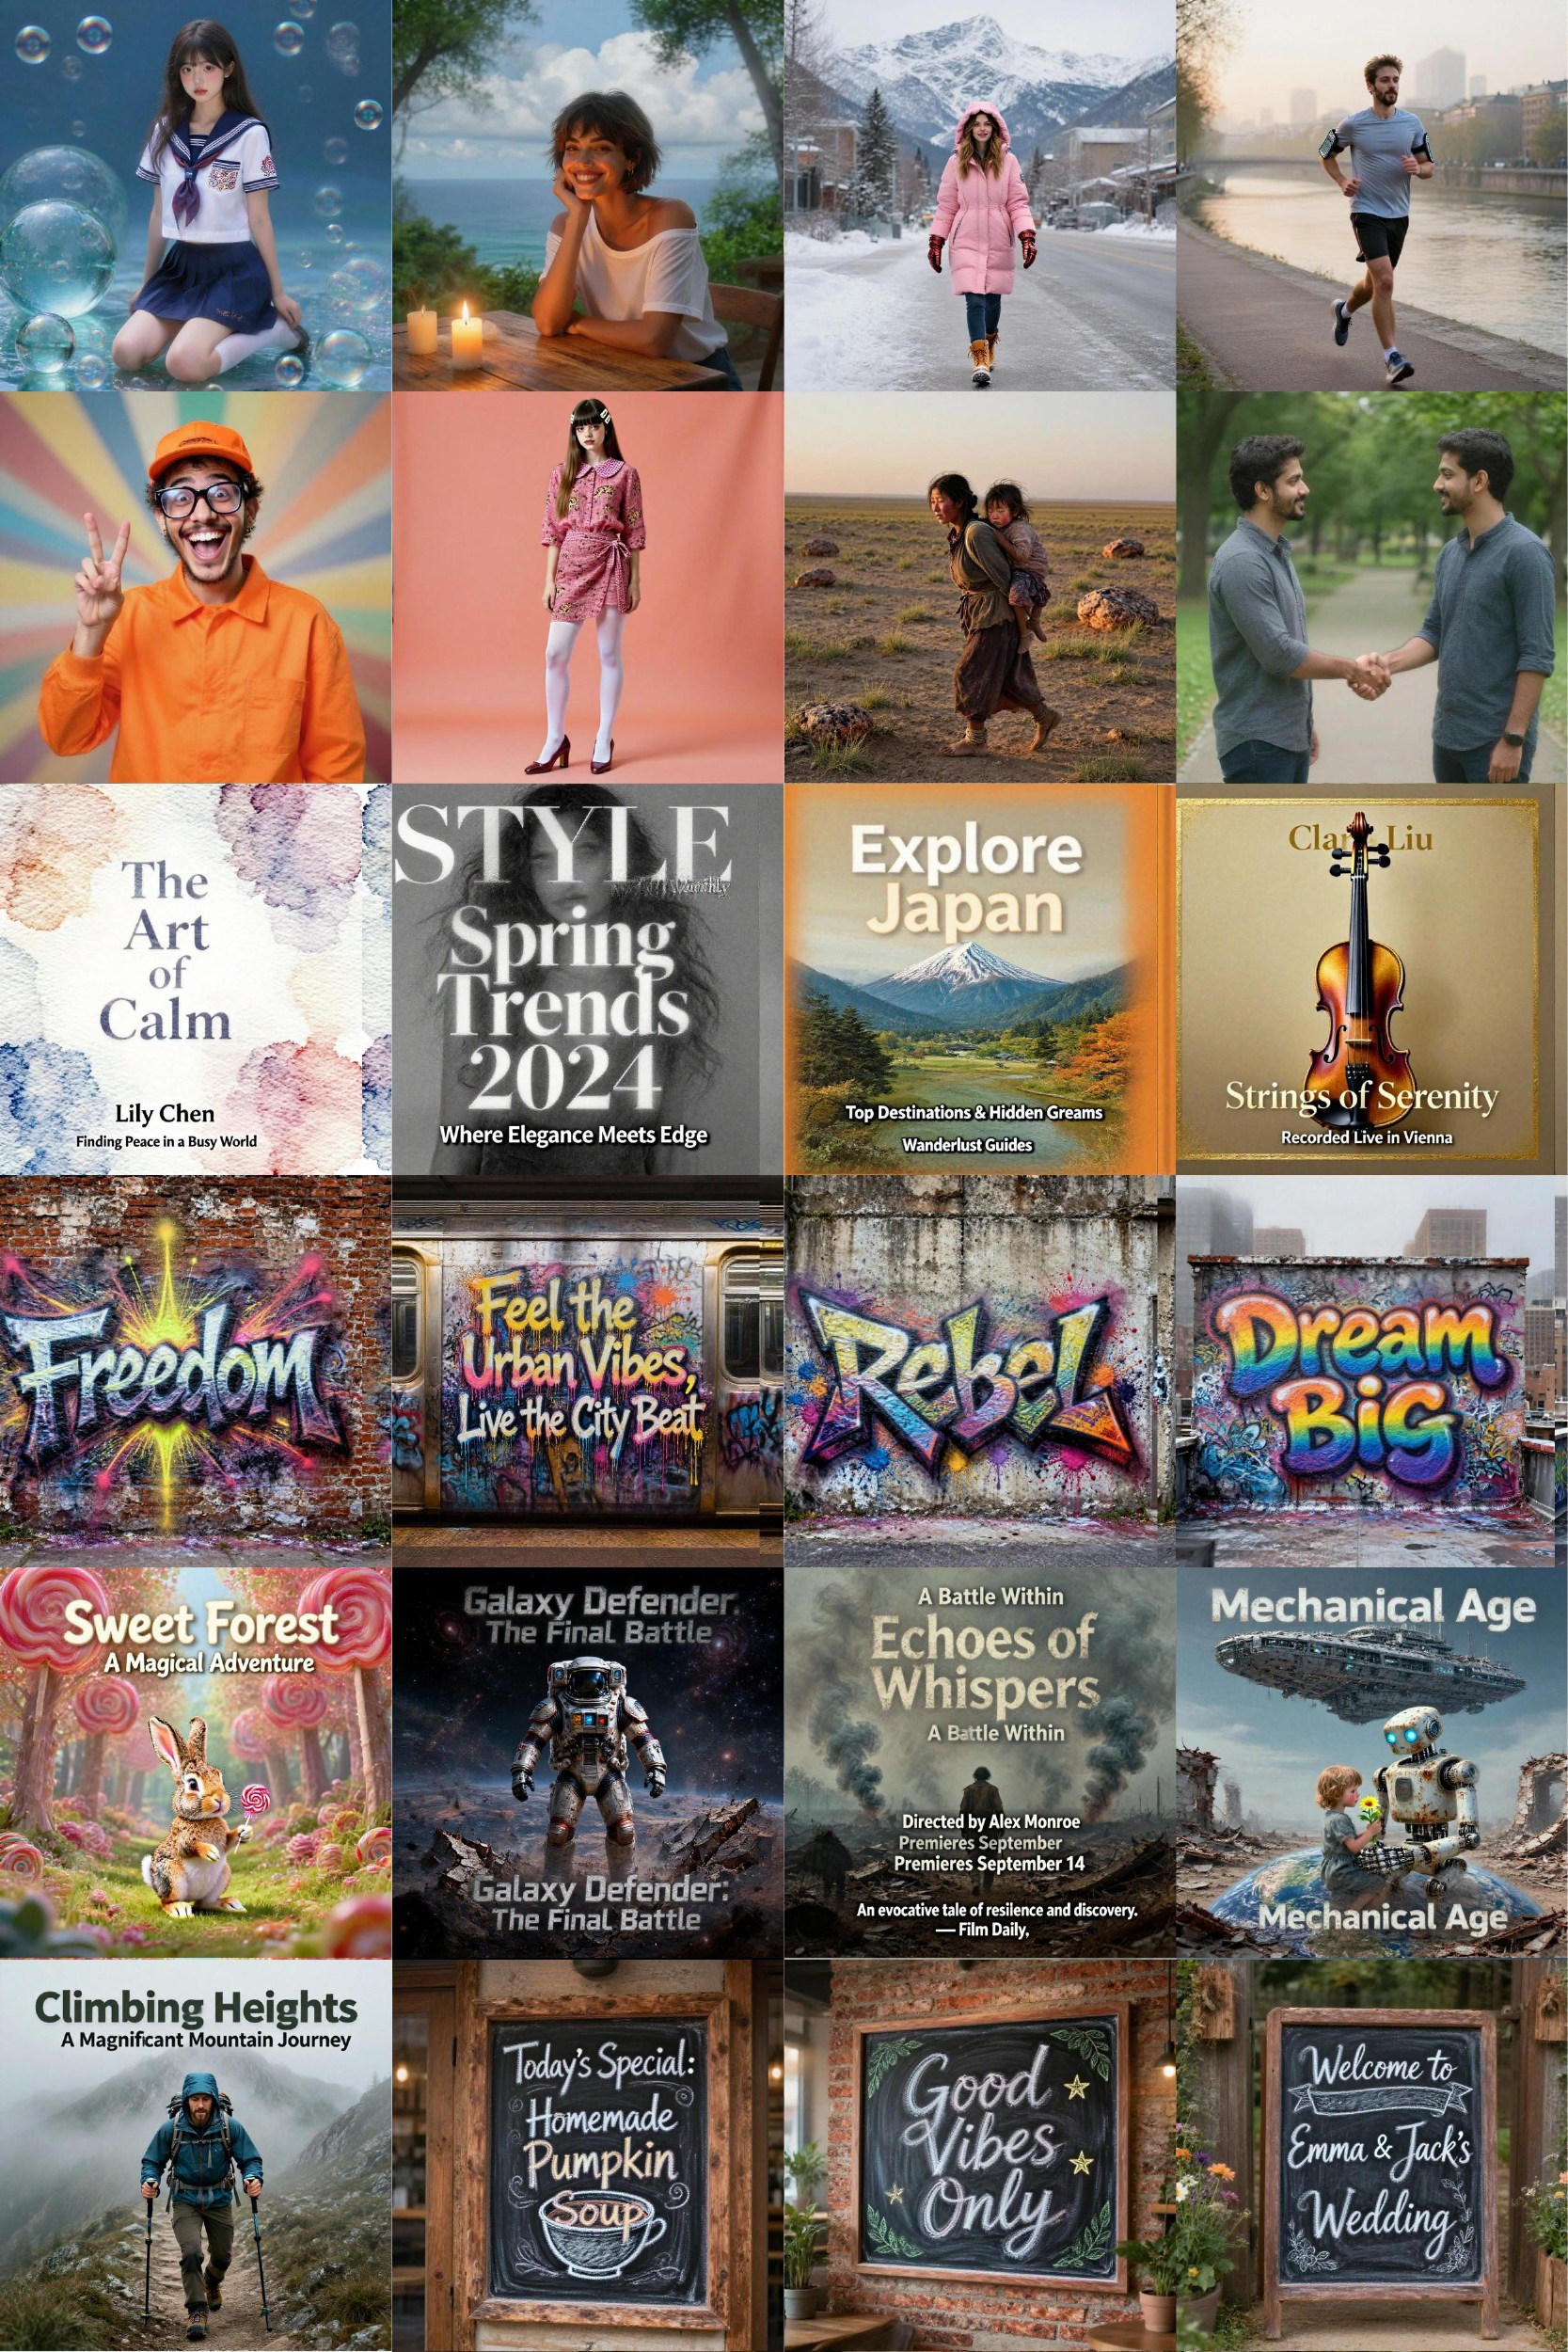
Команда Inclusion AI совместно с Westlake University, Tsinghua и другими партнёрами опубликовала метод IDM (Intrinsic Distribution Matching) для одношаговой и малошаговой генерации изображений — новую редакцию дистилляции DMD, которая не требует внешнего энкодера вроде DINOv2. Статья выложена на arXiv, официальный код открыт под лицензией Apache 2.0, а по заявлению авторов при двух шагах генерации метод сохраняет читаемый текст на изображении лучше других сравниваемых подходов на бэкбонах Z-Image-Turbo 6B и Qwen-Image 20B. Веса моделей на момент публикации не выпущены, поэтому запустить генерацию получится лишь после их релиза.


Что произошло
29 октября 2026 года на arXiv появилась статья arXiv:2610.39633 с описанием метода IDM (Intrinsic Distribution Matching), а одновременно открыт репозиторий github.com/inclusionAI/IDM под лицензией Apache 2.0 со скриптом inference.py. В сравнительной таблице авторов при 2 NFE метод обходит Z-Image-Turbo, DMD2, TwinFlow, APEX и улучшенную версию одного из собственных бэкбонов Z-Image-Turbo++, набирая 94.25% на LongText-CN и 90.20% на LongText-EN. Заявленная латентность составляет 0.25–0.30 секунды для модели 6B и 0.35–0.44 секунды для 20B на одной A100 в BF16. Метод проверен на Z-Image-Turbo 6B и Qwen-Image 20B в двух режимах: полное дообучение и LoRA.
Контекст
Подход строится поверх дистилляции DMD (Distribution Matching Distillation), которая сжимает многошаговый генератор изображений до одного–двух шагов, однако в привычных рецептах такого сжатия признаковый контроль качества опирается на отдельный внешний энкодер вроде DINOv2. IDM вместо этого согласует средние и покоординатные стандартные отклонения признаков, извлекаемых из EMA-копии самого генератора, сохраняя полную коррекцию DMD, поэтому на инференсе нужны только генератор, текстовый энкодер и VAE. Авторы проверили метод на двух бэкбонах разного масштаба, чтобы снизить риск подгонки под один конкретный чекпойнт — типичную ловушку статей по дистилляции. Заявленные скорость и сохранение текста на картинке направлены на два главных продуктовых барьера малошаговых моделей, на которые и рассчитаны использованные в статье бенчмарки генерации с длинным текстом.
Почему это важно для индустрии
Для индустрии главное следствие — упрощение пайплайна: без внешнего энкодера на инференсе остаётся меньше сетей, что сокращает набор моделей в serving и снижает его издержки. Рецепт проверен при полном дообучении и в LoRA-режиме с конфигурацией r=64, обновляющей 0.4B параметров, что делает перенос метода на сторонние чекпойнты дешёвым. Код под Apache 2.0 ускоряет коммодитизацию: это сдвиг кривой издержек, а не платформенный сдвиг, и если заявленные характеристики подтвердятся, скорость малошаговой генерации превращается из защитного барьера отдельной команды в гигиенический фактор, а дифференциация смещается к качеству и продуктовой обвязке. Если веса выйдут и самотчёты подтвердятся, IDM может стать референсным вариантом для генерации картинок с надписями за один–два шага, а сообщество быстро проверит таблицу сравнения; в перспективе рецепт со статистиками признаков из EMA-копии генератора, если он воспроизводится на других архитектурах, способен сделать малошаговую генерацию дефолтным serving-паттерном.
Почему это важно для пользователей
Читателю, которому нужны картинки с надписями — постеры, меню, обложки, — подготовиться можно уже сейчас: склонировать репозиторий github.com/inclusionAI/IDM, собрать окружение по inference.py, отладить препроцессинг, текстовый энкодер и VAE и заранее прогнать собственные сценарии проверки качества, чтобы включить генерацию в день выхода весов. Если заявленные метрики подтвердятся на практике, двухшаговая генерация с задержкой в доли секунды на одной карте подойдёт для интерактивных продуктов, где изображение появляется на глазах у пользователя, а LoRA-адаптеры позволят закрепить нужные стили и бренды.
Что пока неизвестно / ограничения
До выпуска весов IDM для Z-Image и Qwen-Image запустить генерацию невозможно: доступен только код и скрипт инференса для подготовки окружения. Представленное сравнение с пятью методами — самотчёт авторов, независимой проверки качества на сторонних стендах пока нет. Заявленная латентность — это измерение авторов на одном типе GPU, A100 в BF16, без данных о пакетной обработке и пропускной способности. Решающим будет воспроизведение метрик сообществом и подтверждение качества на новых бэкбонах.
Источники
- Intrinsic Distribution Matching (arXiv:2610.39633)
- GitHub — inclusionAI/IDM: Official code for Intrinsic Distribution Matching
- IDM — Intrinsic Distribution Matching (официальная страница проекта)
Автор
Look at AI, редакция