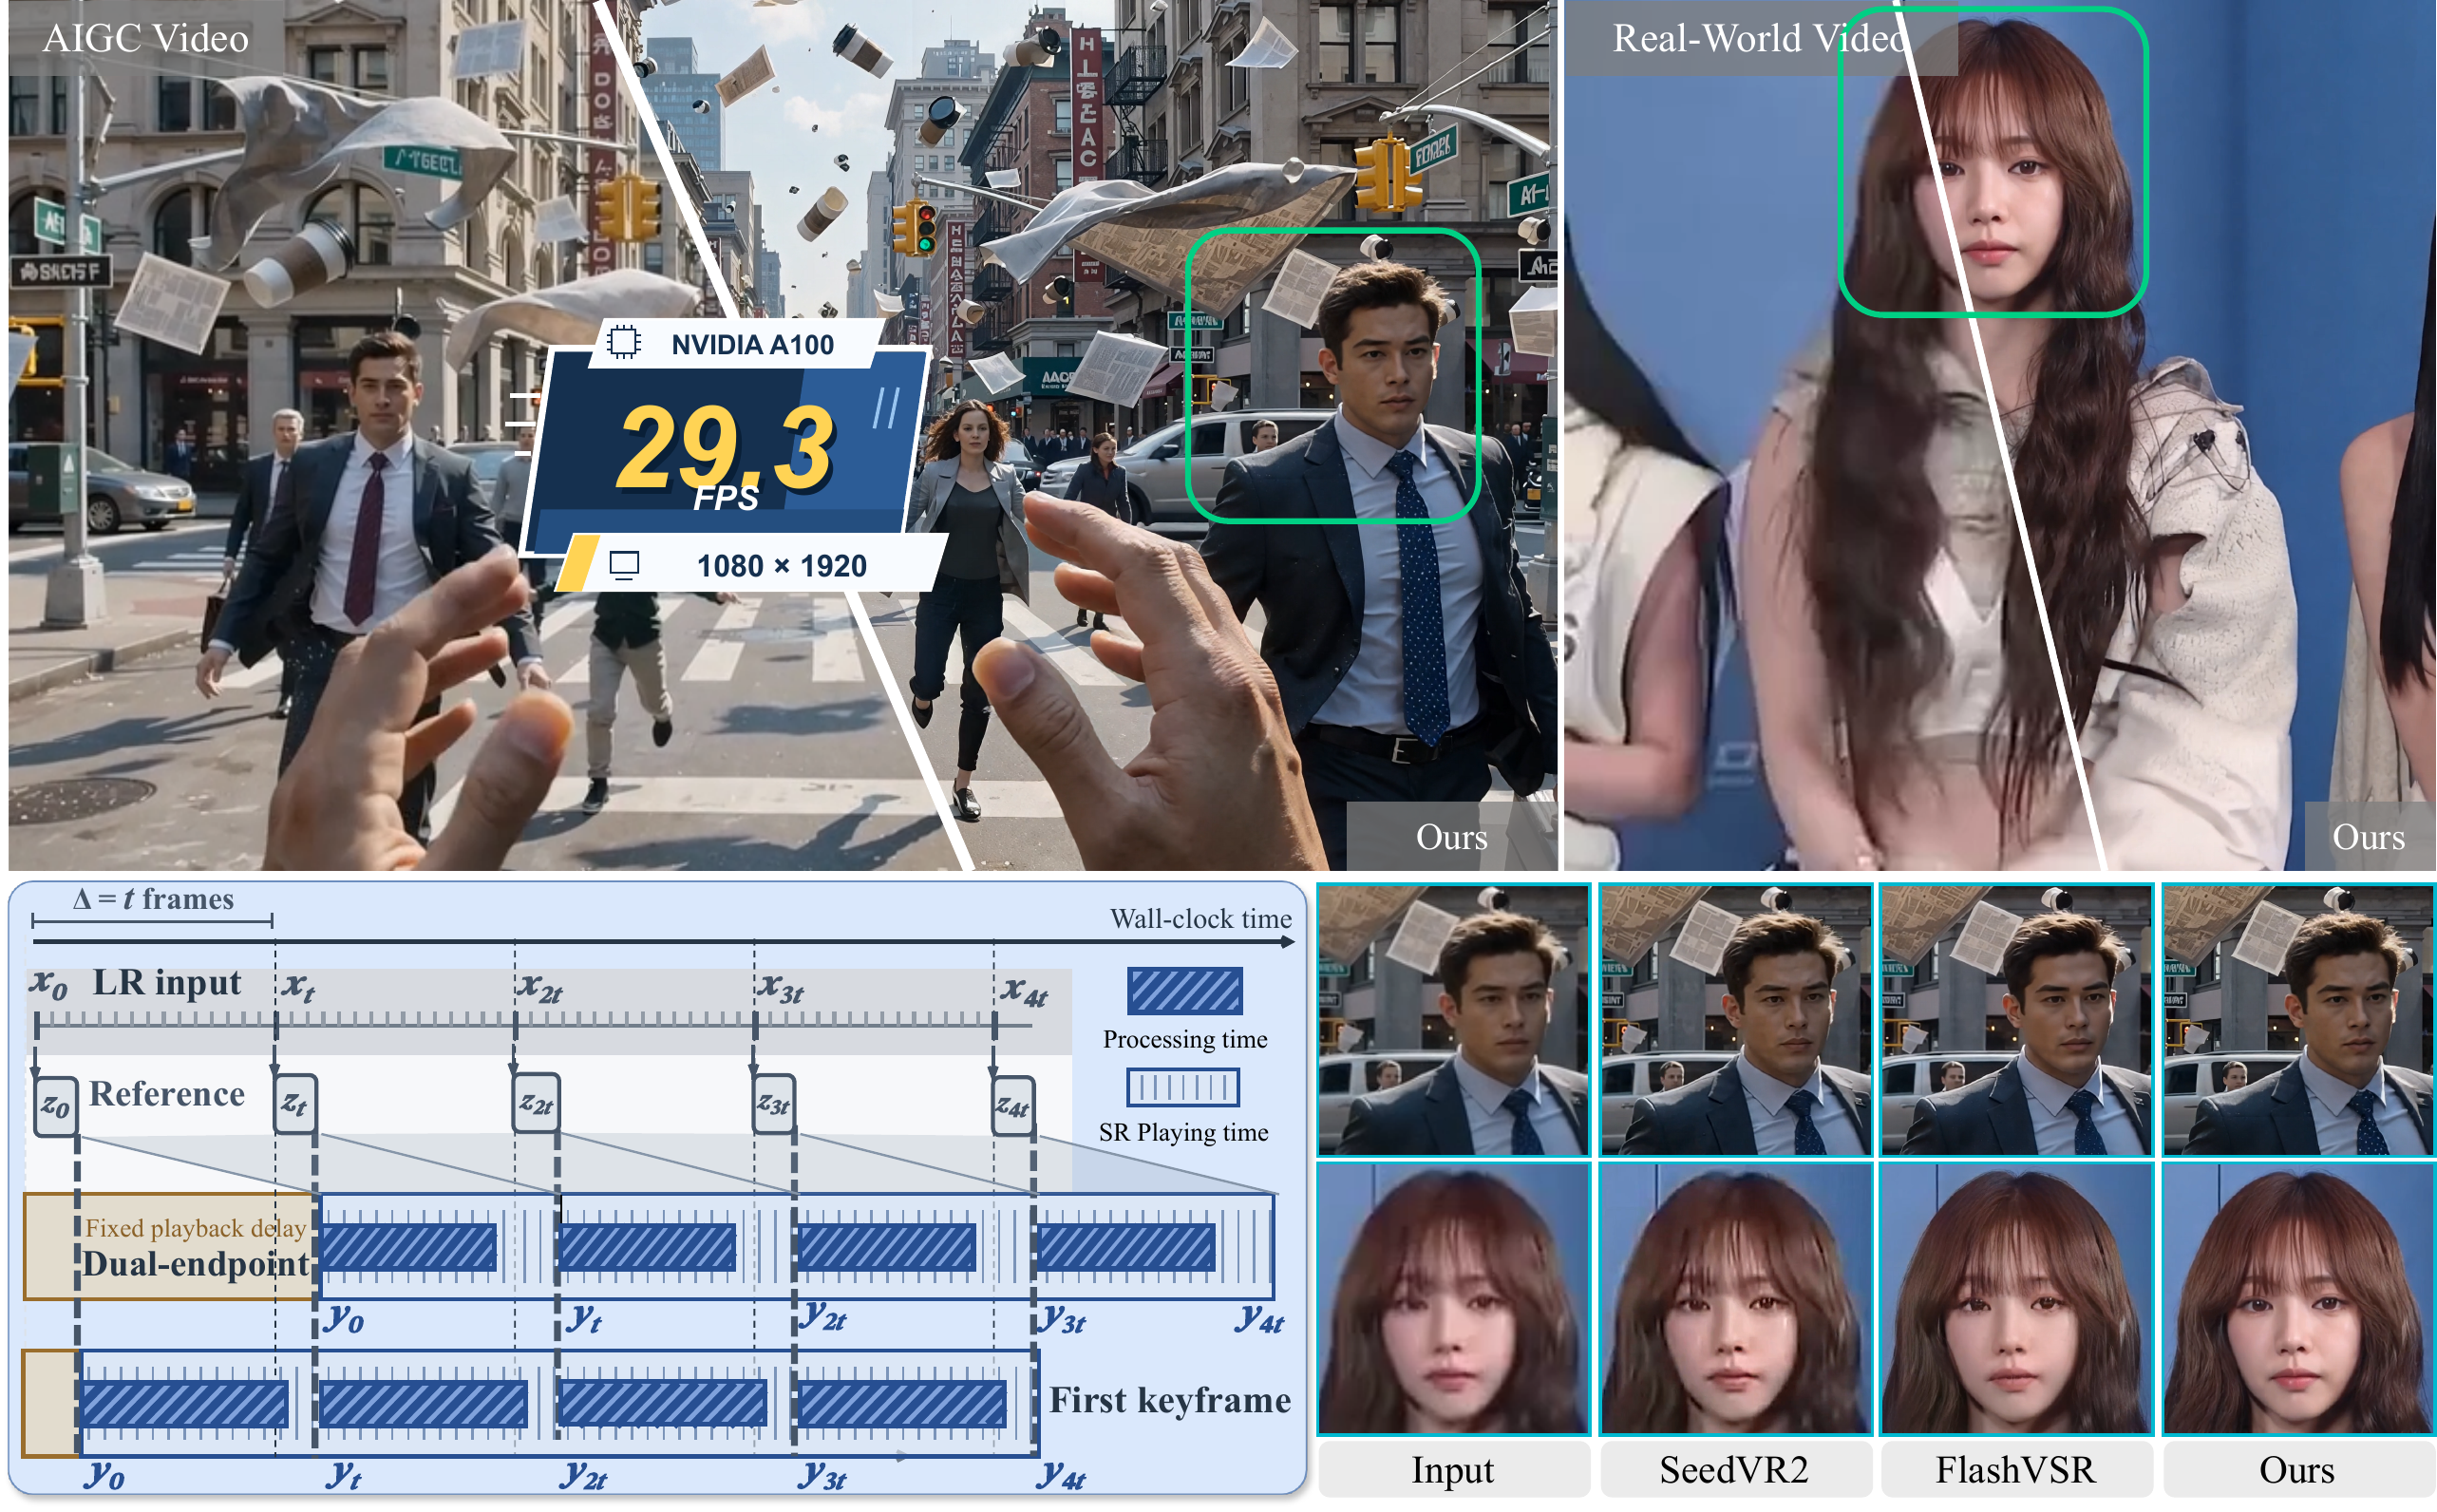
Исследователи Университета науки и технологий Китая представили RelayVSR — стриминговый фреймворк для 4x-апскейла видео, в котором большая генеративная модель на базе Wan создает опорные кадры лишь в редких местах ролика, а восстанавливает все остальные кадры легкая сеть Dual-Memory Video Transformer. По замерам авторов, на одной A100 при 1080p фреймворк выдает около 29 FPS при потреблении 13,82 ГБ памяти и задержке первого кадра 0,327 с, заметно опережая FlashVSR-Tiny. Код и веса открыты под Apache-2.0, есть готовый ComfyUI-порт, поэтому заявленные цифры можно проверить на собственном материале.


Что произошло
Группа авторов из Университета науки и технологий Китая (Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li, Zhibo Chen) опубликовала 29.09.2026 препринт arXiv:2609.37850, в котором описан RelayVSR — стриминговый фреймворк для 4x-апскейла видео. Ключевой механизм носит имя Sparse Generative Relay: большая генеративная модель на базе Wan строит опорные латенты только на редких ключевых кадрах, а легкая сеть Dual-Memory Video Transformer восстанавливает все остальные кадры, опираясь на опорники и недавний контекст. Обучение ведется через схему VARO, reinforcement learning с двумя наградами: системная награда оценивает итоговое видео, собранное легкой сетью, а референсная — качество самих ключевых кадров. На одной A100 при 1080p фреймворк показывает 29,29 FPS при 13,82 ГБ памяти и задержке первого кадра 0,327 с, тогда как FlashVSR-Tiny в приводимом сопоставлении выдает 7,80 FPS при 24,447 ГБ и 2,83 с до первого кадра. Фреймворк работает в стриминговых режимах опоры на первый кадр и на два конца с ограниченным заглядыванием вперед, поэтому длинные ролики обрабатываются без разбивки на куски. Код выложен на github.com/kopperx/RelayVSR под лицензией Apache-2.0, веса размещены на huggingface.co/kopper/RelayVSR, а ComfyUI-порт Comfy-Org/RelayVSR уже набрал более 2600 загрузок.
Контекст
Чтобы понять ценность схемы, полезно вспомнить, как устроен классический генеративный VSR: тяжелую сеть запускают на каждом кадре, качество получается высоким, но время и память делают такое решение пригодным прежде всего для офлайн-обработки, когда длинный ролик режут на куски и ждут готового результата. RelayVSR перераспределяет нагрузку иначе: дорогие вызовы генеративной модели совершаются редко и приходятся на опорные кадры, кодирующие основные детали, а промежуточные кадры достраивает легкая сеть с памятью о недавнем контексте. Отдельная уязвимость relay-подходов в том, что ошибка одного опорного кадра наследуется при достройке и может расползтись по всему ролику; поэтому авторы обучают модели RL-сигналом за итоговое видео после легкой сети, а не за изолированно красивые ключевые кадры. Важна и полнота релиза: исследовательские работы по генеративному VSR редко выходят одновременно с кодом, открытыми весами и инфраструктурой ComfyUI, а здесь к этому прилагаются конкретные замеры на одной A100, что переводит обсуждение из жанра демо в режим проверки под продакшен.
Почему это важно для индустрии
Для индустрии ценен не только сам фреймворк, но и переносимый архитектурный паттерн: редкие, но дорогие вызовы большой генеративной модели плюс частые вызовы легкой сети с памятью, обученной через RL на итоговом артефакте. В применении к апскейлу это дает заявленный выигрыш примерно в 3,75 раза по скорости и примерно на 43% по памяти, а значит генеративный VSR перестает быть чисто офлайн-батч-задачей и становится реалистичным кандидатом для стриминга и обработки длинных роликов. Самостоятельная оценка начинается немедленно: код Apache-2.0 и открытые веса позволяют поднять self-hosted прототип на GPU класса A100 без ожидания API и сервиса от разработчиков. Если независимые проверки подтвердят цифры, следует ожидать волны интеграций в ComfyUI-workflows, первых сервисных оберток и дообучений легкой сети под нишевый контент, а в более длительной перспективе — попыток распространить подобную схему на смежные видео-задачи вроде интерполяции и видео-понимания. Это прогнозы, а не установленные факты.
Почему это важно для пользователей
Читателям релиз дает проверяемый на практике инструмент: собственные ролики в 1080p можно увеличить в четыре раза со скоростью, близкой к воспроизведению в реальном времени, не дожидаясь многочасовой пакетной обработки. Прототип собирается за вечер: установить в ComfyUI порт Comfy-Org/RelayVSR, прогнать как обычное отснятое, так и сгенерированное нейросетями видео и сравнить результаты с текущим стеком. Веса лежат открыто на Hugging Face, лицензия Apache-2.0 допускает коммерческое использование, поэтому попробовать схему может и небольшая студия, и одиночный энтузиаст. Главный ограничитель — железо: замеры делались на A100, карте дата-центрового класса, так что для домашней сборки понадобится GPU с сопоставимым запасом памяти.
Что пока неизвестно / ограничения
Замеры пока авторские: независимых измерений на другом железе и другом контенте в опубликованных материалах нет, поэтому тезисы вроде живого апскейла трансляции или падения стоимости обработки часа видео в разы остаются бизнес-гипотезами, а не установленными фактами. Метрик качества в материалах также нет, так что закладывать RelayVSR в продакшен сегодня стоит только как экспериментальный этап пайплайна с собственным набором метрик на реальном контенте. Это исследовательский код без API, хостинга и SLA. Наконец, потребление памяти в тесте относится к уровню дата-центровых GPU: поведение на потребительских картах не показано.
Источники
- RelayVSR: Large-Small Model Collaboration for Efficient Real-World Video Super-Resolution (arXiv:2609.37850)
- RelayVSR — проект-страница (USTC)
- kopperx/RelayVSR — GitHub: код фреймворка (Apache-2.0)
- kopper/RelayVSR — открытые веса (Hugging Face)
- Comfy-Org/RelayVSR — ComfyUI-порт (Hugging Face)
Автор
Look at AI, редакция