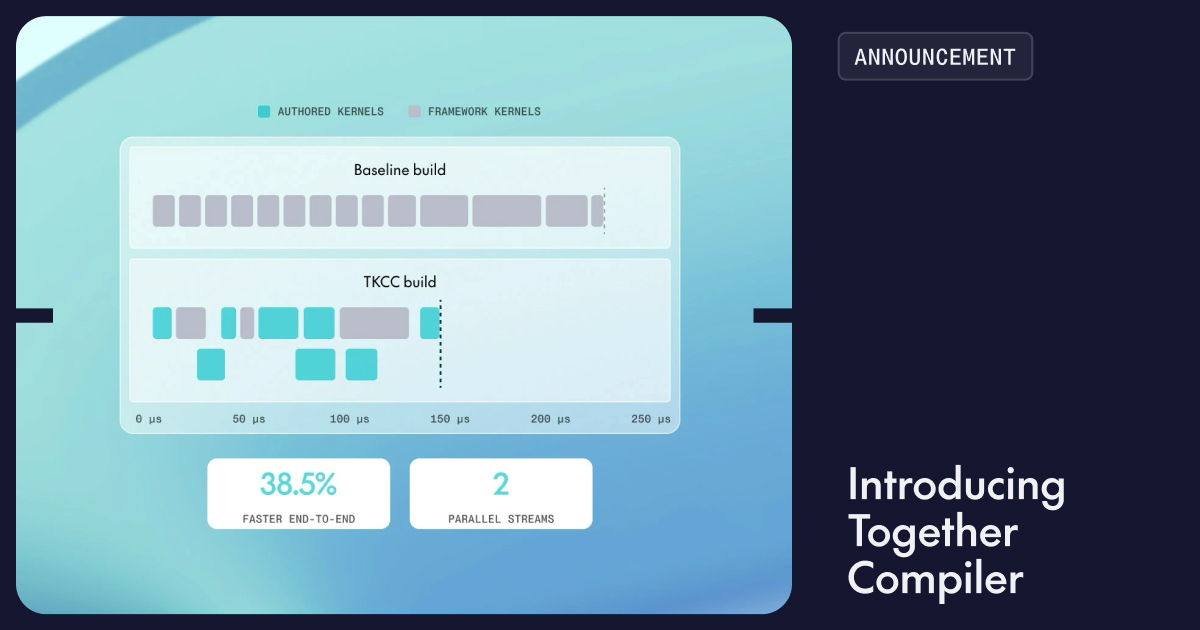
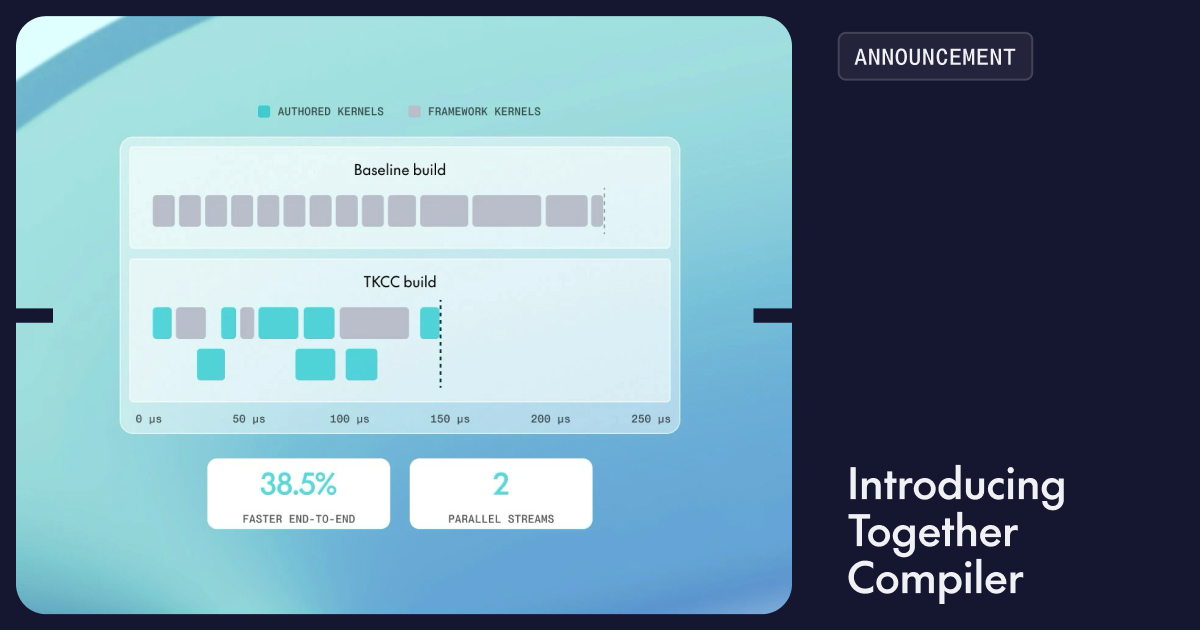
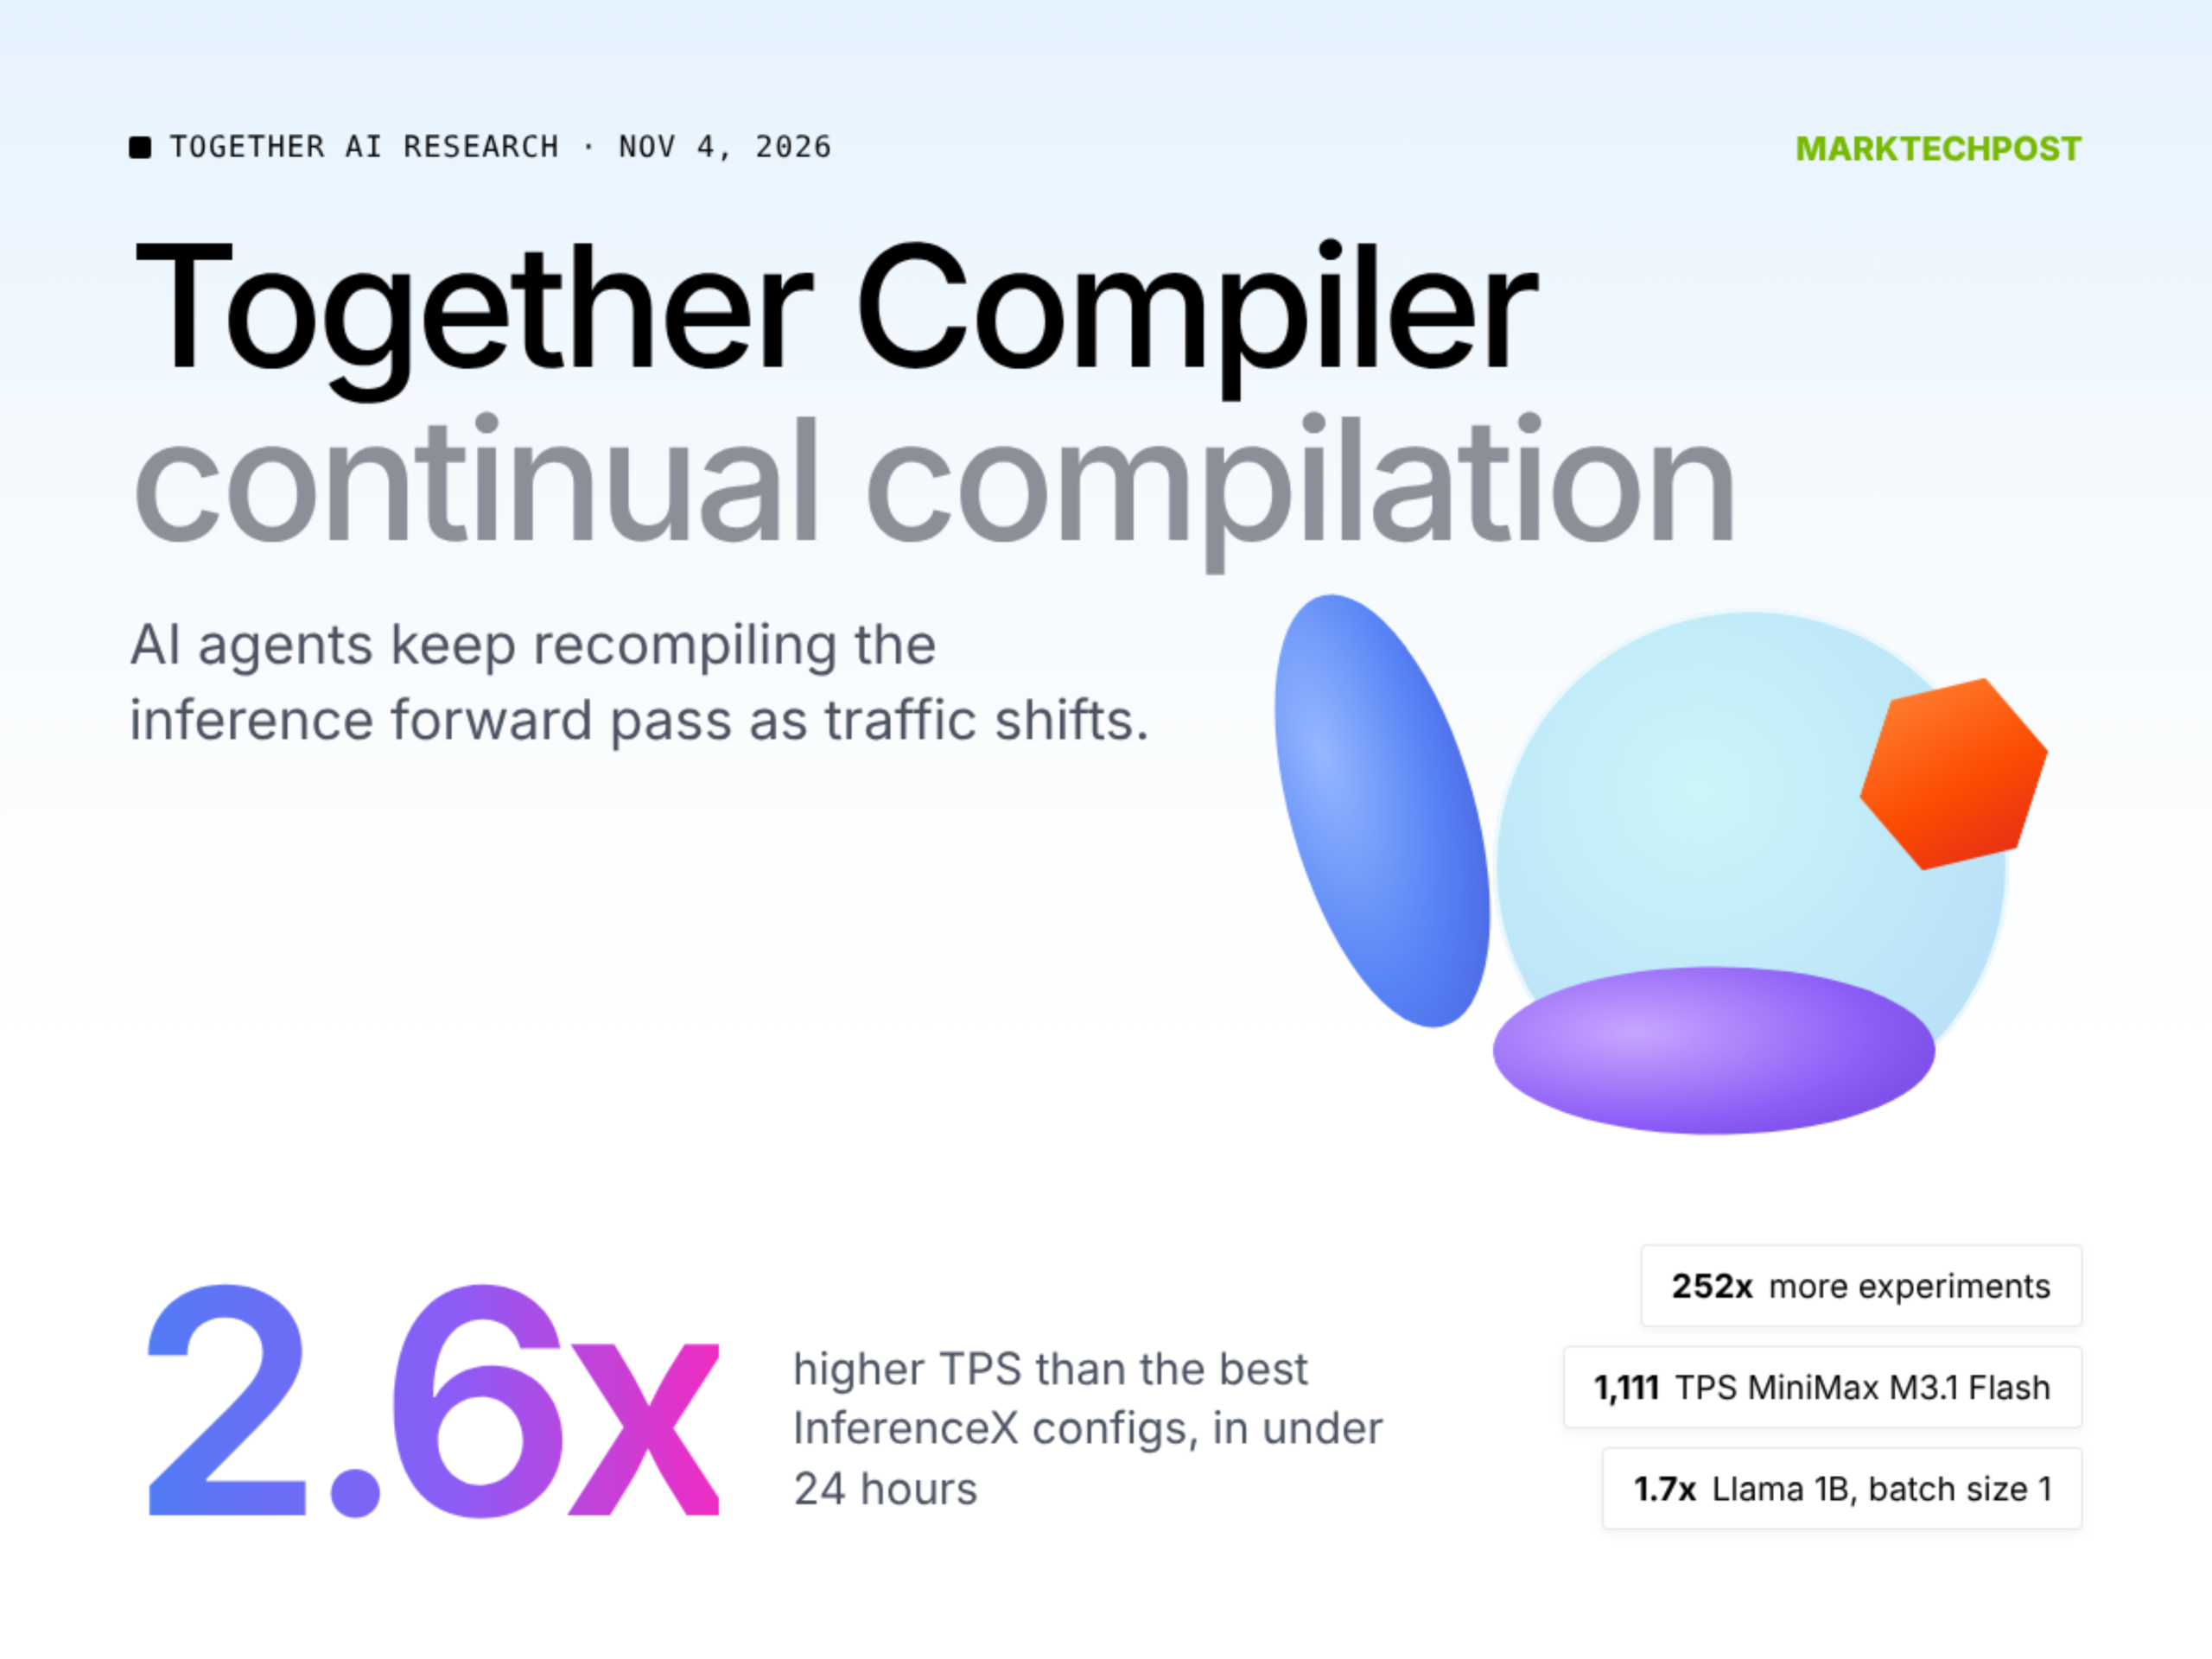
Компания Together AI представила Together Compiler (TKCC) — систему «непрерывной компиляции» для AI-инференса, в которой кодинг-агенты постоянно переписывают forward pass моделей под текущий трафик и железо, а инференс-движок замеряет кандидатов без перезапуска. По данным компании, запуск движка ускорился с 467 до 9 секунд, а меньше чем за сутки система подняла скорость генерации до 2.6x на открытых моделях и установила рекорд в бенчмарке SemiAnalysis InferenceX.

Что произошло
Together AI анонсировала систему, в которой агенты с доступом к изменению кода инференса непрерывно оптимизируют forward pass модели под изменившийся профиль нагрузки или новое оборудование. Результаты каждого кандидата на оптимизацию проверяются автоматически через инференс-движок, чтобы не пропустить деградацию качества. За первые сутки работы подход дал до 2.6x ускорение генерации на открытых моделях.
Контекст
Традиционно инференс-движки и serving-стеки оптимизируются инженерами вручную: под конкретный профиль нагрузки и конкретное железо. Это означает, что каждое изменение — рост длины промптов, смена моделей, переход на новые GPU (H100, B200, B300, NVL72, Groq) — требует новой ручной настройки, а эффект от неё постепенно «протухает» по мере дрейфа трафика. Together AI предлагает перевести этот процесс в непрерывный замкнутый контур «агент переписывает forward pass → движок мгновенно измеряет кандидата»: ключевой инженерный элемент — постоянный инференс-движок, запуск которого сокращён с 467 до 9 секунд, что даёт 252x больше экспериментов в единицу времени. Именно скорость измерения делает автоматическую оптимизацию практичной: система ставит SOTA в бенчмарке SemiAnalysis InferenceX — 1111 TPS на MiniMax M3.1-Flash (B200) и 1205 TPS на DeepSeek v4.1-Flash (GB300). Примечательная деталь: «наивные» агенты без экспертных подсказок показали 6.2x ускорение против 4.9x у экспертных стратегий — если это устойчиво, это вызов распространённому предположению, что «сильные промпты эксперта лучше» в агентном тюнинге систем.
Почему это важно для индустрии
Для провайдеров инференса и команд, обслуживающих модели в проде, continual compilation может снизить расходы на GPU: система автоматически подстраивает планирование и вычисления под реальный трафик вместо ручной настройки под пиковые сценарии. Это сокращает потребность в глубоко специализированных инженерах по CUDA-ядрам: часть работы по профилированию и переписыванию низкоуровневых оптимизаций переходит агентам. Конкурентам придётся отвечать своими агентными системами оптимизации, чтобы не уступать в цене за токен — иначе разница в 2.6x на идентичных моделях станет заметной в юнит-экономике.
Почему это важно для пользователей
Для пользователей API-инференса ускорение проявляется в более низкой латентности и снижении цены за токен при неизменном качестве модели. Для команд, которые разворачивают открытые модели (Kimi K3, GLM 5.3, MiniMax M3.1-Flash, DeepSeek v4.1-Flash) на своём железе, появляются вопросы применимости: заявленные скорости получены на оборудовании провайдера, и самостоятельное повторение результата требует доступа к той же железной конфигурации и агентному контуру.
Что пока неизвестно / ограничения
Ключевые цифры (2.6x TPS, 467→9 секунд на запуск движка, 252x throughput экспериментов, 6.2x у наивных агентов против 4.9x у экспертных стратегий, 1111 TPS и 1205 TPS InferenceX) взяты из вендорского блога Together AI и пересказов в СМИ без независимой проверки. Не раскрыто распределение ускорений (медиана, минимум), условия замеров, конфигурации TP/EP/DCP и бюджет итераций при сравнении «наивных» и «экспертных» агентов. Для LLM качество вывода после переписывания forward pass не заявлено как bit-exact — это ограничение подтверждено только для научных моделей (погодных, PDE, time-series). Способов применить TKCC вне serverless-эндпоинтов Together компания не описала: нет открытого API, цен или артефактов для self-hosted. Результаты InferenceX не подтверждены третьей стороной.
Источники
- Together Compiler: Continual Compilation for AI Inference (Together AI Blog)
- Together AI Releases Together Compiler: Agents Make Inference Up to 2.6x Faster (MarkTechPost)
- Together AI Unveils Together Compiler for Continuous AI Inference Optimization (Blockchain.News)
Автор
Look at AI, редакция