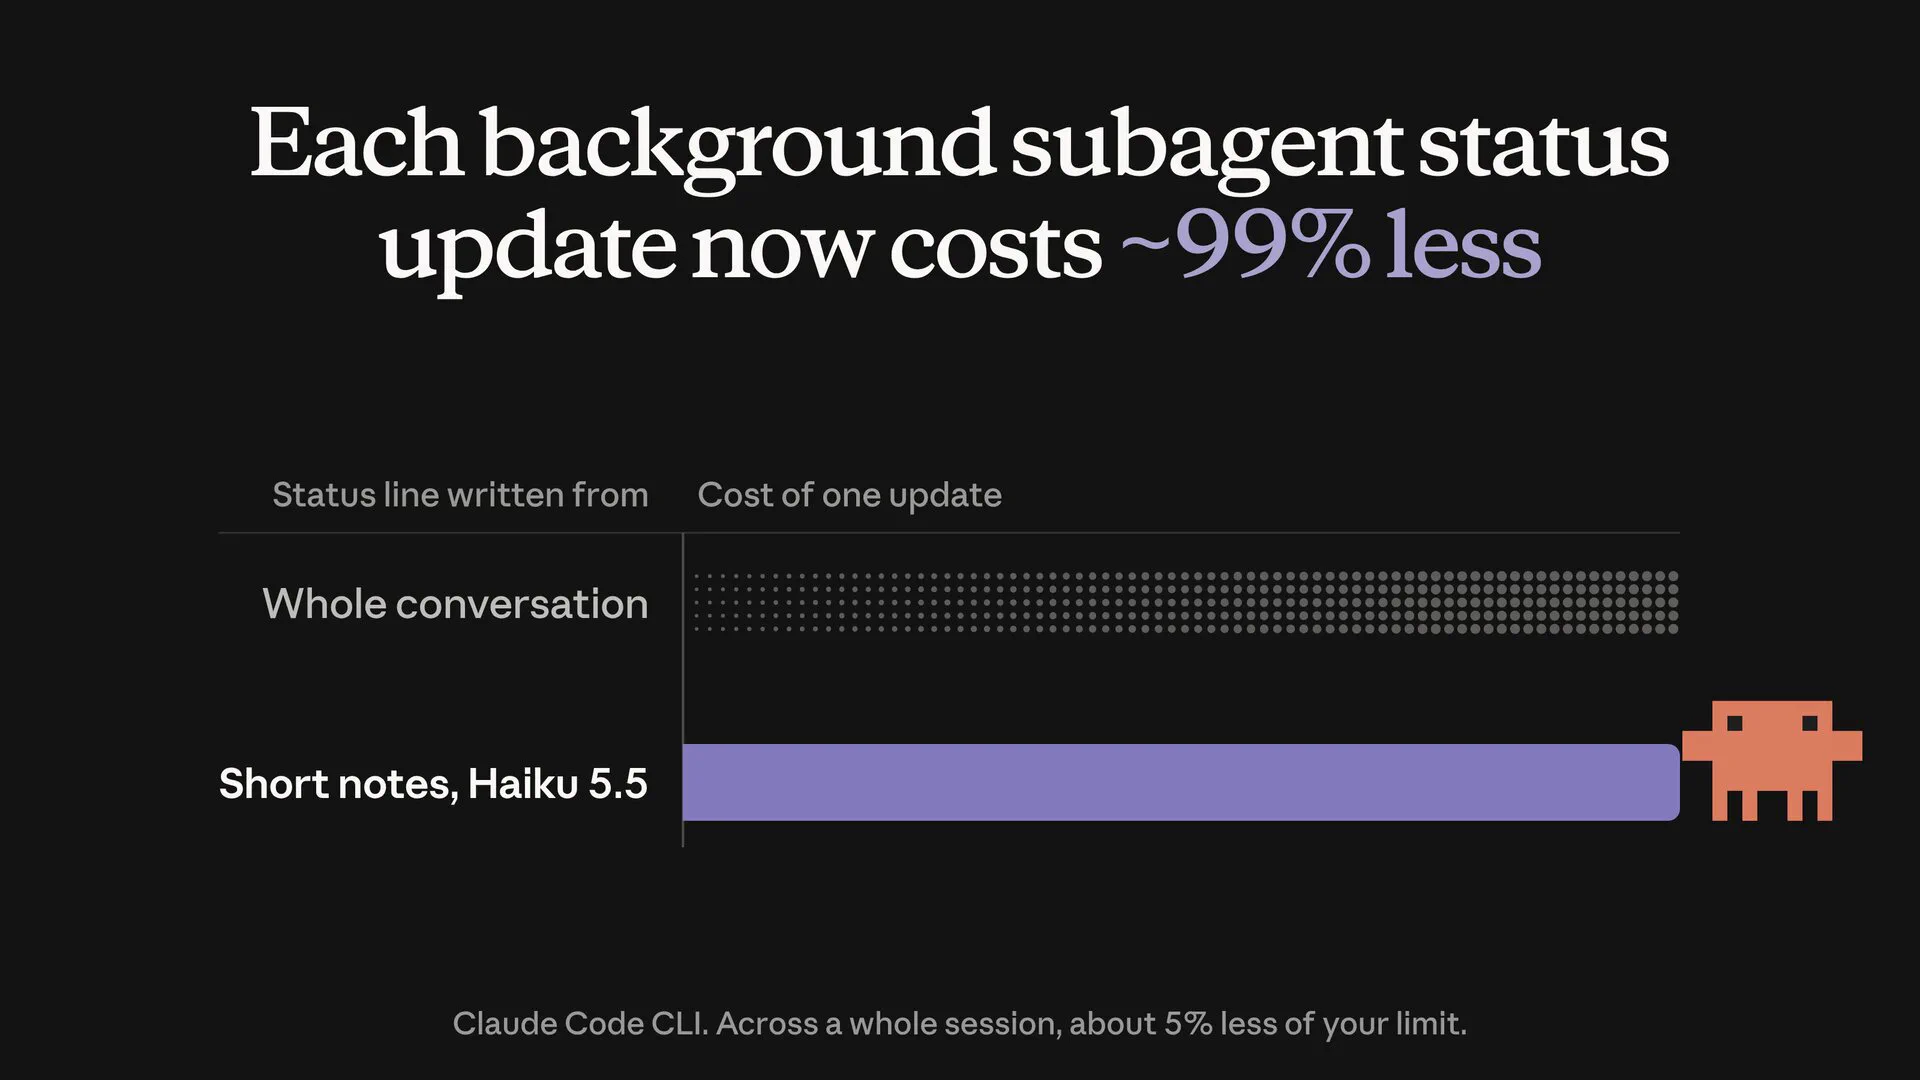
Anthropic подтвердила и устранила перерасход токенов в Claude Code: долгие сессии теряли лимит не на полезную работу, а на служебные операции. Фоновые субагенты, занятые проверкой кода и тестами, постоянно обновляли строку статуса, и базовая модель ради одной такой строки заново считывала всю историю переписки. Теперь статус формирует дешёвая модель Haiku 5.5 по коротким заметкам, без чтения полного контекста, поэтому обновление Claude Code бесплатно возвращает пользователям командной строки несколько процентов лимита. Случай показателен как наглядный пример того, как рутинные вызовы агента удешевляются маршрутизацией на компактную модель прямо в готовом продукте.


Что произошло
Фоновые субагенты Claude Code, выполняющие проверку кода или прогон тестов, обновляли строку статуса каждые 30 секунд, и при каждом обновлении базовая модель заново считывала всю историю переписки. По техническим отчётам пользователей, на эти служебные вызовы уходило до 16 процентов бюджета токенов в сессии, и после жалоб Anthropic публично подтвердила проблему, а затем выпустила исправление. Теперь строку статуса формирует менее ресурсоёмкая модель Haiku 5.5: она опирается на короткие заметки и не читает полный контекст, поэтому стоимость отдельного обновления статуса, по оценке компании, снизилась примерно на 99 процентов. Изменение вошло в релиз Claude Code v2.1.316 и новее и работает только в CLI.
Контекст
Причина таких потерь лежит в экономике long-running агентов: длительные сессии наполняются служебным трафиком — статусами, сводками прогресса, уведомлениями, — который формально не относится к полезной работе, но потребляет те же токены. Цена каждой служебной операции определяется объёмом перечитываемого контекста, поэтому рутина, при которой дорогая модель дублирует чтение всей истории переписки, превращается в скрытую и быстро растущую статью расходов: чем длиннее сессия, тем дороже каждый такой вызов. Показательно, что о проблеме сообщили сами пользователи, и вендор официально признал описанный механизм перерасхода вместо того, чтобы оставлять его без комментария, — такие признания в индустрии редки и повышают доверие к официальному разбору. Само исправление относится не к моделям, а к оркестрации: рутинную подзадачу с редуцированным контекстом можно отдавать компактной модели, сохраняя флагманскую для работы, ради которой агент и запускался.
Почему это важно для индустрии
Для индустрии ценность случая не столько в самом багфиксе, сколько в переносимом паттерне: служебные операции агента — строки статуса, логирование, промежуточные сводки — стоит выносить из контекста базовой модели и отдавать дешёвой модели по сжатым заметкам. Инцидент показал, что в агентных продуктах значимая доля токенов уходит не на полезную работу, и платформа способна закрыть такую дыру сама, одним патчем, как поступила Anthropic. Командам, которые строят мультиагентные пайплайны и long-running сценарии, есть смысл проверить собственные циклы на скрытые перечитывания полного контекста: аналогичные шаблоны служебных вызовов нередко встречаются и в самописных оркестраторах. Вероятное, хотя и не гарантированное, следствие — закрепление двухуровневой маршрутизации в агентных SDK и фреймворках, где распределение подзадач по критичности и стоимости станет обычной частью рантайма.
Почему это важно для пользователей
Практическая часть касается тех, кто запускает Claude Code в терминале. Достаточно обновиться до версии v2.1.316 или новее, например командой npm update -g @anthropic-ai/claude-code, — способ работы при этом не меняется. В сессиях с фоновыми субагентами это бесплатно возвращает порядка 5 процентов лимита, что соответствует примерно 6 процентам дополнительных запросов при прежнем ограничении. Эффект проявляется только там, где фоновые субагенты реально используются: без них экономия близка к нулю. Десктопное приложение оптимизацию пока не получило и продолжает расходовать токены по старой схеме, поэтому его пользователям стоит дождаться соответствующего обновления. При этом экономия на единичном служебном вызове не равна экономии всей сессии: служебный трафик составляет лишь часть общего расхода, поэтому ожидания стоит калибровать по уровню сессии.
Что пока неизвестно / ограничения
Заявленная экономия (примерно 99 процентов на одно обновление статуса и около 5 процентов по лимиту в сессии) — это оценка самой Anthropic, публичной методики замера для этих цифр нет, независимого измерения не проводилось. Также не раскрыто влияние исправления на латентность обновлений статуса и на качество самих генерируемых статусных строк, которые теперь пишет Haiku 5.5. Экономия касается только CLI, десктопное приложение пока ведёт себя по-старому. Прогноз о закреплении двухуровневой маршрутизации в SDK и фреймворках — интерпретация, а не факт из источников, поэтому перенос паттерна в собственные пайплайны требует самостоятельного замера, а не копирования цифр вендора.
Источники
- Claude Code Update: Reduced Usage for Background Subagents — @ClaudeDevs (официальный аккаунт Claude AI Developer Updates)
- Claude Code background subagents now cost about 99% less per status update — daily.dev
- Anthropic just fixed a major token wasting bug in Claude Code — Coding Beauty
Автор
Look at AI, редакция