💻 Together Compiler: кодинг-агенты непрерывно ускоряют AI-инференс
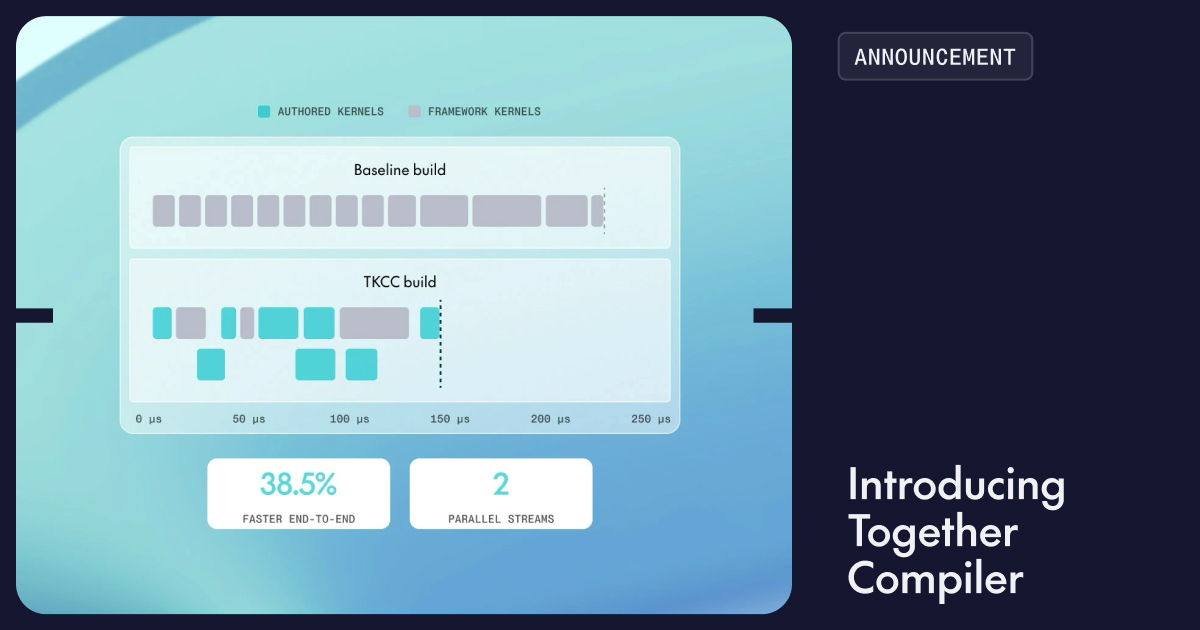
Together AI представила Together Compiler: агенты переписывают forward pass моделей под текущий трафик и железо, а движок проверяет кандидатов без перезапуска, его старт упал с 467 до 9 секунд. За сутки — до 2.6x TPS на Kimi K3, GLM 5.3, MiniMax M3.1-Flash, DeepSeek v4.1-Flash — и SOTA в SemiAnalysis InferenceX: 1111 TPS на B200, 1205 на GB300.
🌍 Из ручной настройки — в автоматический контур: TKCC сама адаптируется к дрейфу трафика и смене GPU, снижая стоимость и задержку LLM-сервисов.
👤 Обслуживающим LLM — путь к меньшей latency и стоимости: агенты подбирают параллелизм, «наивные» дали 6.2x против 4.9x у экспертных — но это замер вендора.
Источник 1: https://www.together.ai/blog/together-compiler-continual-compilation-for-ai-inference Источник 2: https://www.marktechpost.com/2026/11/05/together-ai-together-compiler-continual-compilation-ai-inference/