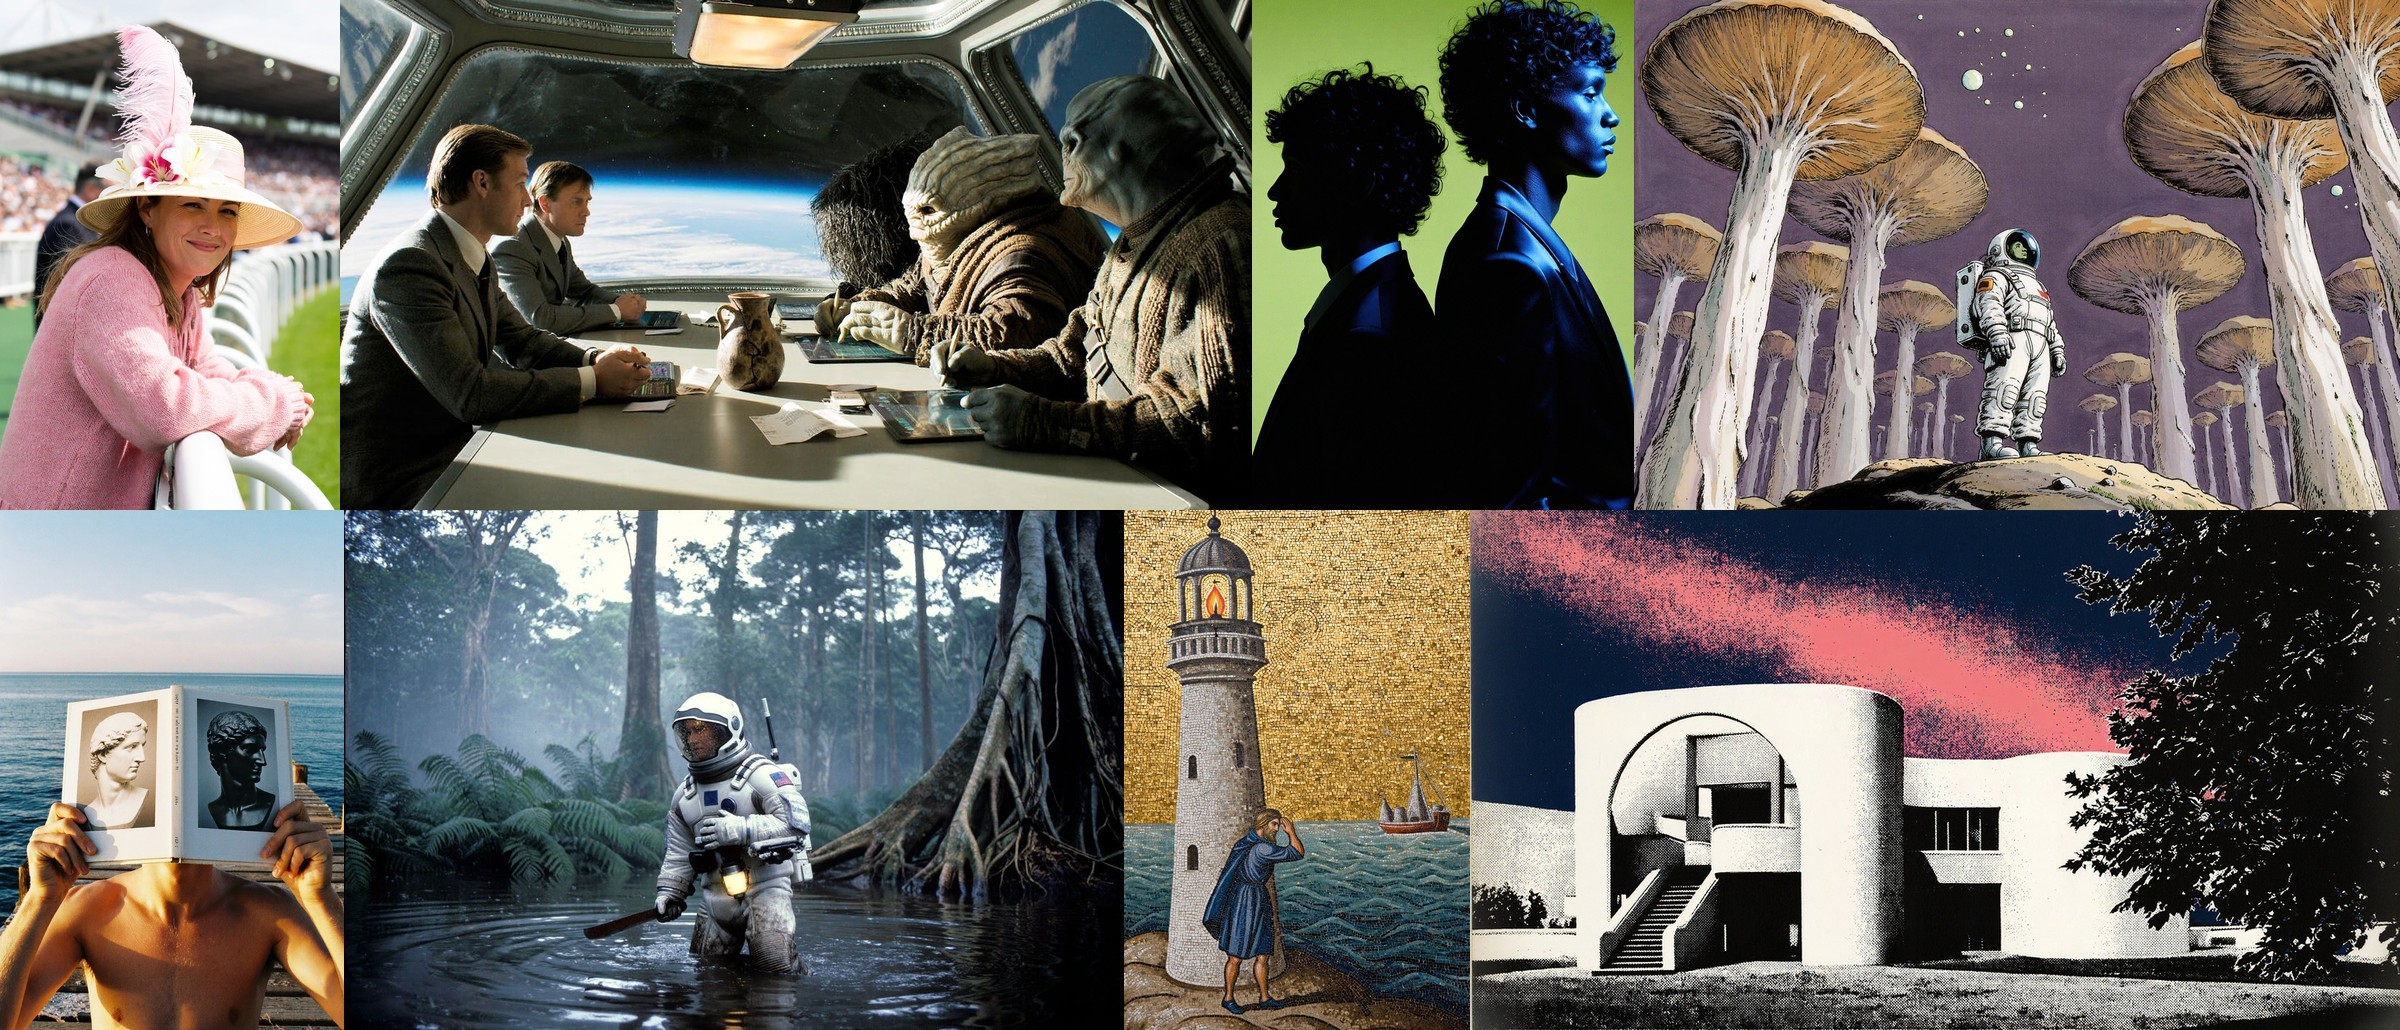
3 ноября 2026 года Pruna AI выпустила P-H3-Image — открытую модель генерации и правки изображений, собранную из видео-модели MiniMax-H3 покомпонентной дистилляцией: сжаты текстовый энкодер и трансформер, а расписание диффузии укорочено с 50 до 8 шагов. В результате фотореалистичная генерация кадра до 8 мегапикселей без CFG и негативного промпта укладывается в квантованные веса около 20 ГБ и пиковую VRAM около 21 ГБ, тогда как раньше такой класс задач требовал серверных ускорителей уровня H200. Веса открыты на Hugging Face, а в ComfyUI модель поддерживается нативно, без кастомных нод.


Что произошло
Pruna AI открыла веса image-модели P-H3-Image, пересобрав по частям видео-модель MiniMax-H3: текстовый энкодер дистиллирован с 32B до 4B параметров, трансформер сокращен с 33B до 20B, расписание диффузии укорочено с 50 до 8 шагов через DMD-дистилляцию, а декодер переобучен под одиночные кадры. Модель рендерит изображения до 8 мегапикселей (по заявлению Pruna — до 16) без CFG и негативного промпта и правит их по одному входному изображению или по набору до 8 референсов; внутри пайплайна работает встроенный prompt upsampler на Qwen3.5-9B, разворачивающий однострочный запрос в подробный промпт. Веса опубликованы в двух репозиториях на Hugging Face: PrunaAI/P-H3-Image с diffusers-пайплайном в bf16 весит около 100 ГБ и рассчитан на H200/B200 либо около 80 ГБ с offloading, а PrunaAI/P-H3-Image-Comfy содержит int8 и 4-битную w4a8 версии с загрузкой около 20 ГБ. Поддержка в ComfyUI нативная (master и версия v0.44.0) и не требует кастомных нод; на L40S кадр 2048x2048 в квантованном виде генерируется за 6.3 секунды против 19 секунд у bf16. Модель распространяется под лицензией MiniMax H3 Community License.
Контекст
Исходный стек был рассчитан на сервер: веса видео-модели MiniMax-H3 занимают около 143 ГБ, и фотореалистичная генерация высокого разрешения в этом классе до сих пор была привязана к ускорителям уровня H200. Релиз опирается на известный тренд few-step сэмплеров: DMD-дистилляция расписания сэмплера и отказ от CFG с негативным промптом упрощают и ускоряют пайплайн, но при этом семантическая нагрузка смещается на сжатый текстовый энкодер, что важно учитывать при оценке качества следования промпту. Второй конструктивный нюанс в том, что система фактически двухмодельная: итоговый результат зависит и от встроенного upsampler на Qwen3.5-9B, а не только от базовой генеративной части. Deployment-готовность оказалась на уровне лучших open-weights image-релизов именно потому, что пересборка сделана под стандартный инструментарий: ComfyUI поддерживает модель из коробки, а квантованные веса собраны штатными средствами.
Почему это важно для индустрии
Для отрасли релиз ценен проверяемыми по железу числами: покомпонентная дистилляция превратила видео-стек весом 143 ГБ в image-модель с загрузкой около 20 ГБ, дав семикратное уменьшение размера и пятикратный прирост скорости (2.6 секунды против 12.4 на 4 мегапикселях на B200) при заявленно сохраненном качестве. Как следствие, фотореалистичная генерация высокого разрешения переезжает из класса «нужен H200» в класс около 21 ГБ VRAM с ComfyUI из коробки на архитектурах Ampere+ и RDNA3/4, что кратно улучшает unit-экономику сервисов и снижает порог входа для стартапов. Билдеры получают готовый конструктор воркфлоу: правка по референсам, встроенный prompt upsampler и нативный ComfyUI позволяют собрать MVP на собственном железе за выходные без бюджета на серверные ускорители. Ожидаемо и давление на цены hosted-генерации в фотореалистичном сегменте, поскольку локальный стек стал доступнее; если рецепт пересборки воспроизводится на других видео-бекбонах, image-версии тяжелых видео-моделей могут стать стандартным открытым артефактом их выпуска.
Почему это важно для пользователей
Модель доступна уже сегодня: веса лежат в репозиториях PrunaAI/P-H3-Image и PrunaAI/P-H3-Image-Comfy на Hugging Face, а в ComfyUI версии v0.44.0 и выше поддержка нативная, без кастомных нод, с готовыми шаблонами Text-to-Image и Image Edit. Практический путь для большинства — квантованные версии на видеокарте с примерно 21 ГБ VRAM: вариант w4a8 с int8 VAE требует около 20 ГБ загрузки, работает за восемь шагов сэмплирования без негативного промпта, а кадр 2048x2048 на L40S генерируется за 6.3 секунды. Путь через diffusers в bf16 требует H200/B200 или около 80 ГБ с offloading, поэтому локально он пока дорог. Сильные стороны модели — фотореализм, редакционная и документальная съемка, кадры в духе кино и графика с коротким текстом; слабые места — руки и мелкие детали на разрешениях ниже 8 мегапикселей, ненадежный рендер плотного текста и чувствительность к «хайповым» словам в промпте. Перед коммерческим применением стоит внимательно изучить лицензию MiniMax H3 Community License: она ограничивает коммерческое использование, и без отдельного соглашения часть сценариев окажется недоступной.
Что пока неизвестно / ограничения
Оценка «воспроизводимый рецепт превращения видео-модели в image-модель» пока опирается на единственный случай: пересобрана одна базовая модель и получена одна производная, а проверка на других видео-бекбонах впереди. Ключевые цифры релиза, включая семикратное уменьшение веса, пятикратный прирост скорости и заявку про 16 мегапикселей, представлены самой Pruna AI, и на момент выпуска независимых сравнений с исходной MiniMax-H3 и конкурентами по фотореализму и качеству правок нет. Результат двухмоделен, так как зависит и от встроенного upsampler на Qwen3.5-9B, что осложняет воспроизведение и интерпретацию любых сравнений. Точные условия ограничений коммерческого использования по лицензии MiniMax H3 Community License стоит проверять по тексту лицензии до запуска коммерческого продукта.
Источники
- P-H3-Image: Turning a SOTA Video Model into an Efficient Open Image Model — Pruna AI (блог, 3 ноября 2026)
- PrunaAI/P-H3-Image — Hugging Face (карточка модели, diffusers pipeline)
- PrunaAI/P-H3-Image-Comfy — Hugging Face (ComfyUI-версии bf16/int8/w4a8)
Автор
Look at AI, редакция