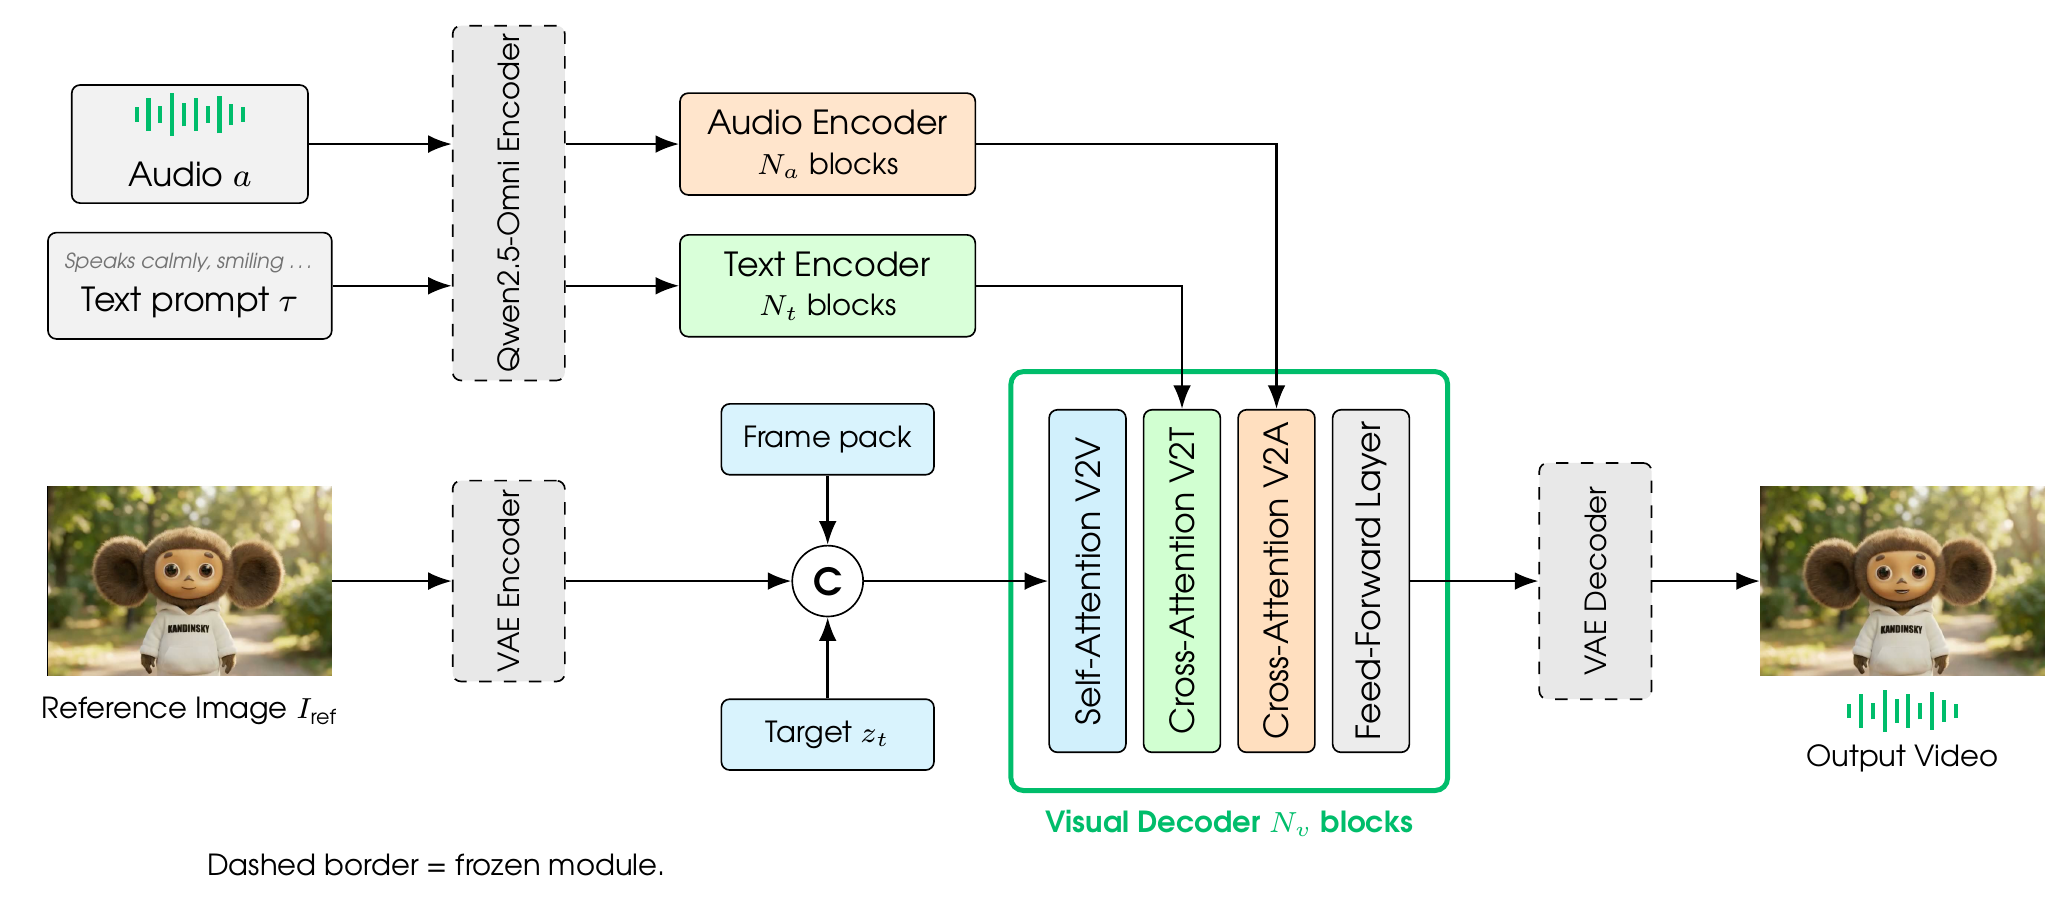
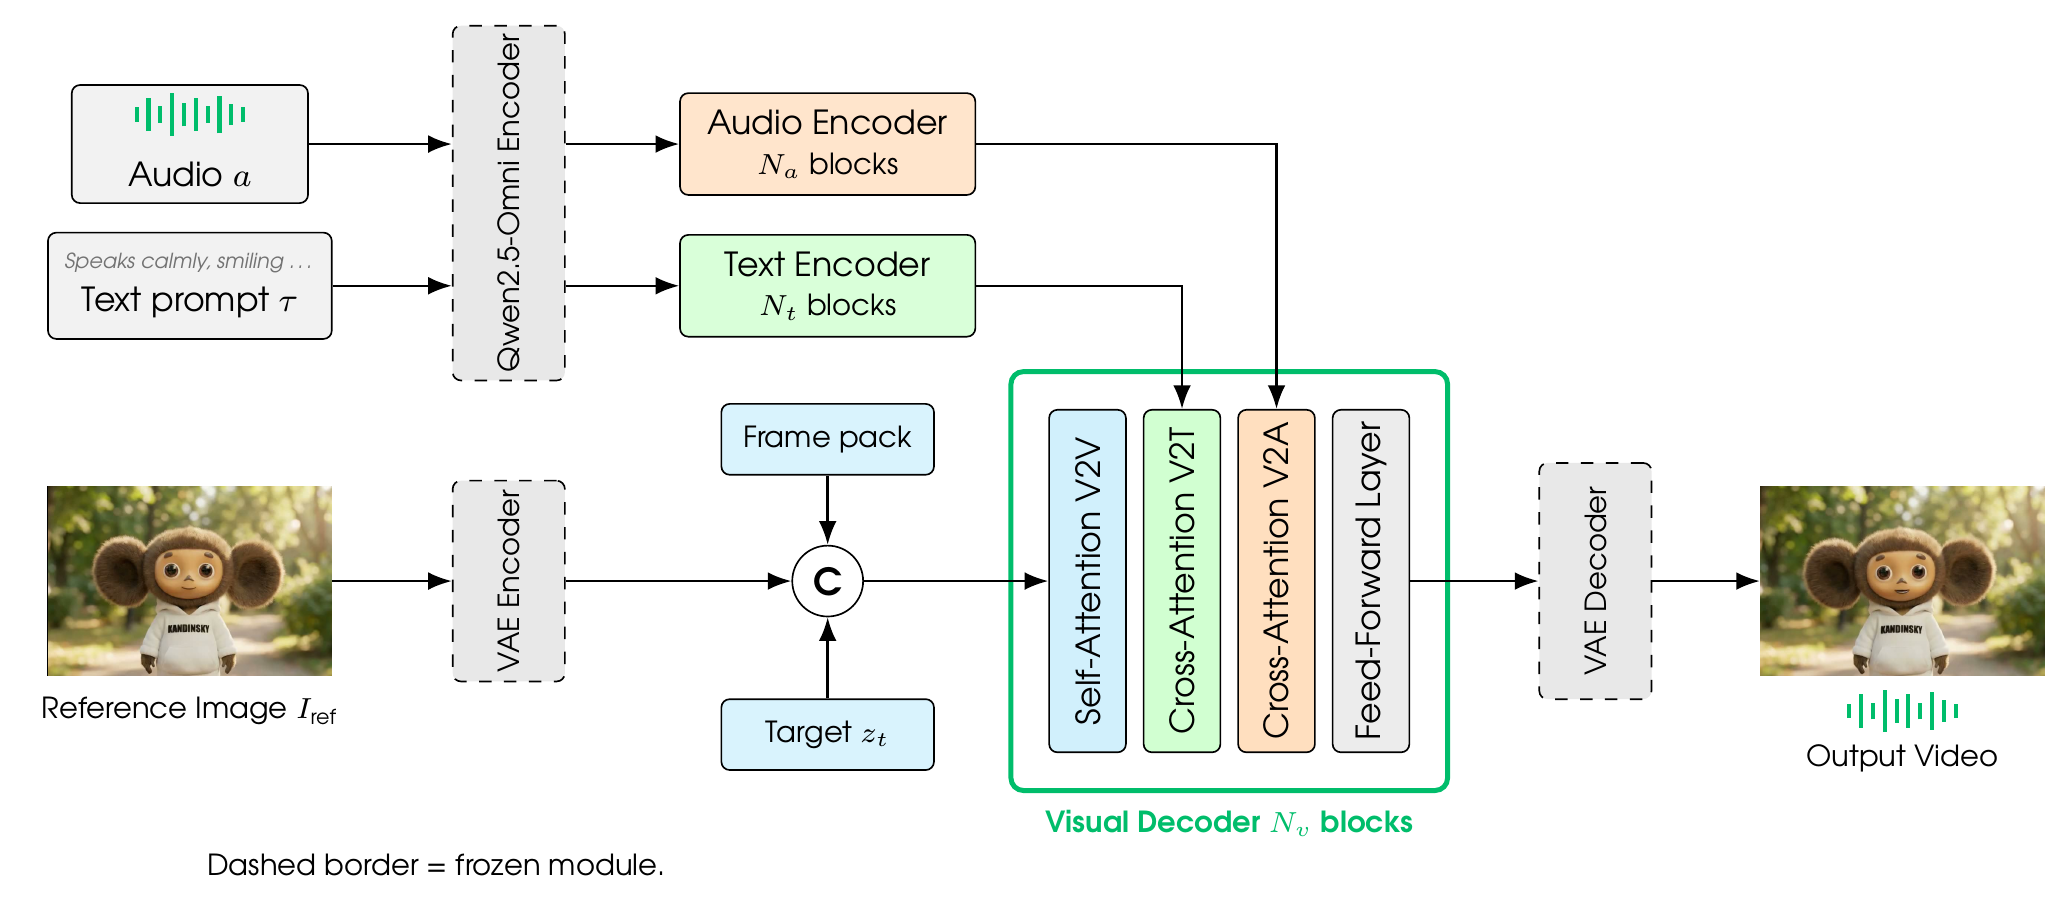
Сбер (kandinskylab) открыл исходный код и веса семейства speech-to-video моделей Kandinsky S2V 1.0: Lite на 2B параметров, Pro на 21B параметров и ускоренные дистилляты π-Flow. Модели превращают один кадр-референс, аудиодорожку и текстовый промпт в видео говорящего человека, у которого артикуляция, мимика и жесты следуют за речью. Всё распространяется под MIT-лицензией, разрешающей коммерческое использование, а попробовать генерацию можно в браузерном демо на Hugging Face без установки. Обратная сторона открытости — высокие требования к железу: для локального запуска нужен серверный NVIDIA GPU с десятками гигабайт видеопамяти. Заявленное качество на уровне коммерческих сервисов пока подтверждено только собственными слепыми тестами Сбера и ждёт независимой проверки.

Что произошло
Лаборатория Сбера kandinskylab выложила код и веса Kandinsky S2V 1.0 в репозиторий kandinskylab/kandinsky-s2v на GitHub с лицензией MIT, карточки моделей появились на Hugging Face в формате Diffusers. Семейство состоит из Lite на 2B параметров, Pro на 21B параметров и дистиллированных π-Flow вариантов, которые генерируют видео всего за 16 шагов инференса без classifier-free guidance, что даёт ускорение примерно в 5,4 раза. На вход система принимает один кадр-референс, аудиодорожку и текстовый промпт, на выходе выдаёт ролик с частотой 25 FPS, в котором артикуляция, мимика, поза и жесты синхронизированы с речью. Длинные ролики — по данным проекта, до 60 секунд — собираются из 5-секундных чанков с механизмом памяти FramePack. Обучение прошло на 1,17 млн односпикерных клипов с подписями на английском и русском языках.
Контекст
Генерация говорящих видеоаватаров до этого момента была в основном территорией закрытых сервисов по подписке вроде HeyGen, где пользователь платит за минуты генерации и не контролирует ни модель, ни данные. Открытые веса меняют саму схему потребления: MIT-лицензия переводит такую генерацию из формата SaaS-подписки в собственную или арендованную инфраструктуру, а код, карточки моделей и демо делают открытый baseline воспроизводимым — его можно изучать, дообучать и встраивать без лицензионных ограничений. Отдельный технический слой — дистилляция π-Flow: её ценность лежит не в рейтинге качества, а в экономике инференса, потому что именно стоимость минуты генерации решает, окупится ли встраивание аватаров в продукт. Подключение при этом идёт через стандартный пайплайн библиотеки Diffusers, без кастомного интеграционного кода. Осталось помнить, что релиз является research-grade, и до готового продукта предстоит собственная инженерная работа.
Почему это важно для индустрии
Для индустрии появился бесплатный open-source компонент там, где раньше был только платный сервис. MIT-лицензия разрешает коммерческое использование, поэтому компании могут встроить пайплайн «кадр, аудио, промпт → видео» в свой периметр — виртуальные консультанты, обучающие курсы, локализация контента — без оплаты за каждую минуту генерации внешнему вендору. Для закрытых avatar-сервисов это коммодитизация самого этапа генерации: ценовой ров исчезает, как только функционально близкую модель можно развернуть у себя, а стартапы вынуждены смещать ценность из обёртки над моделью в вертикальные сценарии, дистрибуцию и дешёвый управляемый инференс. Разработка на входе удешевляется: MVP на арендованных серверных GPU реально собрать за считанные недели, и основная инженерная работа сместится в контроль консистентности длинных роликов и управляемость генерации, а не в доступ к самой модели.
Почему это важно для пользователей
Попробовать модель можно уже сейчас без установки: в Hugging Face Space Kandinsky-S2V-1.0-Demo генерация работает прямо в браузере. Для локального запуска порог высокий: Lite требует NVIDIA GPU с 48 GB VRAM и больше при пиковом потреблении около 57 GiB, Pro — от 48 до 80 GB с пиком примерно 46–55 GiB, причём для HD-генерации Pro нужен верхний диапазон памяти; веса скачиваются автоматически и занимают около 25 GB у Lite и около 65 GB у Pro. На обычной домашней видеокарте ни одна из версий не запустится, так что реальный путь для энтузиастов — аренда облачного GPU. Читатели без такой техники всё равно остаются в выигрыше: генерация в демо бесплатна, любой может сравнить её результат с платными подписками, а затем использовать это сравнение при выборе сервиса или торге по тарифам.
Что пока неизвестно / ограничения
Ключевые заявления о качестве остаются данными вендора: слепые сравнения Pro с двумя коммерческими моделями и лидерство по липсинку опубликованы без состава жюри, размера выборки, списка бейзлайнов и метрики, поэтому до независимых воспроизведений их следует читать как утверждение разработчика, а не установленный факт. В материалах есть прямое противоречие по обучающим данным: описание проекта говорит о 1,17 млн односпикерных клипов с англо-русскими подписями, а текст поста упоминает более миллиона видео на 95 языках — какой языковой охват реально поддержан на инференсе, неизвестно, и для русскоязычного липсинка это критично. Расходятся и данные о частоте кадров: 25 FPS в описании против 24 кадров/с в тексте поста. Консистентность внешности, фона и жестов при склейке длинных роликов из 5-секундных чанков — непроверенная характеристика, которую стоит оценивать на собственных примерах, а не на отобранных демо-кейсах. Кроме того, это research-grade релиз без API, тарифов и данных по latency и throughput, а работа липсинка на шумной спонтанной речи, а не только на студийной, не подтверждена.
Источники
- Kandinsky S2V 1.0: Audio-Driven Avatar Video Generation — официальная страница проекта
- kandinskylab/kandinsky-s2v — репозиторий кода на GitHub (MIT-лицензия, бенчмарки VRAM и скорости)
- kandinskylab/Kandinsky-S2V-1.0-Pro-distill-Diffusers — карточка модели на Hugging Face
Автор
Look at AI, редакция