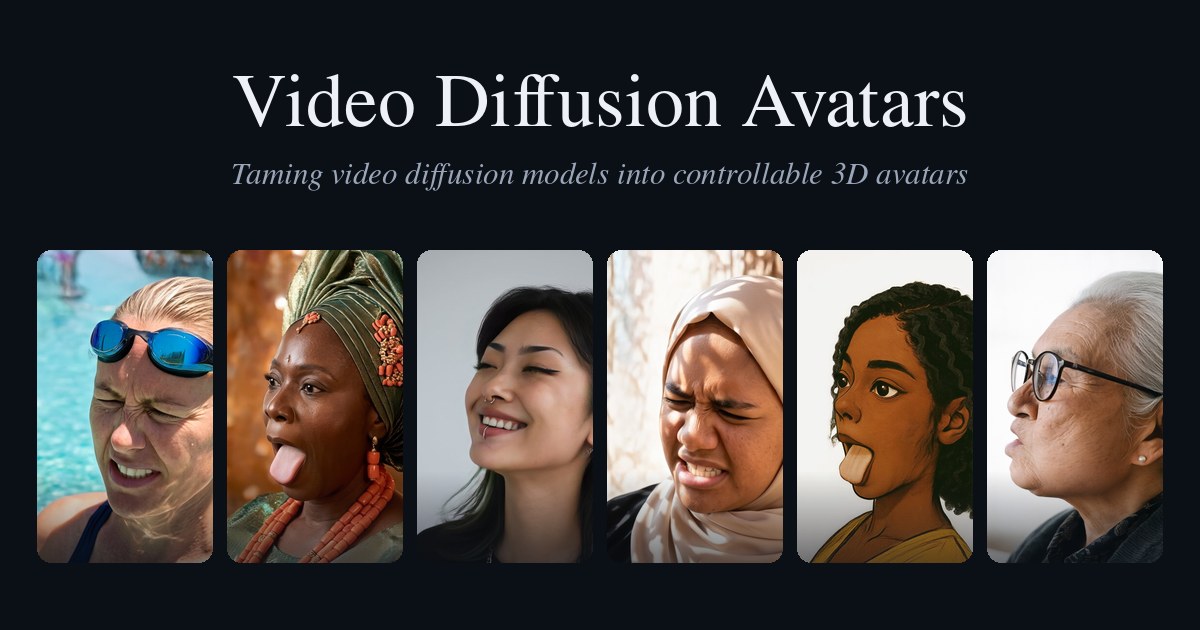
Команда под руководством Маттиаса Несснера из TU Munich выпустила Video Diffusion Avatars — метод, который превращает видео-диффузионную модель WAN2.2-Animate-14B в управляемый 3D-аватар по одной фотографии. Дорогая часть работы, понимание реального мира, уже встроена в предобученную диффузионную модель, поэтому адаптация свелась к относительно дешёвому дообучению, а аватар получил раздельные каналы управления камерой, мимикой и позой корпуса. Код и веса уже опубликованы, правда, только под некоммерческой лицензией CC BY-NC-SA 4.0.

Что произошло
Группа Маттиаса Несснера в TU Munich опубликовала проект Video Diffusion Avatars, сопроводив его статьёй на arXiv с номером 2610.23772, кодом на GitHub и весами модели. Метод дообучает видео-диффузионную модель WAN2.2-Animate-14B в управляемый 3D-аватар, который строится по одному фото; поверх базовой модели обучается адаптер объёмом около 6.5 ГБ, на что ушло 34 часа машинного времени на одной A100. У аватара три независимых канала управления: траектория камеры задаётся любой орбитой вокруг головы вплоть до полного облёта, мимика, включая язык и рот, передаётся через view-disentangled коды X-NeMo, отдельно управляется поза верхней части тела. Результаты измерены на бенчмарке BecomingLit: против лучших single-image 3D-аватаров метод снижает face LPIPS на 29% и повышает JOD на 66%. Дистиллированная 4-шаговая fast-версия стримит видео произвольной длины на KV-кэше, выдавая порядка 3.5 кадров в секунду при разрешении 288x512 на A100 и удерживая более 3000 кадров без распада.
Контекст
Управляемых 3D-аватаров до сих пор собирали на явных представлениях: пайплайны на базе 3DMM и NeRF требуют отдельно моделировать свет, волосы и прочую физику. Видео-диффузионные модели устроены иначе: они заранее обучены на огромных объёмах реального видео и сами генерируют тени, отражения, преломления и динамику волос, то есть эффекты, недоступные явным 3D-рендерерам. VDA демонстрирует сдвиг парадигмы: вместо строительства явного 3D-представления готовую видео-диффузию «приручают», заставляя её слушать внешние сигналы управления, пока внешность и физика остаются на совести самой диффузии. Техническая причина, почему простое дообучение напрямую не сработало бы: выученные коды мимики сильно зависят от ракурса, и без компенсации аватар «ехал» бы вместе с камерой. Отсюда главная обучающая идея проекта, camera-triplet: один и тот же момент времени показывается модели с трёх камер, что учит её мыслить головой в 3D и согласовывать выражения между видами.
Почему это важно для индустрии
Меняется экономика кастомизации: дорогой мировой визуальный prior оплачен предобучением WAN2.2-Animate-14B, а специализация под персонажа обходится в десятки часов GPU-времени и один адаптер, если эти цифры воспроизводятся. Тогда создание аватара превращается из проекта по строительству отдельного 3D-пайплайна в недорогое дообучение поверх готовой видео-диффузии. Сам приём camera-triplet не архитектурный и переиспользуемый: мульти-видовое согласование одного момента можно переносить на другие управляемые дообучения видео-диффузии, например на тела, сцены и мульти-персонажные сцены. Для команд, строящих виртуальных спикеров, VFX или виртуальные аватары, это путь к консистентным мульти-видео персонажам с тремя «ручками» вместо классического 3D-рига. Сама возможность потокового вывода длинных роликов без распада качества — аргумент, что трансформерные видео-диффузионные модели можно делать стриминговыми без явной 3D-репрезентации, а вероятная волна производных работ — hosted-API, дистилляции под более доступные GPU и интеграции управляющих кодов с голосовыми пайплайнами.
Почему это важно для пользователей
Практическая ценность для читателя: персонаж собирается из одной фотографии, и работает это даже с нарисованными героями, а камерой, лицом и корпусом можно управлять независимо, как режиссёр, а не как 3D-моделлер. Попробовать можно уже сейчас: код и веса открыты, окружение разворачивается примерно за 30 минут, но понадобится около 65 ГБ на диске, GPU с 48–80 ГБ видеопамяти класса A100 или H100 и бесплатный аккаунт FLAME. С таким порогом команда за несколько дней соберёт некоммерческое демо: previz-ролик, проверку аватара по фото или собственный пайплайн от фотографии до управляемой видео-сессии. Некоммерческая лицензия CC BY-NC-SA 4.0 означает, что коммерческое использование пока запрещено, поэтому для широкой публики это исследовательский проект, а не готовый сервис.
Что пока неизвестно / ограничения
Отрыв на BecomingLit стоит читать с осторожностью: face LPIPS и JOD — перцептивные метрики, а бенчмарк один, поэтому часть преимущества может объясняться благоприятностью диффузионных текстур для этих метрик, а не геометрической согласованностью аватаров, и нужна проверка на других данных. Прямого сравнения с классическими пайплайнами 3DMM, NeRF и 3DGS на их сильных сценариях, стабильности геометрии и идентичности между ракурсами, в материале нет, поэтому тезис о том, что VDA уже обесценивает явную графику аватаров, преждевременен. Продуктовых гарантий тоже нет: research-код не имеет API, прайсинга и SLA, а вопрос реального времени не решён. Открытыми остаются вопросы, воспроизводятся ли цифры адаптации на других базовых VDM, догонит ли скорость живые сценарии и останутся ли такие avatar-адаптеры отдельным классом моделей или будут поглощены базовыми диффузионными моделями.
Источники
- Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars (project page)
- Video Diffusion Avatars: Taming Video Diffusion Models into Controllable 3D Avatars (arXiv:2610.23772)
- SimonGiebenhain/video-diffusion-avatars — Official Code (GitHub)
Автор
Look at AI, редакция