🎨 Сбер открыл код Kandinsky Avatar 1.0 для говорящих видеоаватаров
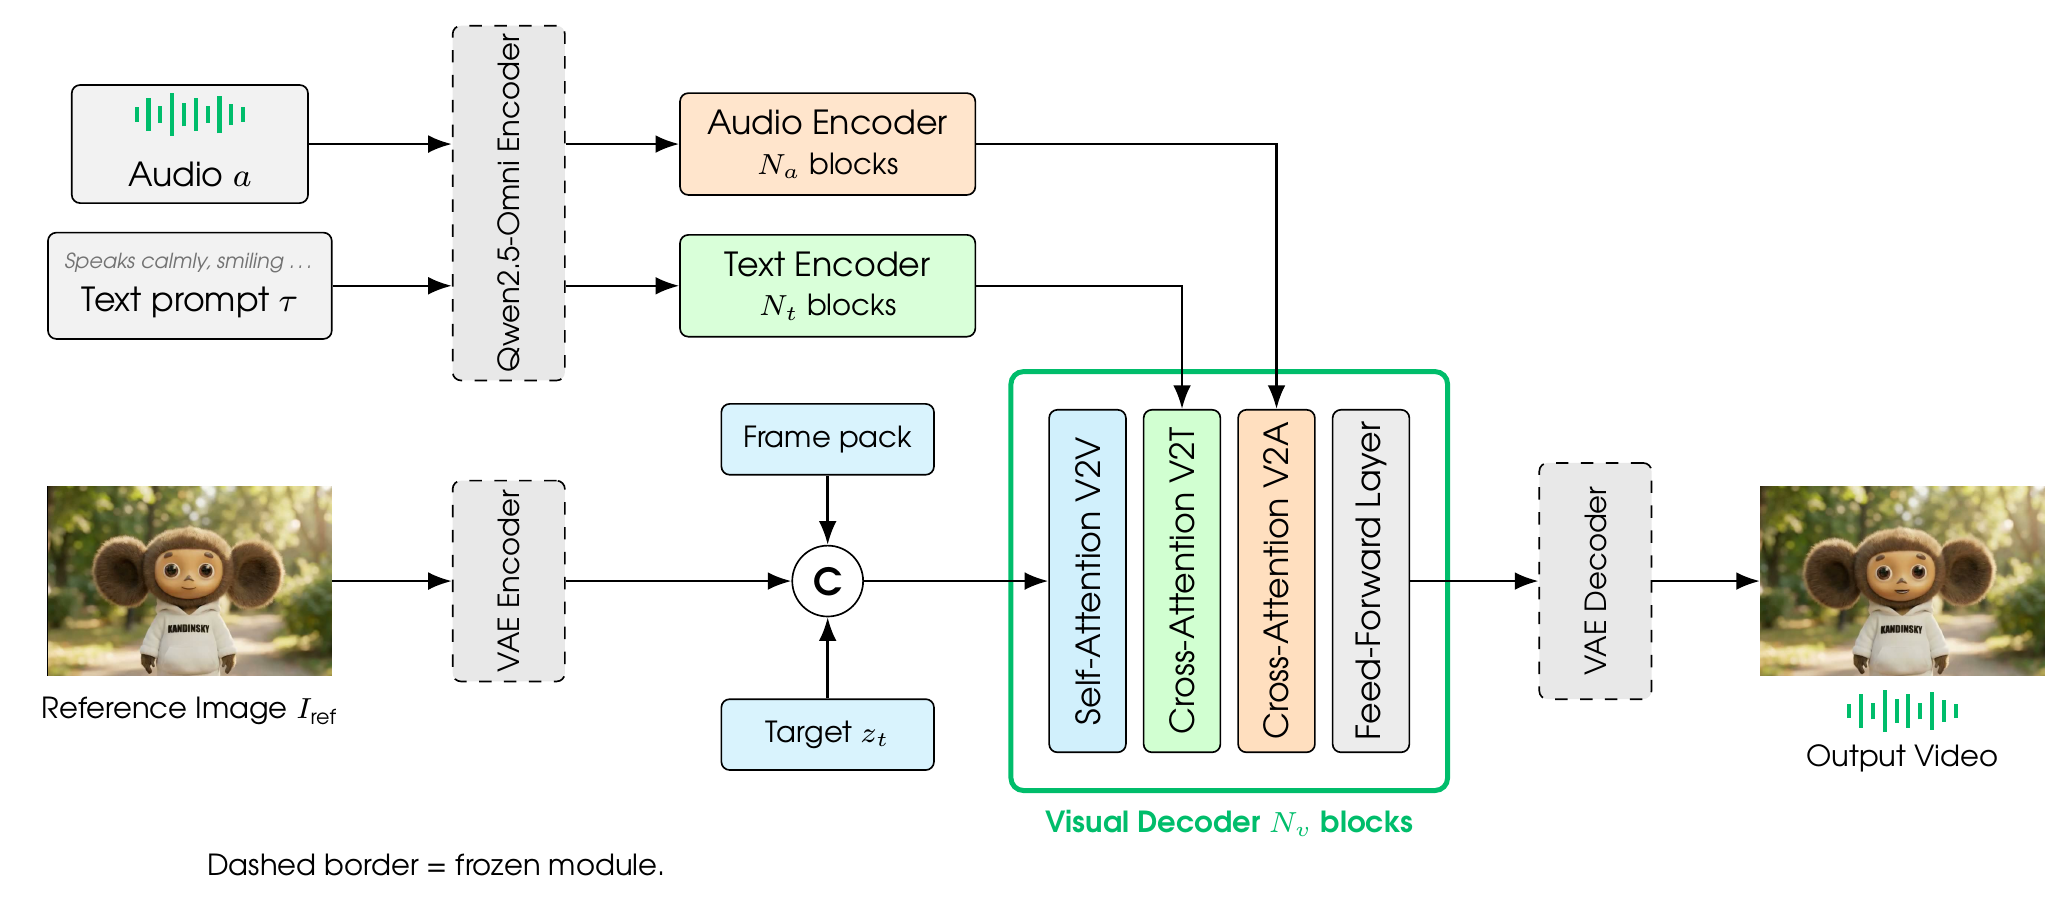
Семейство speech-to-video моделей Kandinsky S2V 1.0 — Lite на 2B и Pro на 21B параметров, плюс быстрые π-Flow версии — выпущено под MIT: открыты код и веса. Из одного кадра-референса, аудио и текста модель генерирует видео 25 FPS, где артикуляция, мимика и жесты следуют за речью, а длинные ролики собираются из 5-секундных чанков.
🌍 Открытая MIT-альтернатива HeyGen и похожим сервисам: коммерческое использование разрешено — виртуальные консультанты, обучение, локализация. По собственным слепым оценкам Сбера Pro сопоставим с двумя коммерческими моделями и лидирует по липсинку.
👤 Демо доступно без установки в Hugging Face Space Kandinsky-S2V-1.0-Demo; для локального запуска нужен NVIDIA GPU с 48–80 GB VRAM.
Источник 1: https://kandinskyavatar.github.io/ Источник 2: https://github.com/kandinskylab/kandinsky-s2v