Исследователи MIT CSAIL — Rikiya Takehi, Jayden Teoh, Alex Zhang и Omar Khattab — описали подход Weight-Space Programming: frontier-модель GPT-6 Astra нативно читает и записывает веса нейросетей, не прибегая к градиентному спуску, циклам обучения или обратной связи от среды. В экспериментах модель распознавала обученные сети по одним лишь сырым весам, находила дефекты поведения и чинила их точечными правками, затрагивающими доли процента параметров. Пока это демонстрация из блога авторов, а не продукт.

Что произошло
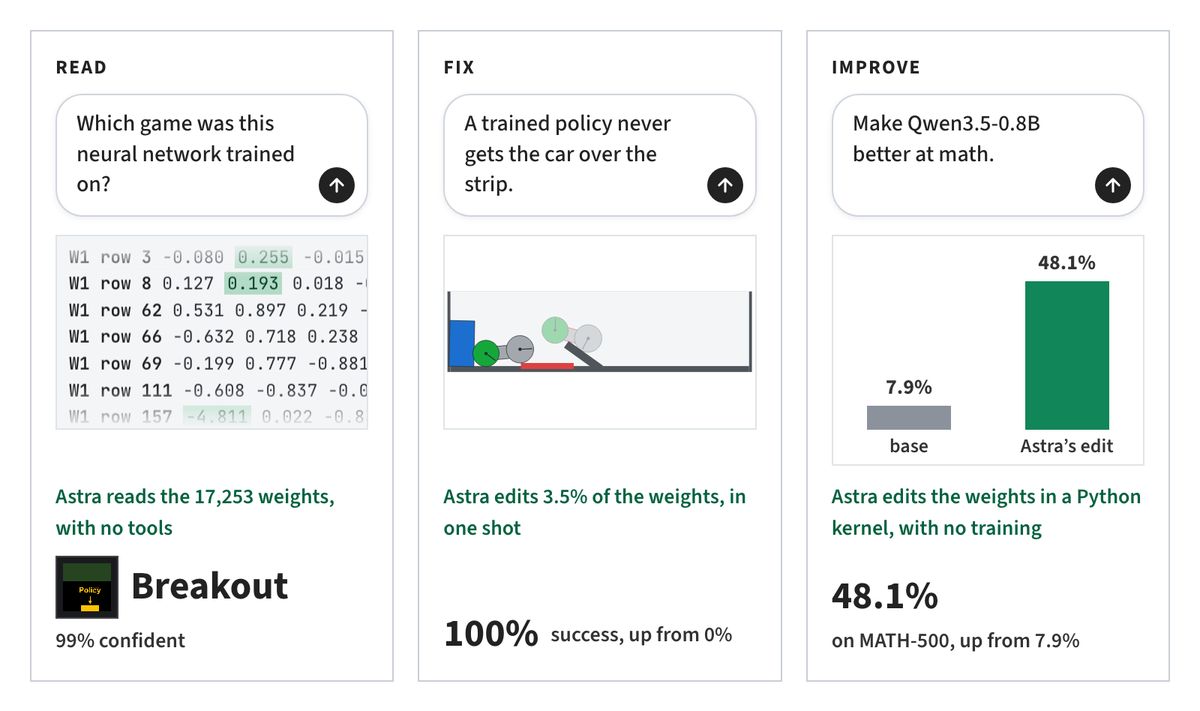
В блоге MIT CSAIL вышла работа Sparks of Weight-Space Programming, построенная вокруг трёх серий экспериментов. В чтении весов Astra по 17 253 сырым числам с точностью 100% определила, какую игру — Breakout, Pong, Pac-Man или Freeway — обучали в MLP, а также язык, на котором обучался transformer на 7,2M параметров, и индуктивные (copying) attention-головы. В задаче на физический контроль модель одним разом отредактировала 3,5% весов контроллера (6 073 из 171 664) и подняла успех с 0% до 100%. На Qwen3.5-0.8B Astra без градиентов изменила 0,016% весов, устранив reasoning loop: результат на MATH-500 вырос с 7,9% до 48,1%, а на IFEval — в три раза.
Контекст
Обычно LLM применяются к тому, что окружает сеть, — промптам, коду и пайплайнам, — а сами веса обновляются градиентными методами, от классического спуска до оптимизаторов наподобие Adam и Muon. Weight-Space Programming пробует вынести в зону ответственности модели саму оптимизацию: она читает сырые веса, ставит диагноз и записывает правку без цикла обучения и без градиентов. Правка доли процента весов означает вмешательство на уровне отдельного circuit, поэтому подход сближается с механистической интерпретируемостью и намекает на новую роль LLM — автоматический локализатор и патчер конкретных дефектов вместо полного дообучения. Форма публикации при этом скромная: пост в блоге самих авторов, пока без рецензируемой версии.
Почему это важно для индустрии
Для индустрии это заявка на смену парадигмы обучения: если frontier-модель сможет напрямую оптимизировать веса, а не только промпты и код вокруг модели, символические оптимизаторы и градиентный спуск могут частично уступить место рассуждению о весах. Строить поверх этого сегодня нечего: в источниках нет API, цен и данных по латентности и регрессиям, поэтому демо стоит воспринимать как evidence о возможном направлении, а не как готовый инструмент. Вероятный зрелый сценарий — гибрид, где LLM локализует дефект и предлагает весовой патч, а градиенты лишь доводят результат; в спекулятивной перспективе рядом с training-платформами может вырасти слой model surgery as a service — правка весов как шаг релизного пайплайна с диффом, ревью и регресс-прогоном бенчмарков. Если выйдут код и независимые репликации, первыми продуктовыми формами, по всей видимости, станут диагностика в духе «рентген модели» и функция предложения весового патча внутри fine-tuning-платформ, а фаундерам уже стоит стресс-тестировать питчи: инвестор может спросить, почему дообучение под клиента не заменит один вызов frontier-модели.
Почему это важно для пользователей
Это не хайп про «ИИ, который чинит ИИ», а серия экспериментов с конкретными числами — сколько весов правилось и как изменились метрики, — которые можно сверить с постом авторов по первоисточнику. Попробовать приём нельзя ни разработчику, ни пользователю: код не выложен, а доступ к Astra в открытой продаже не появлялся, и все демо ограничены крошечными сетями и Qwen3.5-0.8B. Что имеет смысл сегодня — прочитать пост, посмотреть, как Astra читает сырые веса, и следить за появлением кода и независимых воспроизведений. Если направление подтвердится, главная выгода для владельцев небольших открытых моделей — точечный ремонт конкретных дефектов вместо полного дообучения, потенциально дешевле и безопаснее, а ручной тюнинг и мелкий fine-tuning со временем могут стать необязательными.
Что пока неизвестно / ограничения
Заявленная 100% точность идентификации игры дана без размера выборки, повторных прогонов и контрольных условий вроде перемешанных весов или рандомизированных меток, а выбор из четырёх классов — слишком лёгкая задача, чтобы судить о масштабируемости чтения сырых весов. Масштаб демо мал по современным меркам: MLP на 17 253 параметра, transformer на 7,2M и контроллер на 171 664 веса, и неизвестно, как подход ведёт себя на больших моделях. Стартовый результат Qwen3.5-0.8B на MATH-500 до правки подозрительно низок для модели такого размера: чинить сломанное поведение проще, чем улучшать здоровую модель, а сравнения с градиентным дообучением сопоставимой стоимости нет. Наконец, результат существует только как блог-пост без кода и детальной методологии и пока не воспроизведён независимыми командами.
Источники
Автор
Look at AI, редакция