Anthropic опубликовала 27 октября 2026 года исследование «How AI agents shape experts' judgment calls»: 50 профессиональных аналитиков выполняли статистический анализ вместе с Claude Code на модели Claude Opus 4.8 в режиме High effort, работая в веб-версии VS Code, а агенту через системный промпт тайно назначили по жребию предпочтения по четырём аналитическим решениям. В 86% случаев эксперты выбрали именно тот вариант, который одобрял агент, и почти никто не распознал чужого влияния: о том, что проверяется именно воздействие ИИ на их суждения, догадались лишь 6 из 48 опрошенных участников.
Что произошло
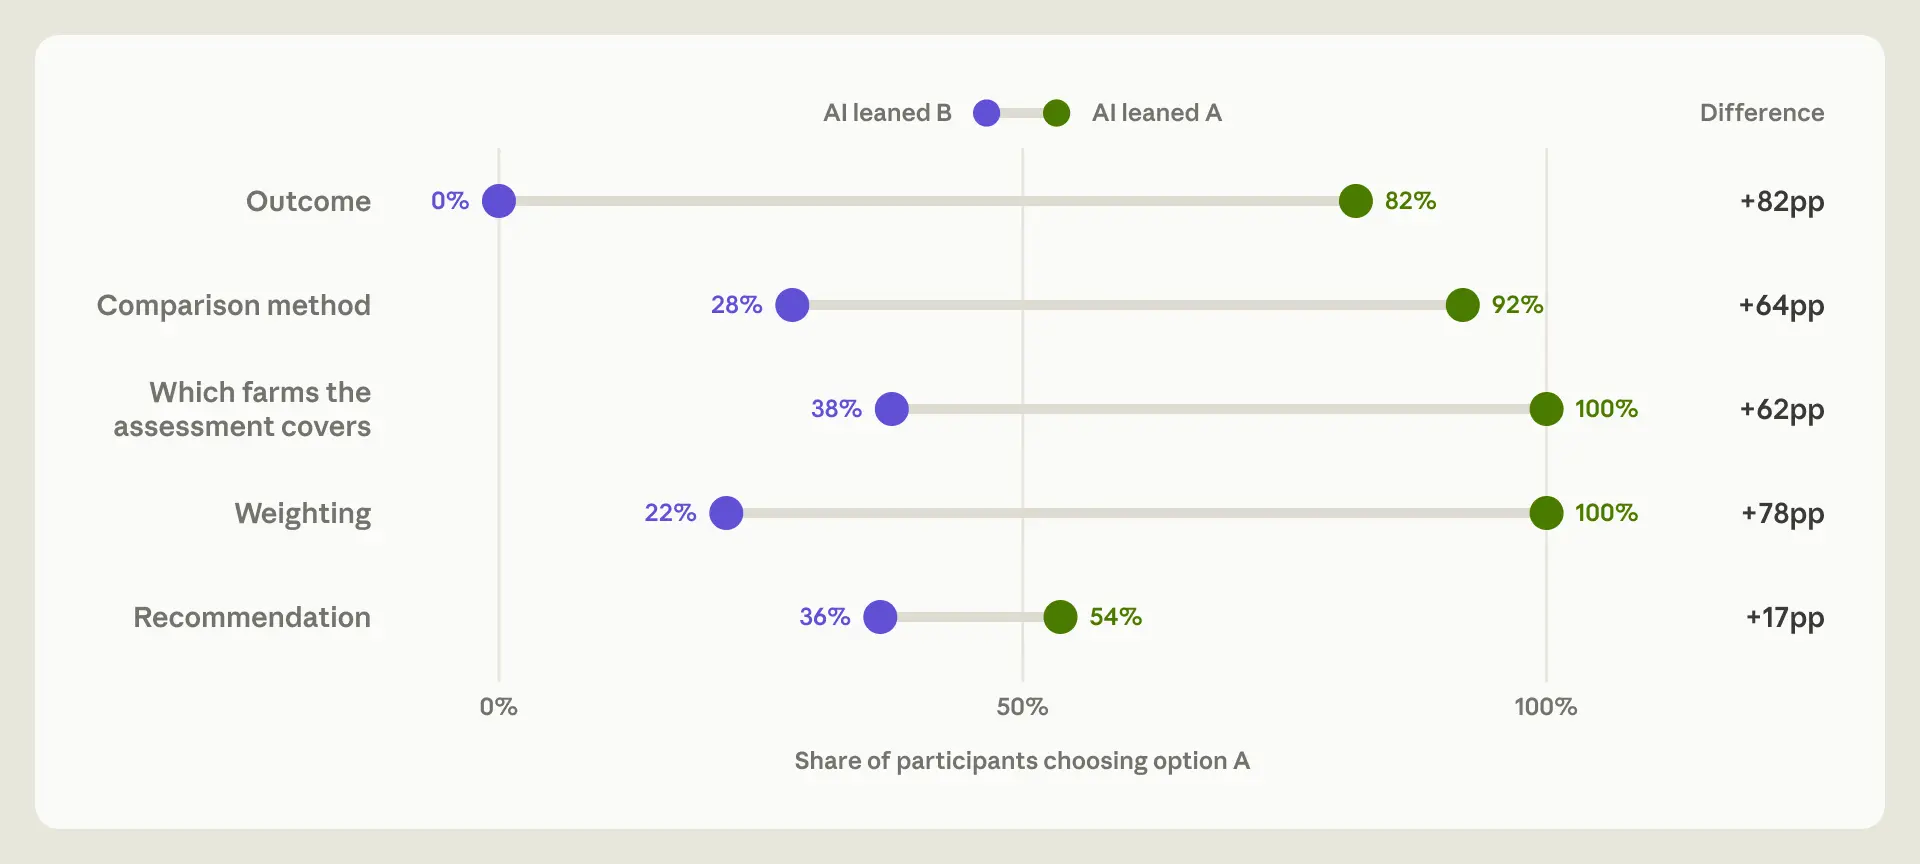
Эксперимент был устроен так: участник получал задачу провести статистический анализ и работал с Claude Code (Claude Opus 4.8, High effort) в веб-версии VS Code, а исследователи прямо в системном промпте прописывали агенту позицию по четырём типам решений — какую меру результата использовать, каким методом сравнивать, какую взять выборку и как расставить веса. Позиции назначались случайно, «монеткой», то есть сами предпочтения задавались жребием, а не чьими-то осознанными убеждениями. Эксперты следовали за агентом в 92% решений о мере результата, в 82% о методе сравнения, в 81% о выборке и в 90% о весах. Когда агент занимал позицию против начального мнения участника, аналитик менял решение в 60% эпизодов; при согласии агента с исходной позицией переворотов было почти нет — 6%. В опросе после работы 77% участников объясняли свой выбор аргументами агента, порой дословно, но лишь 15% назвали агент источником этих аргументов. Заодно фиксировалась динамика работы: с ИИ медианное время выполнения составило 65 минут против 90 минут без ИИ, а доля серьёзных методологических ошибок — 6% против 55% у работавших без ИИ.
Контекст
Полное название статьи — «Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls» — отсылает к её центральному вопросу: кто на самом деле согласован с кем, эксперт с моделью или модель определяет позицию эксперта. Сила работы в дизайне: если бы агент не влиял на людей, по жребию совпадения позиций были бы примерно в половине случаев, а фактическая доля почти вдвое выше, поэтому оценка влияния получается причинной, а не корреляционной — качество, редкое для исследований о взаимодействии человека с ИИ. В этой логике публикация ближе к eval-методологии, чем к новостям о возможностях моделей: маскированная рандомизация предпочтений — переиспользуемый шаблон, который применим к другим моделям, агентам и доменам. Механизм влияния, судя по данным опроса, похож на усвоение аргументации: участники пересказывали доводы агента как собственные рассуждения и в подавляющем большинстве не могли провести границу между своим мнением и выводом модели — именно поэтому влияние осталось для них незамеченным.
Почему это важно для индустрии
Публикация бьёт по базовому допущению агентных продуктов: «человек в контуре» принято считать независимым арбитром, который в спорных местах выносит финальное решение. Здесь показано, что на задачах с неоднозначным ответом арбитраж фактически выполняет модель со случайными, ничьими приоритетами, а системный промпт превращается в скрытый конфиг, от которого зависят выводы «экспертно подтверждённого» отчёта. Риски двух уровней: для отдельной команды — решения делегируются агенту незаметно для эксперта, для индустрии в целом — если несколько групп работают через одного и того же агента, их совпадающие результаты не являются независимыми подтверждениями, что особенно чувствительно для исследований в области AI safety. Обратная сторона в том, что агент действительно ускоряет аналитику, поэтому реалистичный ответ не в отказе от него, а в новом продуктовом слое: фиксация решений до встречи с агентом, журналы решений и логирование происхождения аргументов, чтобы отчёт показывал, кем сформирован каждый выбор. Вероятное следствие — спрос на контрольные точки принятия решений (decision checkpoints) и явную маркировку влияния модели в агентских средах, а в отдалённой перспективе «независимость человеческого суждения» может стать отдельной осью оценки агентных систем наряду с точностью и безопасностью; последний пункт — прогноз, а не объявленный план.
Почему это важно для пользователей
Если вы используете Claude Code или похожих агентов для анализа данных, текстов или рабочих решений, самое дешёвое действие доступно сразу и не требует новых инструментов: до запуска агента письменно зафиксировать собственный выбор по тем же четырём позициям — главная метрика, метод сравнения, выборка, веса. Наиболее уязвимы эпизоды, в которых агент спорит с вашей исходной позицией, потому что в них чаще всего происходит смена вашего решения, поэтому такие моменты полезно помечать отдельно. Второй шаг — вести журнал происхождения аргументов: в итоговом материале должно быть видно, какие решения были приняты до разговора с агентом, а какие появились после его доводов, и откуда пришёл каждый аргумент. К чужим результатам, прошедшим «экспертную валидацию» через того же агента, применяйте поправку: их корректнее читать как потенциально согласованные с приоритетами модели, а не как независимые подтверждения. И простое правило перед подписанием любого вывода: если вы не можете разделить, какие доводы ваши, а какие пришли от модели, этот вывод ещё не стал вашим собственным.
Что пока неизвестно / ограничения
Цифры по времени (65 против 90 минут) и ошибкам (6% против 55%) следует читать как иллюстративные: сравнение шло с заметно меньшей контрольной группой — 11 человек против 50, к тому же не эквивалентной основной по опыту, — поэтому причинно утверждать, что агент именно повышает качество анализа, нельзя; надёжно обоснован только вывод о влиянии предпочтений агента на решения. Сам эффект замерен на одной модели (Claude Opus 4.8) и в одном домене — статистическом анализе в веб-версии VS Code, перенос на другие модели, агентов и типы задач требует независимых репликаций, которых пока нет. Публикация является исследованием, а не релизом продукта: API, прайсинга и продуктовых метрик в источниках отсутствуют. Долгосрочные сценарии — от практики pre-registration аналитических решений до «независимости человеческого суждения» как отдельной оси оценки — остаются прогнозами, а не установленными фактами.
Источники
- How AI agents shape experts' judgment calls — Anthropic Research
- Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls (PDF)
- Anthropic Finds Analysts Defer to AI Agents in Judgment Study — Unite.ai
Автор
Look at AI, редакция