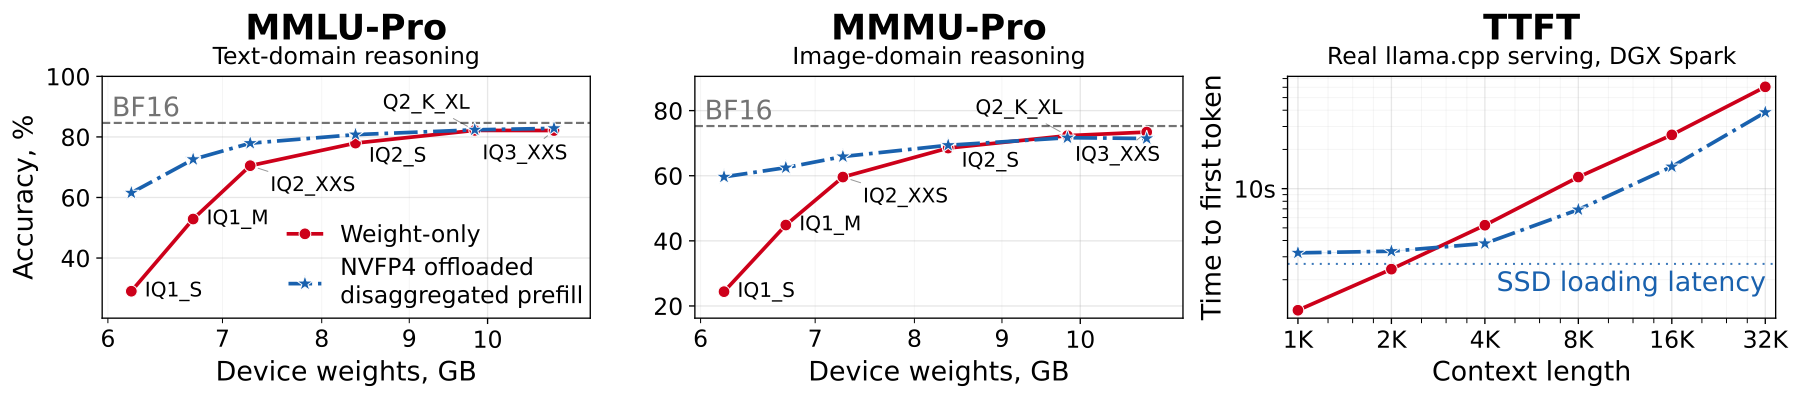
Команда IST-DASLab (Andrei Panferov, Maximilian Kleinegger, Sweta Priyadarshi, Tijmen Blankevoort, Dan Alistarh) в статье «Disaggregated Quantization: Specializing LLM Prefill and Decode» (arXiv 2609.26333, 22 сентября 2026) предлагает обрабатывать префилл и декод LLM разными квантизациями одной модели и дообучать обе ветви совместно методом QADD. Такой разнос фаз по форматам возвращает значимую часть точности, потерянной при агрессивном сжатии весов, и не требует менять готовый декод-чекпоинт. Подход уже воспроизводим поверх популярных инференс-стэков, а готовые чекпоинты выложены для скачивания.


Что произошло
В статье описан метод QADD: маска SFT-токенов задает, какой фазово-специфичный линейный путь обрабатывает каждый токен, поэтому префилл и декод одной модели живут в разных квантизациях и дообучаются совместно. Выделенный NVFP4-префиллер — compute-native формат для GPU Blackwell — обучается поверх замороженного декодера: на Qwen3.8-27B с GGUF-декодером Unsloth IQ1_S точность растет на MMLU-Pro с 29,04% до 61,54% и на MMMU-Pro с 24,39% до 59,65%, при этом декод-чекпоинт остается неизменным. Схема offloaded disaggregated prefill (ODP) стримит дополнительный префилл-чекпоинт объемом 12,8 GiB с SSD через кольцевой буфер, вырезанный из памяти выходной головы, поэтому дополнительная VRAM не нужна вовсе. В кастомной интеграции llama.cpp на DGX Spark TTFT на 8K-контексте падает с 12,27 до 6,90 с; метод включается одним флагом в llama.cpp и валидирован в disaggregated-сервинге vLLM.
Контекст
Инференс LLM структурно асимметричен, и метод бьет точно в эту асимметрию. Префилл — compute-bound фаза, которая выигрывает от compute-native форматов вроде NVFP4, созданных под тензоры GPU Blackwell; декод — memory-bound фаза, где выигрывают ультранизкобитные GGUF-веса, экономящие память. Дефолтная же практика была иной: одна квантизация на весь запуск, из-за чего агрессивное сжатие весов било по качеству и на длинных промптах, и на генерации. Дообучение методом QADD возвращает примерно половину точности, потерянной при таком сжатии, без переписывания готовых декодеров — по сути это продолжение уже нормализовавшейся в отрасли дезагрегации ролей в сервинге, только спущенное на уровень весовых форматов.
Почему это важно для индустрии
Инференс перестает быть «одной квантизацией на весь запуск»: compute-bound префилл остается в аппаратно-нативном NVFP4, а memory-bound декод — в ультранизкобитных GGUF, и это воспроизводимый слой поверх существующих стэков, а не теория. Числа тоже промышленные: на декоде в 2 бита полная дезагрегация превышает weight-only-бейзлайны на 7,1 и 4,5 пункта (Qwen 3 и Gemma 3) на decode-heavy задачах и на 12,6 и 8,9 пункта на prefill-heavy RULER. Экономика локального инференса меняется: качество, близкое к полноразмерной модели на длинных промптах, достигается без роста VRAM и без правки готовых декодеров, а PTQ-дезагрегация уже подтверждена на моделях до 2,8 трлн параметров. Если линия подтвердится, «квантизация» как единый параметр развертывания распадется на фазово-специфичные профили: compute-native форматы для compute-bound фаз, ультранизкобитные весовые — для memory-bound.
Почему это важно для пользователей
На одном consumer-GPU Blackwell (RTX 50-й серии или DGX Spark GB10) можно уже сегодня скачать готовые 1-2-битные GGUF Qwen3.8-27B и подключить NVFP4-префиллер с Hugging Face, включив флаг --odp-blocks в llama.cpp. Память GPU остается на уровне декод-чекпоинта, точность на длинных промптах ощутимо растет относительно чистого ультранизкобитного декода, а TTFT на 8K-контексте падает примерно вдвое. Нюансы, которые честно раскрывает карточка модели: релизные llama.cpp-ядра дают около 1,3× ускорения, а короткие промпты остаются медленнее из-за загрузки префилл-чекпоинта с SSD. Минимальный сценарий первого дня — локальный ассистент, работающий с длинными документами на десктопном железе.
Что пока неизвестно / ограничения
Сравнения с полноразмерной Qwen3.8-27B в предоставленных данных нет, поэтому формулировка «почти как у полноразмерной модели» — экстраполяция; измеренный прирост получен относительно декодера Unsloth IQ1_S. Заявленный диапазон ускорения 1,38–1,78× относится к контекстам 4K–32K, при этом 1,78× достигается только на еще не выпущенной FlashInfer-интеграции, а релизные llama.cpp-ядра дают около 1,3×; текущая интеграция llama.cpp — кастомная, а не мейнстрим. Схема зависит от скорости и стабильности подсистемы SSD, короткие промпты остаются медленнее из-за стриминга префилл-чекпоинта. Полная дезагрегация с QADD пока показана на Qwen 3 и Gemma 3, а готовые префиллеры покрывают ограниченный набор GGUF-декодеров (среди них IQ1_S и IQ1_M), поэтому распространение на другие семейства моделей — вопрос будущего.
Источники
- Disaggregated Quantization: Specializing LLM Prefill and Decode (arXiv 2609.26333)
- IST-DASLab/disaggregated-quantization — официальная кодовая база (GitHub)
- ISTA-DASLab/Qwen3.8-27B-NVFP4-prefiller — префиллеры для GGUF-декодеров (Hugging Face)
Автор
Look at AI, редакция