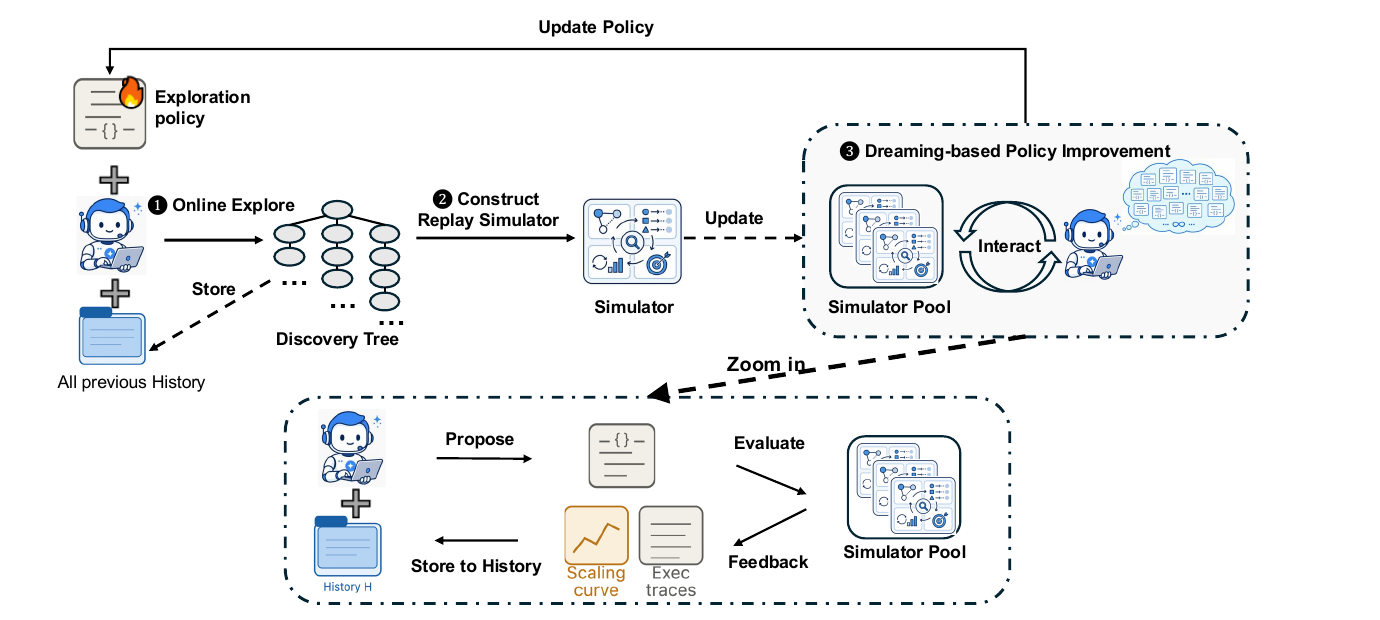
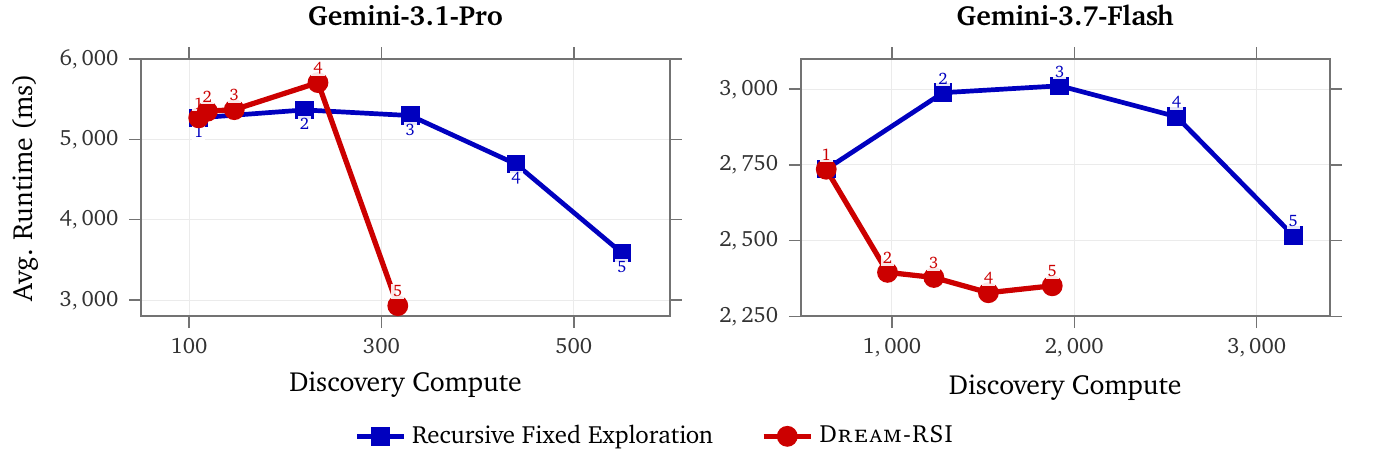
Google совместно с Google DeepMind, Университетом Мэриленда и Университетом Виргинии опубликовала препринт Dream-RSI: Recursive Self-Improvement through Evolving Worlds (arXiv:2609.14858) и страницу проекта с интерактивной демонстрацией. Метод хранит историю прошлых запусков поискового агента в виде дерева попыток и переигрывает её как точный симулятор: тысячи альтернативных стратегий исследования оцениваются офлайн, без единого нового вызова агента. Отдельный LLM-агент при этом переписывает только код стратегии — модель, агент и оценщик остаются неизменными. На Gemini 3.1 Pro это ускорило решение задачи Lasso с 3587 до 2931 мс при 317 вызовах агента вместо 550. До выпуска кода материал остаётся препринтом: репозиторий заявлен, но сам код пока в подготовке к релизу.
Что произошло
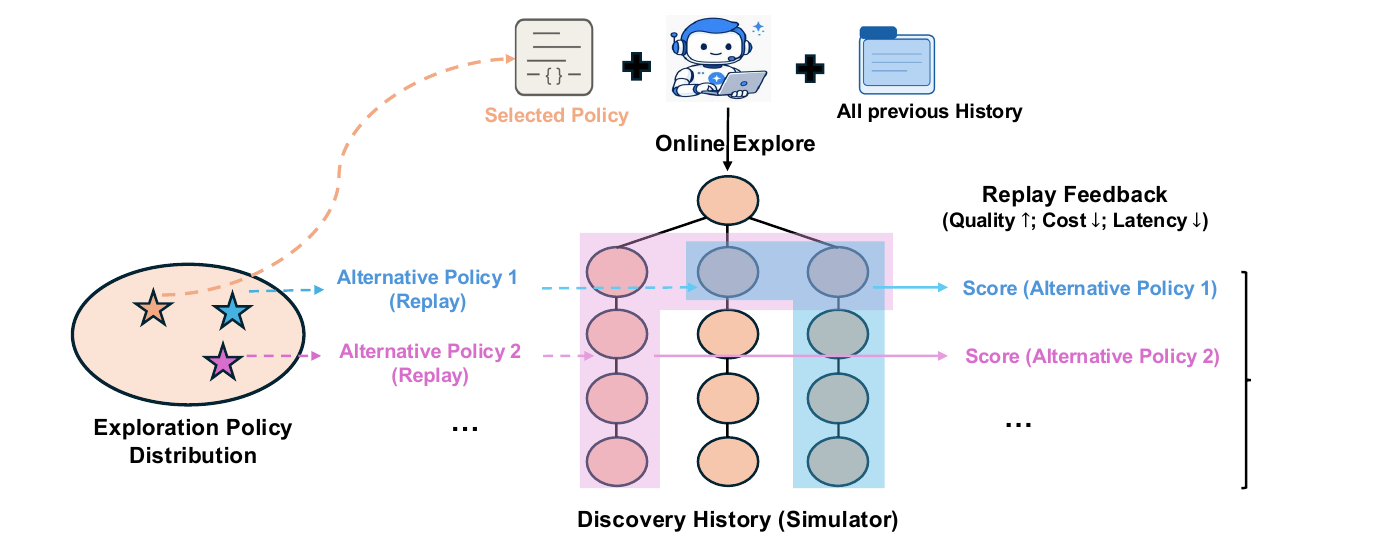
Суть метода: история прошлых запусков поискового агента сохраняется как дерево попыток, где каждый узел — это версия решения, её диагностика и оценка, а всё дерево работает как точный симулятор-реплей. На нём без единого нового вызова агента прогоняются тысячи альтернативных стратегий исследования — с другим порядком ветвей, разной степенью параллелизма и другими точками остановки. Отдельный LLM-агент многократно переписывает код стратегии, каждая версия оценивается на всех накопленных деревьях, и поскольку текущая стратегия тоже участвует в отборе, новая гарантированно не хуже старой. Модель, сам агент и оценщик при этом не меняются. В экспериментах на Gemini 3.1 Pro версия с Dream-RSI ускорила решение Lasso с 3587 до 2931 мс при 317 вызовах агента вместо 550; базовая скорость VGG16 и LayerNorm из KernelBench была достигнута за 2,43 и 1,79 раза меньше попыток; для связок свёртка+деление и свёртка+max найден код быстрее базового — в 2,09 раза в первом случае. Репозиторий zhengkid/Dream-RSI анонсирован, но код пока готовится к релизу.
Контекст
Метод закрывает узкое место мета-уровня в агентном поиске. Чтобы проверить, действительно ли новая стратегия исследования лучше прежней, обычно требуется прогнать весь цикл открытий заново, и такая обратная связь стоит столько же, сколько само исследование. Dream-RSI строится на наблюдении, что журналы уже выполненных запусков содержат всё необходимое для дешёвой проверки: если записывать не только итог, но и каждую попытку с диагностикой и оценкой, их можно переигрывать как детерминированный симулятор. Авторы называют это «сновидением» агента — мир не запускается заново, а воспроизводится из записанных ветвей, отсюда Evolving Worlds в названии работы. Такой подход смещает и сам спор о recursive self-improvement: совершенствуется не набор весов модели, а стратегия поведения поверх зафиксированной модели. В этой оптике журналы запусков агентного поиска оказываются недооценённым активом, который можно превратить в точный офлайн-симулятор и оптимизировать на нём стратегию тысячами прогонов.
Почему это важно для индустрии
Для отрасли главный сдвиг — экономический. Обратная связь мета-уровня обычно требует повторного прогона всего цикла открытий, и именно это делает рекурсивное самоулучшение дорогим; Dream-RSI превращает уже оплаченные журналы запусков в бесплатный точный симулятор, так что один дорогой онлайн-запуск окупает тысячи офлайн-оценок политики. Самая дорогая часть агентного продукта — итерация по оркестрации — резко дешевеет, и преимущество получают команды, которые уже накапливают детальные логи запусков. Поскольку самоулучшается только код стратегии — какие ветви развивать, сколько попыток запускать параллельно, когда останавливаться, — метод остаётся надстройкой поверх неизменных модели, агента и оценщика, а значит потенциально переносим на существующие агентные системы без дообучения базовой модели. Если переносимость подтвердится, паттерн «replay-оптимизации» может стать отдельным слоем агентных стеков: офлайн-оптимизатор стратегий как сервис, replay-модуль в инструментах наблюдаемости агентов или кнопка «улучшить стратегию на моих журналах» в продуктовых ассистентах. Это прогноз, а не зафиксированный факт, и зависит он в том числе от выхода открытого кода.
Почему это важно для пользователей
Для тех, кто строит агентный поиск и работает с test-time compute, метод напрямую бьёт по самой дорогой статье расходов — обратной связи мета-уровня: проверять новые стратегии можно на записанных деревьях попыток, а не новыми вызовами агента. Практическая польза для команд уже сегодня методологическая: стоит начать детерминированно сохранять деревья попыток своих агентов — версию решения, диагностику и оценку, — чтобы к моменту появления открытого кода иметь готовый материал для офлайн-оптимизации, а сам паттерн воспроизводим на собственных логах штатными средствами. Конечным пользователям агентных сервисов выгода придёт позже и опосредованно: если подход приживётся, продукты смогут улучшать стратегию поиска без дообучения модели и находить решения за меньшее число вызовов агента, что со временем оборачивается более быстрой и дешёвой работой сервисов. Пока же это препринт, а не продукт: API и pricing отсутствуют, и пользоваться можно только собственной реализацией паттерна.
Что пока неизвестно / ограничения
Метод существует пока только как препринт: код в репозитории zhengkid/Dream-RSI находится в статусе code release in preparation, API и pricing отсутствуют, независимых репликаций нет, поэтому воспроизвести результаты немедленно нельзя. Гарантия «не хуже» — это гарантия на симуляторе-реплей: она действует по составной метрике — лучший найденный результат, штраф за число попыток, бонус за параллельность — и только внутри записанных ветвей; на живой среде такой гарантии нет, и реплей точен лишь там, где ветви были зафиксированы. Эксперименты показаны на Gemini 3.1 Pro в узких доменах — решателе Lasso и ядрах из KernelBench, — и переносимость метода на другие модели и задачи не подтверждена. Наконец, не раскрыта цена самого мета-цикла: сколько стоят хранение деревьев и офлайн-оценки тысяч стратегий, — это ключевой вопрос для практического внедрения.
Источники
- Dream-RSI: Recursive Self-Improvement through Evolving Worlds — страница проекта с интерактивной демонстрацией
- Dream-RSI: Recursive Self-Improvement through Evolving Worlds — препринт arXiv:2609.14858
- zhengkid/Dream-RSI — официальный репозиторий проекта на GitHub
Автор
Look at AI, редакция