🤖 Префилл и декод LLM — в разных квантизациях
Команда IST-DASLab в статье «Disaggregated Quantization» дообучает одну LLM в двух квантизациях методом QADD: маска SFT-токенов задаёт фазово-специфичный линейный путь для каждого токена.
🌍 Инференс перестаёт быть «одной квантизацией на весь запуск»: compute-bound префилл остаётся в compute-native NVFP4, memory-bound декод — в ультранизкобитном GGUF, а QADD возвращает около половины потерянной точности. Схема встроена в llama.cpp и валидирована в vLLM.
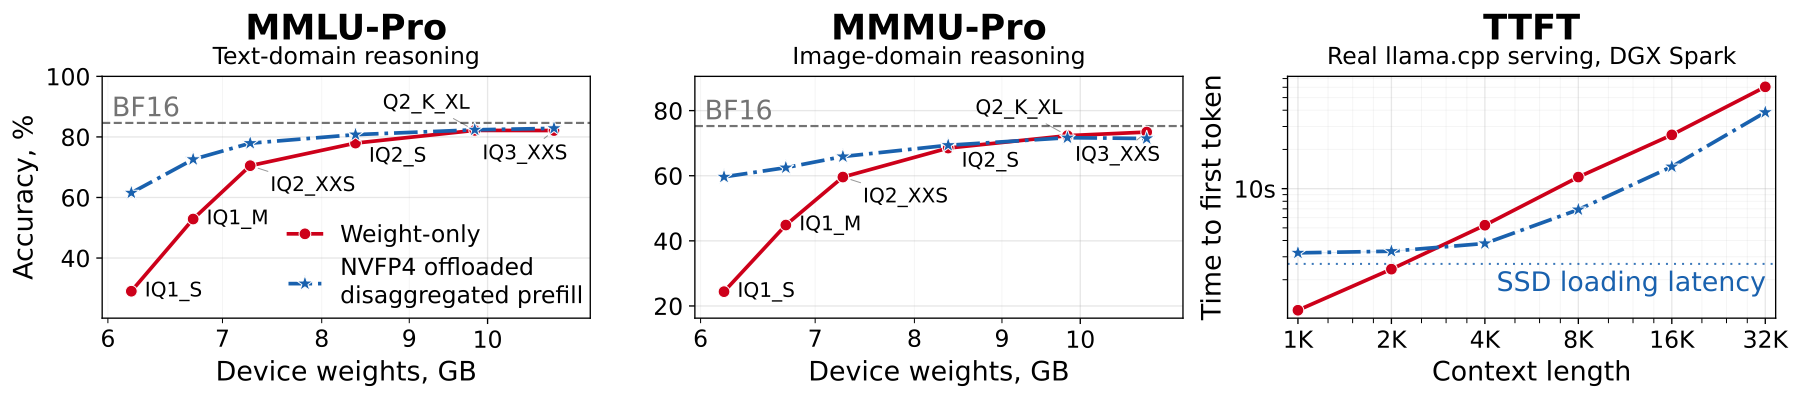
👤 На RTX 50-й серии или DGX Spark GB10 достаточно скачать 1-2-битные GGUF Qwen3.8-27B и подключить NVFP4-префиллер с Hugging Face: MMLU-Pro растёт с 29,04% до 61,54%, MMMU-Pro с 24,39% до 59,65%, память GPU не растёт, а TTFT на 8K (DGX Spark) падает с 12,27 до 6,90 с. Короткие промпты остаются медленнее из-за загрузки с SSD.
Источник 1: https://arxiv.org/abs/2609.26333 Источник 2: https://github.com/IST-DASLab/disaggregated-quantization