Команда OpenBMB (Tsinghua NLP / ModelBest) выпустила MiniCPM5-2B — плотный трансформер на 2B параметров с открытыми весами. По данным модельной карточки, в среднем по 34 бенчмаркам модель обходит соперников из класса 4B и занимает первое место среди открытых моделей до 4B в Artificial Analysis Intelligence Index.

Что произошло
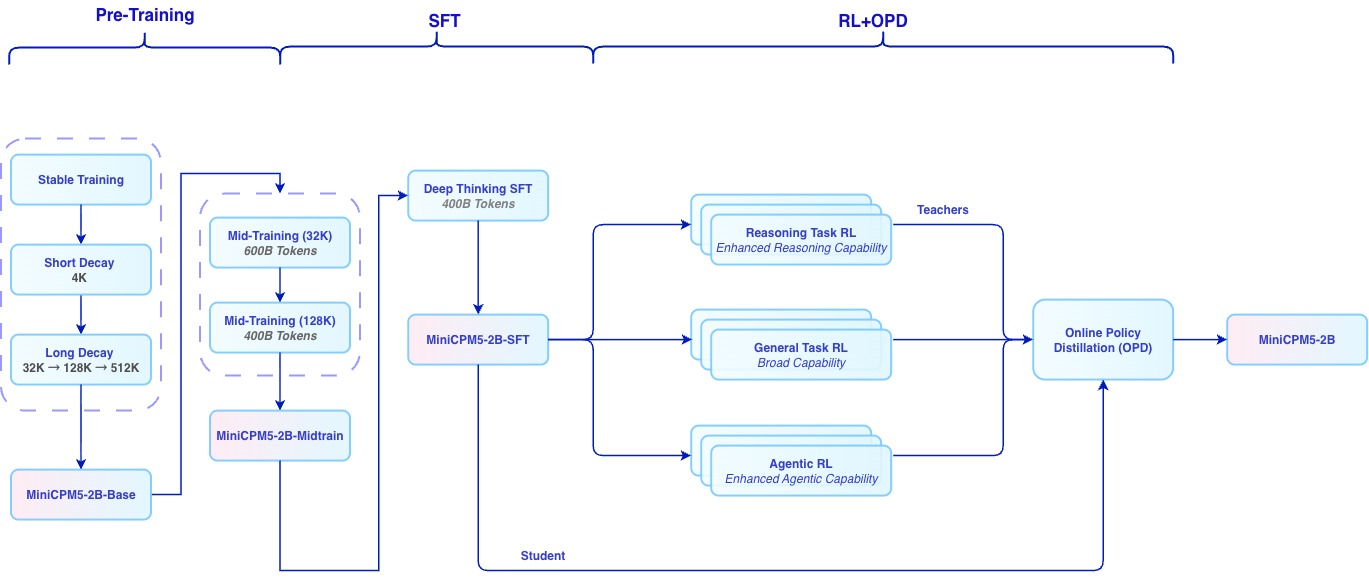
OpenBMB опубликовала MiniCPM5-2B — вторую модель серии MiniCPM5, следующую за MiniCPM5-1B. Релиз выполнен в BF16 с пост-тренингом, построенным на RL и OPD (On-Policy Distillation, дистилляция учителей RL в итоговую модель). Модель использует стандартную архитектуру LlamaForCausalLM, поддерживает нативный контекст 131 072 токена и распространяется по лицензии Apache-2.0. Согласно модельной карточке, в сравнении на 34 бенчмарках (код, математика, long context, tool use, агентные задачи) MiniCPM5-2B превосходит всех включённых участников, в том числе модели класса 4B, где максимум у соперников составляет 51.1. Заявлены 86.5 на AIME 2025/2026, 69.1 на LiveCodeBench v6, 46.4 на SWE-bench Verified, 88.7 на GAIA Text-103 и 43.7 на LongBench v2. В Artificial Analysis Intelligence Index модель показала 23 балла Intelligence Index и 20 Agentic Index.
Контекст
Серия MiniCPM от OpenBMB (совместный проект Tsinghua NLP и ModelBest) специализируется на компактных открытых моделях, и MiniCPM5-2B продолжает линию, начатую MiniCPM5-1B. Техническая ставка релиза сделана не на архитектуру — это обычный плотный трансформер в стандарте LlamaForCausalLM без архитектурной новизны, — а на рецепт обучения: SFT на 400B токенов, затем RL и OPD, переносящий эффект учителей RL в компактную итоговую модель. Необычно, что вместе с весами опубликованы полный набор обучающих данных UltraData, training recipes и RL-стек: такой уровень открытости встречается редко и отличает этот релиз от типичных выкладок только весов. На фоне общего смещения рынка к компактным моделям для edge-сценариев выпуск усиливает конкуренцию в классе 2B–4B, куда постепенно уходят локальные и агентные продукты.
Почему это важно для индустрии
Для индустрии релиз задаёт новый ориентир по соотношению качество и размер в классе 2B: компактная модель с агентными показателями уровня 4B-класса открывает дорогу on-device и edge-деплою — локальным ассистентам, кодинг-агентам и tool-use сценариям. Стандартная архитектура LlamaForCausalLM означает загрузку в mainstream-инференс-движки без кастомных ядер, а лицензия Apache-2.0 снимает лицензионные ограничения для коммерческих продуктов. Открытые данные UltraData и training recipes снижают себестоимость входа: команды получают воспроизводимый baseline и третий путь между дообучением чужой модели и платным API — сборку собственной edge-модели на открытой базе. Если независимые оценки подтвердят заявленные цифры, опубликованный pipeline станет эталонной точкой воспроизведения для edge-моделей и спровоцирует волну дистилляций и дообучений в классе 1B–4B.
Почему это важно для пользователей
Читатели могут уже сегодня скачать веса с Hugging Face (openbmb/MiniCPM5-2B) или ModelScope, попробовать модель в онлайн-демо openbmb/MiniCPM5-2B-Demo и запустить локально через любой инференс-движок с поддержкой Llama-архитектуры: BF16-веса по инженерной оценке занимают около 4 ГБ и помещаются на одну потребительскую видеокарту. На практике это возможность держать приватного ассистента с длинным контекстом, работающего офлайн и не отправляющего данные в облако. Заявленный уровень в коде, математике и агентных задачах делает модель кандидатом для пилота локального кодинг-ассистента, tool-use агента или long-context RAG-модуля — при условии самостоятельной проверки на собственных задачах.
Что пока неизвестно / ограничения
Все бенчмаркные цифры взяты из модельной карточки вендора: протокол оценок (pass@k, число сэмплов, промпты, seed) не раскрыт, независимых подтверждений пока нет. Заявка на первое место в Artificial Analysis Intelligence Index опирается на лидерборд стороннего провайдера, приведённый через карточку без ссылки на отдельный независимый замер. Детали метода OPD представлены только картинкой training recipe — без формализации и абляций. Данных о latency, throughput и стоимости продакшен-сервинга нет, поэтому capacity planning пока невозможен. Наконец, 46.4 на SWE-bench Verified — сильный прототипный уровень, а не подтверждённая автономная способность: статус полноценного кодинг-агента пока не доказан, и ни один источник не называет модель первой открытой 2B-моделью в своём роде.
Источники
- openbmb/MiniCPM5-2B — официальная модельная карточка (Hugging Face)
- OpenBMB/MiniCPM — официальный GitHub-репозиторий
- MiniCPM5-2B — ModelScope (OpenBMB)
Автор
Look at AI, редакция