💻 В ComfyUI v0.45.0 локальные модели Qwen3.x генерируют до двух раз быстрее
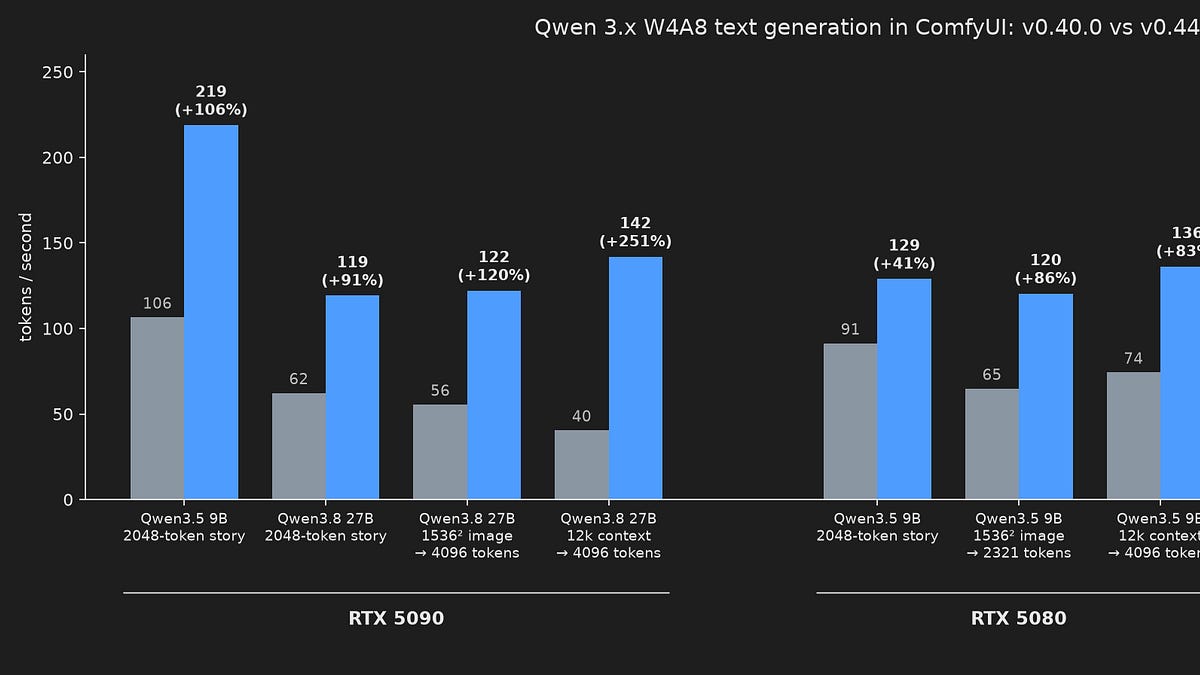
Команда переписала горячий путь генерации: оптимизированный GEMV-кернел, Tree MTP с догадками деревом до 7 токенов и INT8-внимание через --use-ck-attention, которое сжимает KV-кэш и ускоряет pre-fill. На RTX 5090 Qwen3.5 9B теперь 219 токенов/с вместо 106, а Qwen3.8 27B — 122 вместо 55.
🌍 Узкое место локального инференса — не вычисления, а пропускная способность видеопамяти: каждый токен требует полного чтения весов модели. Оптимизация именно этого слоя удваивает скорость на потребительских GPU и снижает время и стоимость локальной генерации текста.
👤 Обновитесь до v0.45.0 и включите mtp=auto в Text Generate node — скорость вырастет до двух раз, качество, по заявлению команды, не меняется. Работает на NVIDIA и AMD, Windows и Linux, пересобирать ничего не нужно.
Источник 1: https://blog.comfy.org/p/doubling-llm-token-rates-in-comfyui