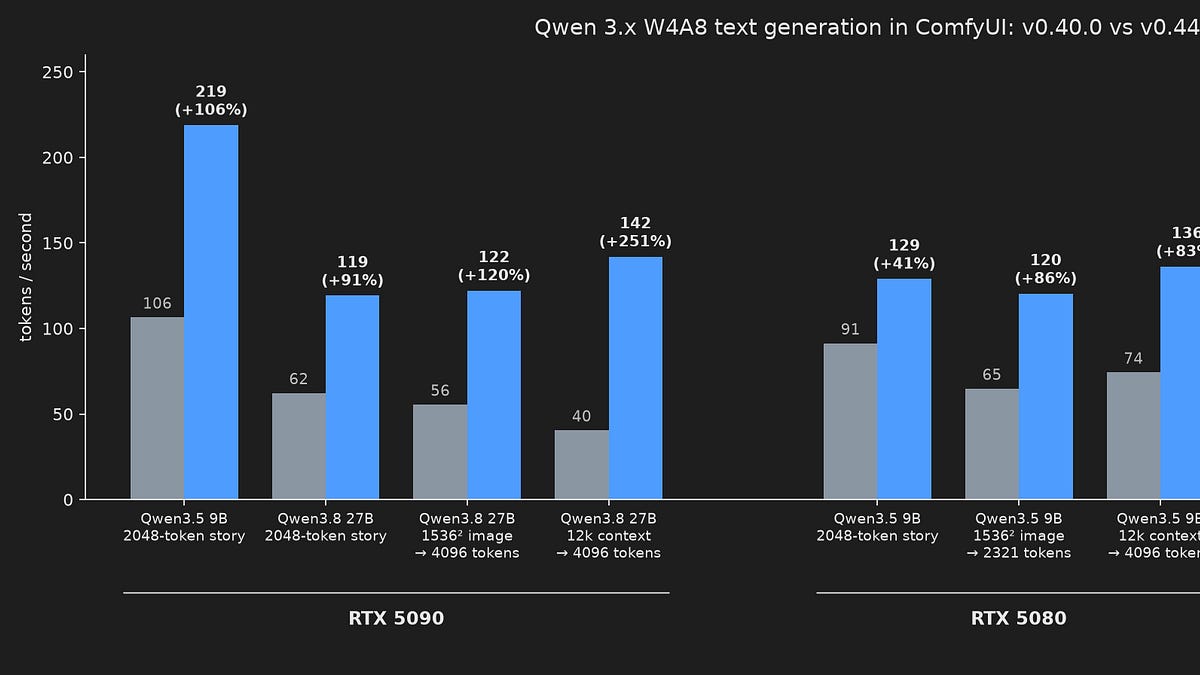
Обновление ComfyUI до версии v0.45.0 удваивает скорость локальной генерации текста на моделях семейства Qwen3.x: те же чекпойнты на той же видеокарте выдают до двух раз больше токенов в секунду. Прирост дают переписанный горячий путь генерации, адаптивный Tree MTP и INT8-внимание Comfy-Kitchen, а включается он простым обновлением клиента без смены железа. Для визуальных пайплайнов это означает, что текстовые шаги перестают быть узким местом: локальная генерация на потребительских GPU приближается по скорости к облачным API.
Что произошло
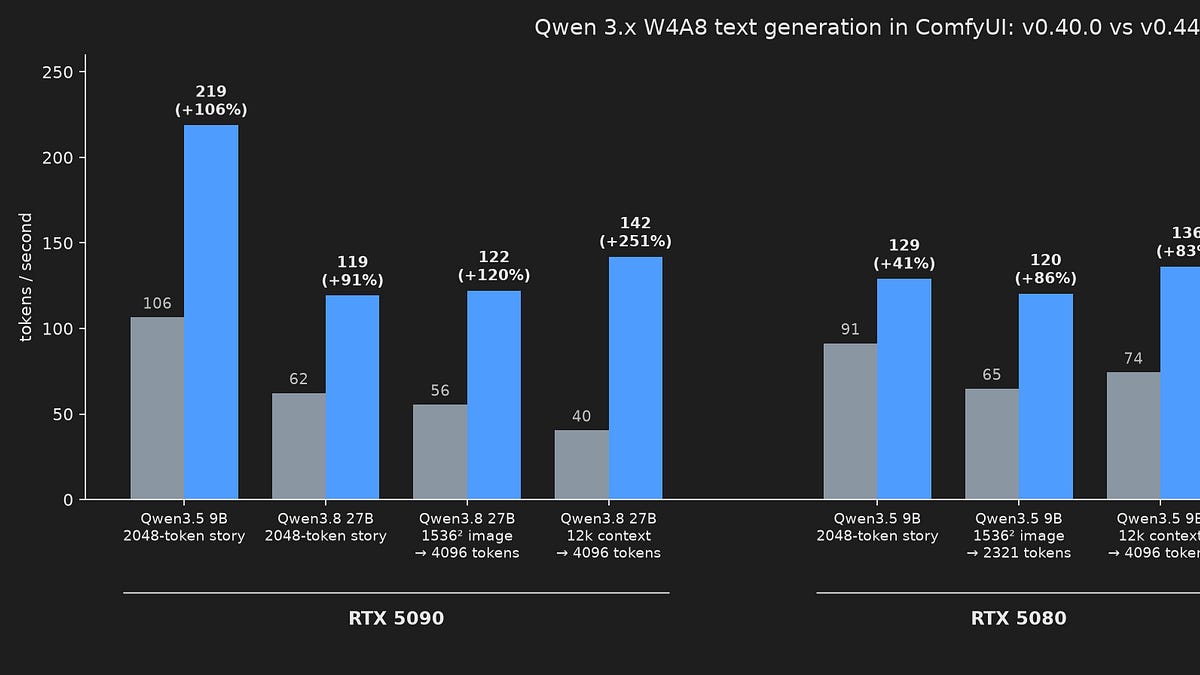
В релизе ComfyUI v0.45.0 переписан горячий путь генерации для LLM семейства Qwen3.x, так что одинаковые чекпойнты на одинаковых картах показывают кратный рост токенов в секунду. По замерам авторов, на RTX 5090 модель Qwen3.5 9B ускорилась со 106 до 219 токенов/с, Qwen3.8 27B при описании изображения 1536×1536 — с 55 до 122 токенов/с, а на RTX 5080 девятимиллиардный Qwen3.x — с 91 до 129 токенов/с. Первый механизм ускорения — оптимизированный GEMV-кернел: интерливинг весов и шкал, MMA-инструкции и пролог-фьюжн с RMSNorm и SwiGLU, подстроенные под порядок потребления весов. Второй — адаптивный Tree MTP: вместо одиночной цепочки спекулятивных догадок используется дерево глубиной до семи токенов, форма которого подстраивается под текст, где глубина выгодна коду, а ширина — творческому письму. Третий — INT8-внимание Comfy-Kitchen, включаемое флагом --use-ck-attention, которое уменьшает KV-кэш и ускоряет pre-fill. По утверждению авторов, качество генерации при этом не меняется.
Контекст
Скорость локального декодирования ограничена не вычислительной мощностью, а пропускной способностью видеопамяти: чтобы выдать каждый токен, GPU обязан полностью прочитать веса модели, а для 27B в формате W4A8 это порядка 14 ГБ на один шаг. Поэтому выигрыш ищут не в новых архитектурах, а на уровне кернелов, спекулятивного декодинга и квантования кэша. Tree MTP здесь — развитие известного семейства методов спекулятивного декодинга, когда модель заранее предлагает догадки и проверяет их параллельно, а квантование кэша — стандартный приём, позволяющий длинным контекстам, прежде не помещавшимся в VRAM, работать на тех же картах. В экосистеме ComfyUI, где модели применяются внутри визуальных пайплайнов, текстовые стадии исторически отставали от графических, и LLM-ноды оставались медленной надстройкой. Важная деталь: релиз не добавляет новую модель и не меняет чекпойнты, вся разница создана на уровне исполняемого кода.
Почему это важно для индустрии
Для отрасли это сдвиг юнит-экономики: ускорение достаётся бесплатно, на том же железе и тех же чекпойнтах, поэтому маржинальная стоимость текстовых операций — prompt enhancement, описания изображений, сторителлинг — падает почти до нуля. При 100–220 токенах/с на потребительских GPU локальные LLM-ноды превращаются из медленной надстройки в штатный строительный блок продуктов: текстовые стадии выполняются интерактивно, без облака, API-ключей и передачи данных наружу. У стартапов исчезает основание продавать «доступ к API» для таких операций, и ценность смещается к оркестрации пайплайнов. Если прирост подтвердится независимыми замерами, стоит ожидать больше нод и шаблонов, где LLM — штатный шаг пайплайна от описания до вариаций и reroll в один клик, появления чат-подобных UX-паттернов внутри генеративных редакторов и давления на сторонние бэкенды локального инференса. В горизонте пары лет такой релиз показывает, что конкурентоспособность локальных моделей определяется не только архитектурой чекпойнта, но и качеством инференс-инжиниринга под конкретное железо, а разрыв между потребительским GPU и облаком для single-user сценариев сжимается.
Почему это важно для пользователей
Если вы генерируете текст в ComfyUI на моделях Qwen3.x, достаточно обновиться до v0.45.0 и выставить mtp=auto в Text Generate node: пересобирать ничего не нужно, работает на NVIDIA и AMD под Windows и Linux. Для длинных контекстов, которые раньше не помещались в видеопамять, предусмотрен отдельный флаг --use-ck-attention, но его лучше пробовать отдельным экспериментом с контролем качества. Практически это означает, что текстовые шаги перестают тормозить пайплайн и локальную текстовую функцию можно закладывать в проект как интерактивную уже сегодня, продолжая работать со своими чекпойнтом, чатом и файлами на своей машине.
Что пока неизвестно / ограничения
Заявление «то же качество» пока не является измеренным фактом: в публикации нет методики оценки качества, а переписанный горячий путь меняет numerics за счёт INT8-внимания, фьюжна пролога и INT8 KV-кэша. Без указания конкретных эвалов и метрик это остаётся декларацией авторов, поэтому скорость стоит проверять вместе с качеством выходов на своих задачах. Прирост от Tree MTP зависит от природы текста и доли принятых догадок, так что в реальных задачах он может отличаться от бенчмарков. Заявленные цифры скорости получены на конфигурациях авторов, независимых замеров пока нет.
Источники
Автор
Look at AI, редакция