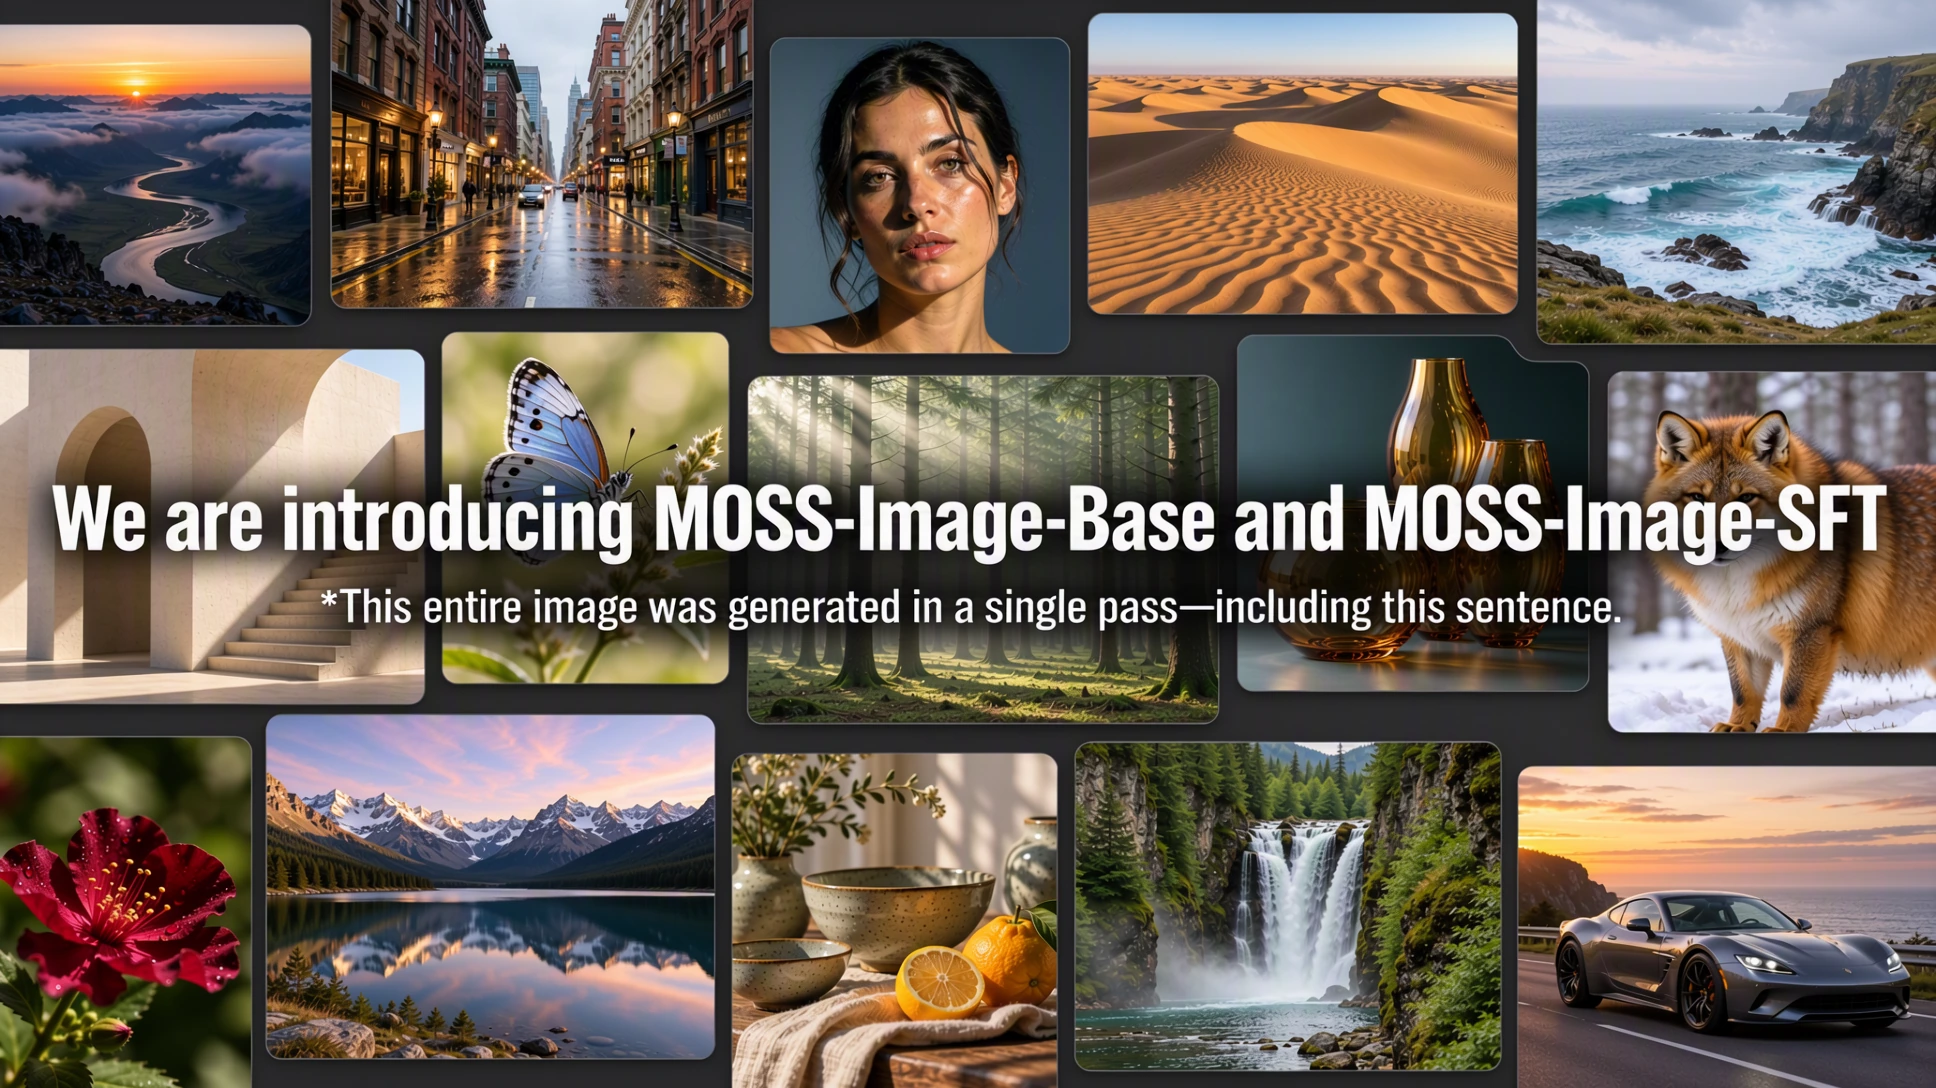
🎨 OpenMOSS открыл MOSS-Image — открытую text-to-image модель с JSON-сценой
16 октября 2026 года под Apache-2.0 опубликованы код и веса: Base и дообученная SFT на DiT-бэкбоне, 5B параметров. Композиция задаётся JSON-промптом с объектами, текстом и bounding box — сцену правят структурно, а не угадыванием промптов. Модель рендерит надписи внутри картинки, включая китайские и рукописные.
🌍 Готовый открытый бэкбон для layout-to-image задач — постеров, инфографики, UI-макетов: в репозитории LoRA-гайд, официальный плагин ComfyUI и Prompt Enhancer, VAE — FLUX.2 small decoder.
👤 Демо уже на Hugging Face Spaces; веса SFT запускаются локально на NVIDIA GPU (Python 3.10+, PyTorch 2.9+, diffusers>=0.38) или через ComfyUI Manager. JSON упрощает правки, но техотчёта и evals пока нет, а происхождение данных не раскрыто.
Источник 1: https://github.com/OpenMOSS/MOSS-Image Источник 2: https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT