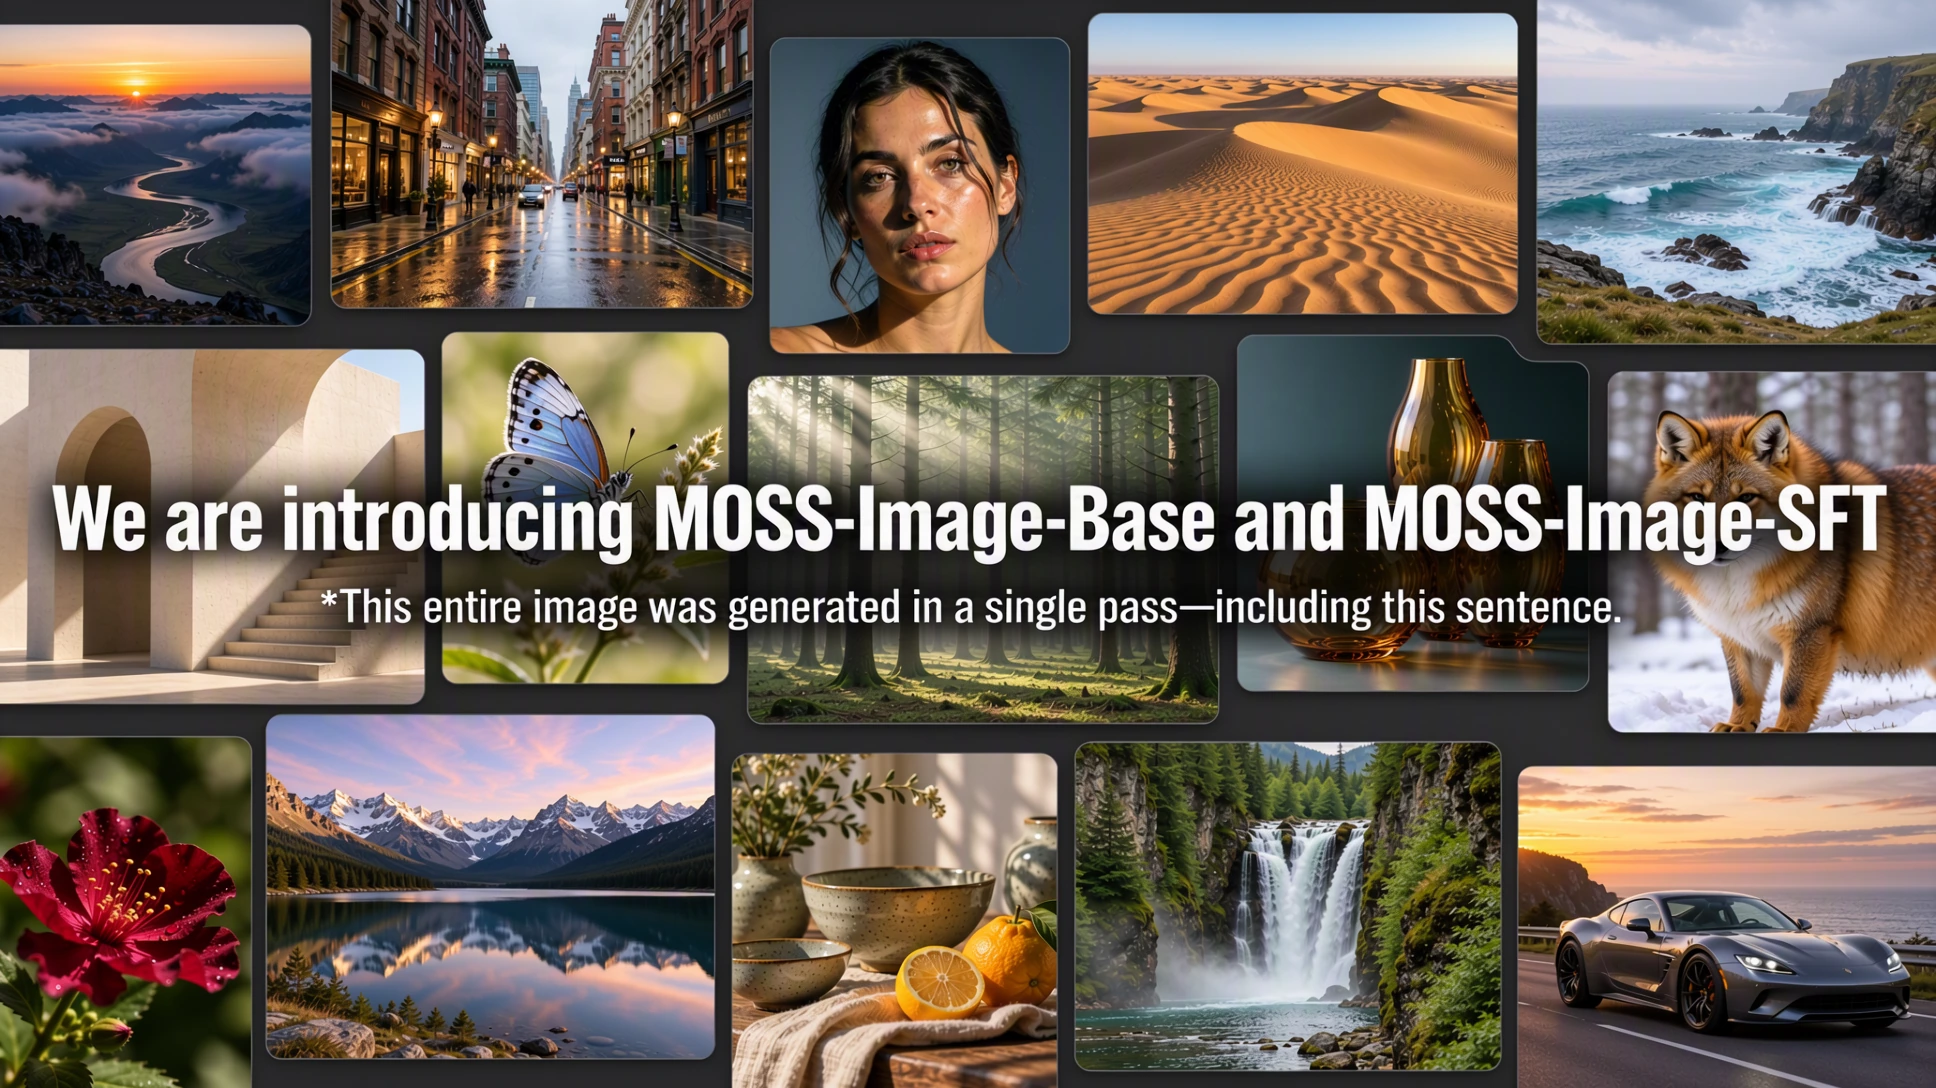
OpenMOSS Team открыл доступ к MOSS-Image — семейству text-to-image моделей на DiT-бэкбоне с 5B параметров, опубликовав код и веса под Apache-2.0 в вариантах MOSS-Image-Base и MOSS-Image-SFT. Главная особенность релиза — нативный layout-контроль: сцена задаётся не свободным текстом, а JSON-промптом с объектами, надписями и bounding box. Модель уже доступна в демо на Hugging Face Spaces и для локального запуска на NVIDIA GPU, а вместе с ней вышли официальный плагин для ComfyUI и инструментарий для дообучения.


Что произошло
16 октября 2026 года OpenMOSS Team опубликовал код и веса двух вариантов модели: базовой MOSS-Image-Base и MOSS-Image-SFT, дообученной на курируемых данных. Композиция в MOSS-Image задаётся JSON-промптом, где перечисляются объекты, текст и bounding box в формате yxyx с координатами от центра холста, поэтому сцену можно править структурированно, меняя описания и рамки по отдельности. Модель рендерит текст внутри изображения, включая китайский и рукописные надписи, принимает промпты длиной до 4K токенов и генерирует как аниме, так и фотореализм. Рекомендуемые настройки генерации — flow-matching Euler, 50 шагов, CFG 3, shift 5 и, нестандартно, пропуск негативной ветки на слое 22. К релизу подготовлены официальный плагин для ComfyUI, Gradio-интерфейс, демо на Hugging Face Spaces, LoRA-гайд в репозитории и Prompt Enhancer skill, превращающий идею в детальный caption.
Контекст
Смысл релиза не только в ещё одной генеративной модели, а в смене интерфейса: вместо перебора формулировок сцена описывается машиночитаемой спецификацией, у которой можно точечно менять отдельные элементы. MOSS-Image построена на компактном DiT-бэкбоне, а её VAE переиспользует small-декодер FLUX.2 — технически это рациональная экономия compute, но и кросс-модельная связка, требующая отдельной проверки. Рекомендованный пайплайн при этом специфичен: помимо привычных для flow-matching моделей шагов и CFG авторы предписывают пропуск негативной ветки на слое 22, и без техотчёта такой параметр остаётся константой, которую придётся копировать как есть. Контекст появления тоже важен: открытая модель под Apache-2.0 с поддержкой свежих diffusers выходит тогда, когда экосистема уже умеет быстро обстреливать подобные веса дистилляциями и редакторскими интеграциями.
Почему это важно для индустрии
Для продуктовых команд это прежде всего новый программируемый конвейер, а не новая строчка в списке t2i-моделей: layout-JSON можно собирать скриптом или LLM-агентом, что превращает генерацию изображений в обычный вызов инструмента. Связка открытых весов Apache-2.0, компактных 5B параметров и поддержки свежих diffusers даёт короткий путь от скачивания до рабочего сервиса: прототип генератора постеров, инфографики или UI-макетов по JSON-шаблонам собирается за дни, без переговоров с вендорами и подписок на чужие генерации. LoRA-гайд снижает порог дообучения под нишу, Prompt Enhancer skill позволяет агентам превращать сырую идею в детальный caption, а реакция сообщества подтверждает реальный интерес: в первый же день появились 8-шаговая DMD-дистилляция от lodestones и ComfyUI-преобразование от nif0. Если независимые тесты подтвердят точность следования боксам и качество рендера текста, JSON-контроль может стать ожидаемой нормой для открытых text-to-image моделей, а community-оптимизации подобного рода заметно удешевят инференс.
Почему это важно для пользователей
Попробовать модель можно прямо сейчас без установки: демо на Hugging Face Spaces показывает, как MOSS-Image держит bounding box и рендерит текст. Для локального запуска достаточно скачать MOSS-Image-SFT и развернуть окружение на NVIDIA GPU с Python 3.10 и новее, PyTorch 2.9 и выше, diffusers не старше 0.38 и transformers не старше 5.3; альтернативный путь — установка официального плагина через ComfyUI Manager. Благодаря JSON-формату правка композиции становится предсказуемой операцией: чтобы переставить объект или заменить надпись, достаточно изменить соответствующий элемент спецификации, а не заново угадывать промпт. Gradio-интерфейс из репозитория закрывает базовый сценарий, а Prompt Enhancer skill помогает тем, кому проще описать идею словами, чем вручную собирать layout.
Что пока неизвестно / ограничения
В открытых материалах — репозитории, карточке модели и на проектной странице — пока нет техотчёта и количественных evals, поэтому заявления о качестве текст-рендеринга, аниме и фотореализме стоит проверять на собственных кейсах, а не по тизерам. Не опубликованы и практические данные по латентности и требованиям к GPU для продакшена, хотя сам запуск требует свежих зависимостей. Кросс-модельная связка бэкбона DiT с VAE-декодером FLUX.2 нуждается в проверке совместимости латентных пространств и чистоты лицензионного статуса такого переиспользования. Часть рекомендованных настроек пайплайна эмпирически обоснована только примерами: без техотчёта отдельные параметры вроде пропуска негативной ветки на конкретном слое остаются магическими константами и могут мешать портированию в другие пайплайны. Наконец, это self-host путь: хостинг, масштабирование и стоимость инференса ложатся на самого пользователя.
Источники
- GitHub — OpenMOSS/MOSS-Image: официальный репозиторий (5B DiT, layout-контроль, Apache-2.0)
- OpenMOSS-Team/MOSS-Image-SFT — карточка модели на Hugging Face
- MOSS-Image | Text-to-Image Generation with Native Layout Control — официальная проектная страница
- lodestones/MOSS-Image-SFT-8-steps-dmd — 8-шаговая DMD-дистилляция от сообщества на Hugging Face
Автор
Look at AI, редакция