💻 Открыт код Open-VC Attention: FP8-внимание для Blackwell вдвое быстрее
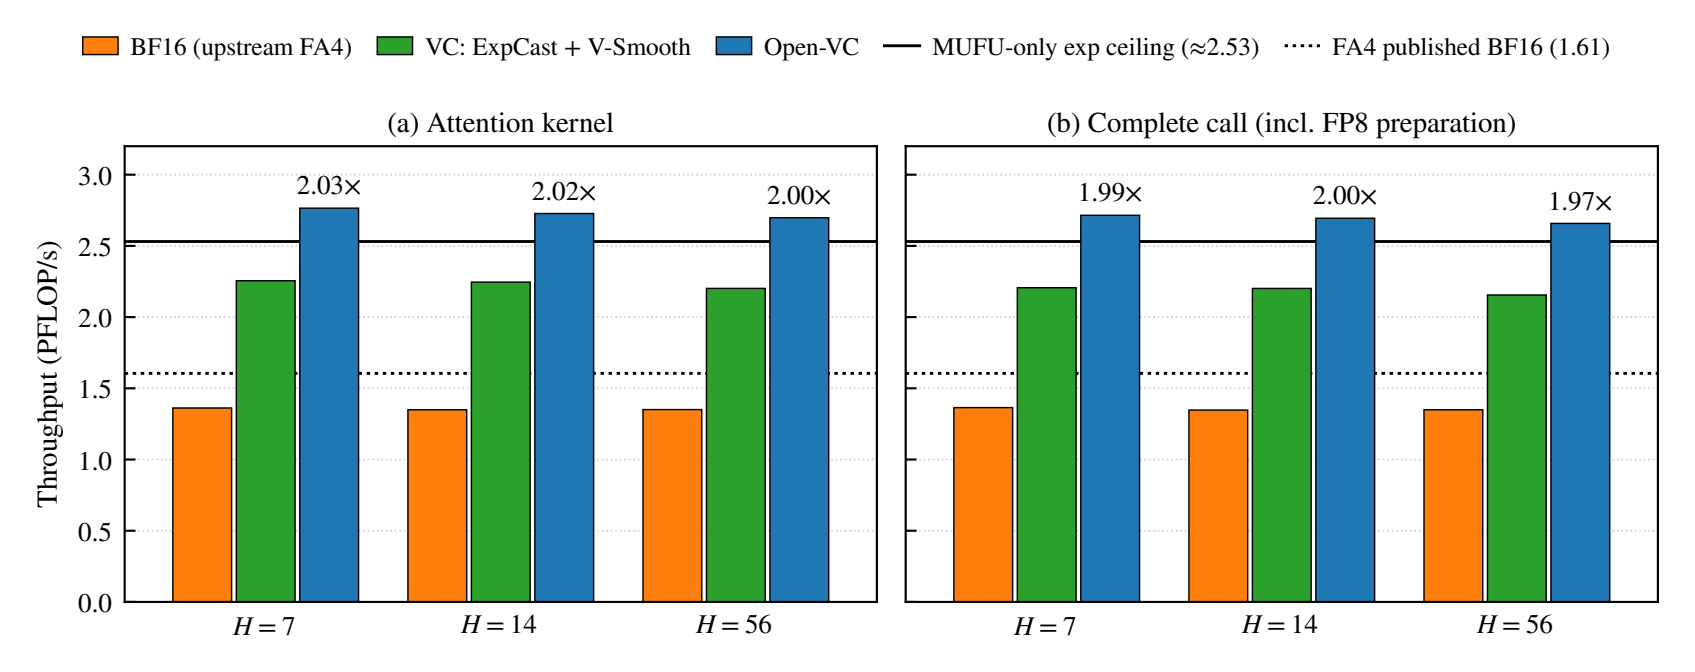
MachGen выпустила библиотеку под BSD-3-Clause: FP8-ядра на CuTe DSL на базе FlashAttention-4 реализуют ExpCast из статьи VC-Attention (arXiv 2609.15810). На видео-модели MiniMax-H3 это 2,00–2,03× к BF16 FlashAttention-4 при ошибке L2 2,98–3,19%.
🌍 Внимание — самая дорогая часть генерации видео, а на Blackwell ядра упираются в юнит спецфункций MUFU (~2,53 PFLOP/s, вдвое ниже FP8-пика B200): по нему идёт экспонента softmax. ExpCast считает FP8-вероятности одной FMA без экспоненты — отсюда реальные ~2×.
👤 На B200/B300 с длинным видео-denoising ядро ставится через pip (Linux, Python 3.10+, CUDA 13 PyTorch), вызов open_vc_attn.attention(q, k, v) с BF16-входами. Ошибку регулирует бюджет V residual repair (budget=0.005); на других моделях не валидировано.
Источник 1: https://www.machgen.ai/blog/open-vc-attn
Источник 2: https://github.com/MachGen/open-vc-attention