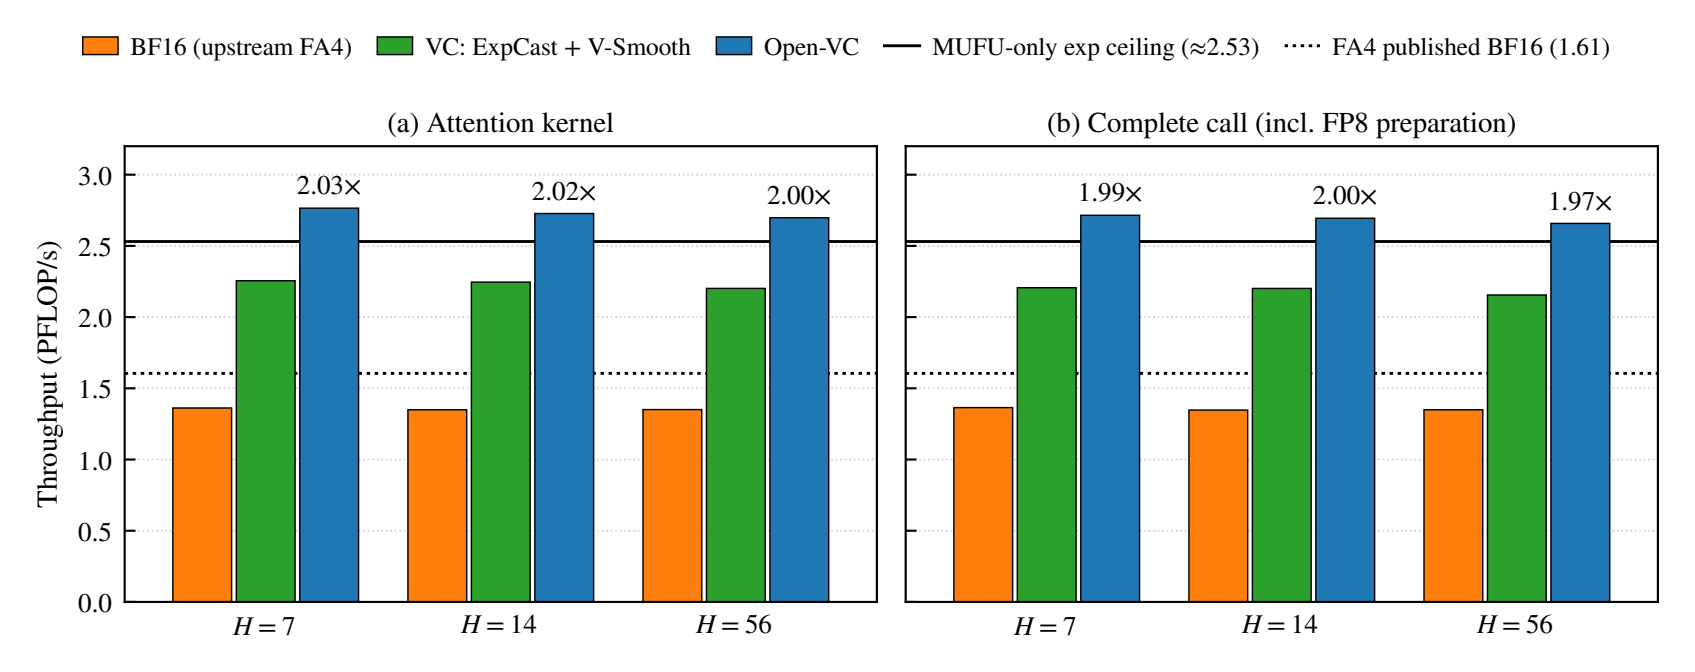
MachGen опубликовала исходники Open-VC Attention — открытых FP8-ядер внимания для ускорителей NVIDIA Blackwell (B200 и B300), построенных на базе CuTe DSL-ядра FlashAttention-4 и реализующих приём ExpCast из свежей статьи VC-Attention под лицензией BSD-3-Clause. На реальном захвате шага denoising видео-модели MiniMax-H3 ядро работает почти вдвое быстрее BF16 FlashAttention-4, а степень численной ошибки остаётся контролируемой. Для команд, генерирующих длинное видео на Blackwell, это готовый способ удешевить самую тяжёлую стадию генерации, а для отрасли — наглядный пример того, как свежая статья за считанные недели превращается в открытый производственный код.
Что произошло
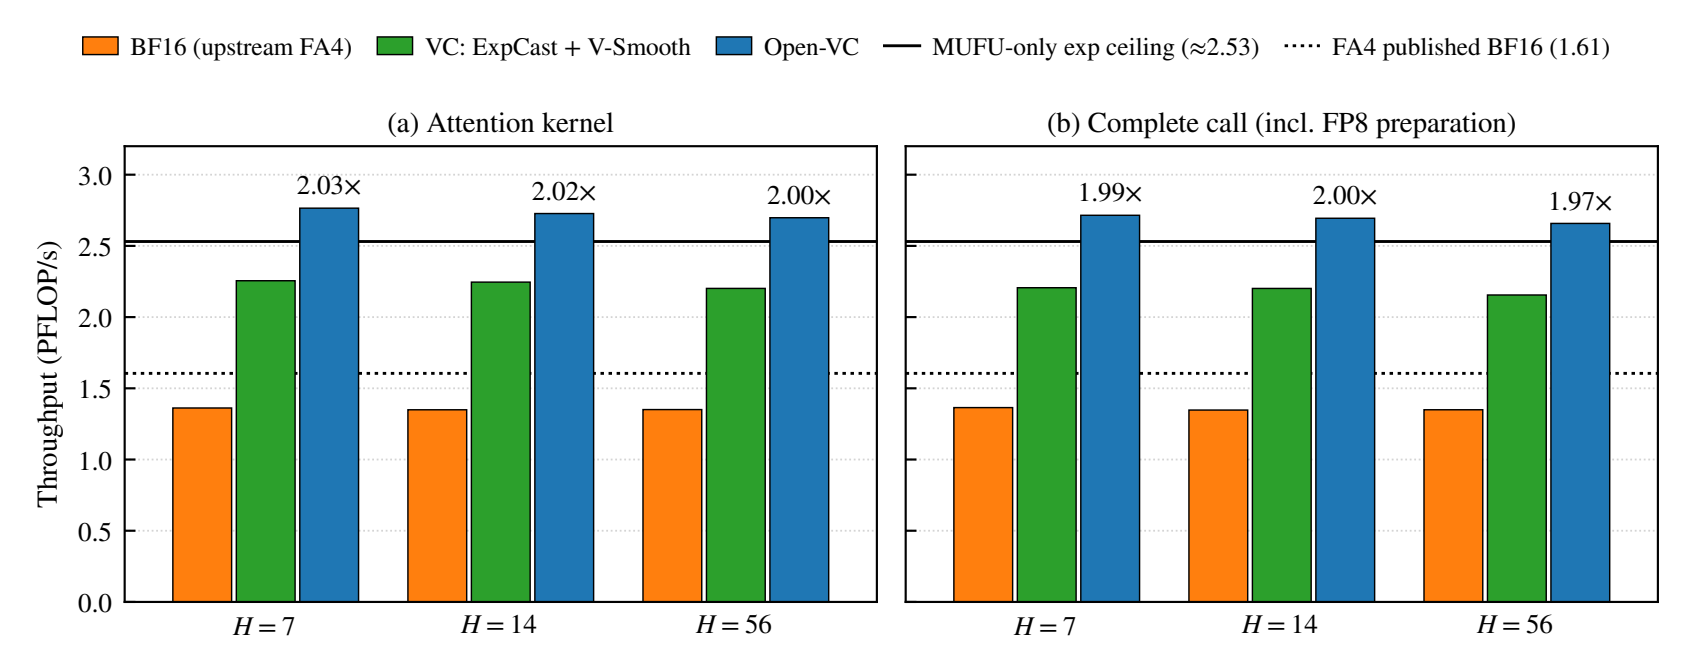
MachGen открыла исходники Open-VC Attention: это FP8-ядра внимания для NVIDIA Blackwell (B200 и B300), собранные на базе CuTe DSL-ядра FlashAttention-4 и реализующие приём ExpCast из статьи VC-Attention (arXiv 2609.15810, опубликована 14.09.2026). Код распространяется под лицензией BSD-3-Clause. Замеры выполнены на реальном BF16-захвате одного шага denoising видео-модели MiniMax-H3 — длина последовательности 73397, 56 голов внимания, head dim 128. Относительно BF16 FlashAttention-4 (flash-attn-4 4.0.0b33) ядро даёт ускорение 2,00–2,03 раза, а авторскую реализацию метода из статьи обгоняет примерно в 1,6 раза; относительная ошибка L2 составляет 2,98–3,19%. Вместо предложенного в статье приёма V-Smooth — онлайн-кластеризации k-means по значениям V — в открытой версии использован «V residual repair»: квантованные остатки вносятся только в худшие по энергии токены V; в 15-секундном ролике MiniMax-H3 ремонт понадобился примерно 0,5% токенов, без него лицо персонажа за визором схлопывалось. В репозитории выложены методика бенчмарков и smoke-проверка open-vc-attn-check --smoke.
Контекст
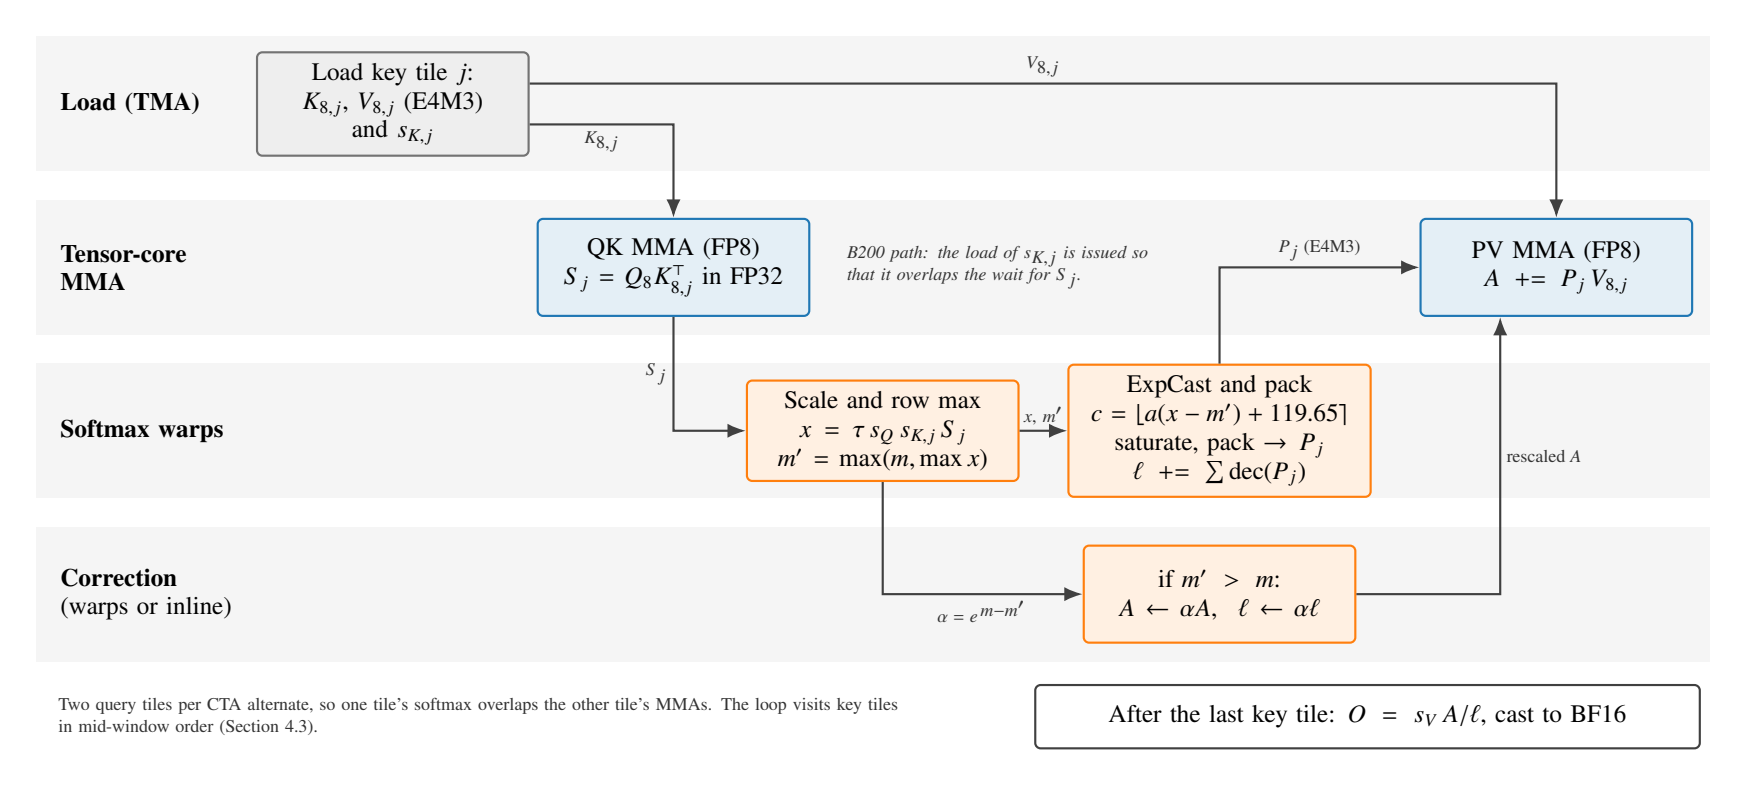
Чтобы понять смысл релиза, стоит вспомнить, как считается внимание на Blackwell. Внимание — самая дорогая часть генерации видео диффузионными трансформерами, и FP8-ускорение тензорных ядер на этих чипах обесценивается медленным юнитом спецфункций MUFU: его производительность составляет около 2,53 PFLOP/s, примерно вдвое ниже FP8-пика B200, и именно через этот юнит обычные ядра прогоняют экспоненты softmax. Приём ExpCast снимает этот потолок: FP8-вероятности softmax вычисляются одной FMA-инструкцией без вызова экспоненты. Однако дело не только в идее из статьи: превосходство открытого кода объясняется инженерией на CuTe DSL — варп-специализированным конвейером, mid-window поиском максимума, сокращающим число рескейлов, упакованным транспонированным V под тензорные ядра и слиянием подготовки входов в CUDA-граф (0,86 мс, порядка 1,5% накладных расходов). Для сравнения, заявленный в оригинальной статье выигрыш метода составлял 1,47–1,6 раза. Точечный ремонт худших по энергии токенов V, заменивший механизм статьи, превращает ошибку квантования из фиксированного издержка в настраиваемый бюджет — такой подход ближе к продакшен-практике, чем онлайн-кластеризация.
Почему это важно для индустрии
Отраслевое значение в том, что это первый открытый производственный путь к такому ускорению внимания видео-диффузии на Blackwell: на самой тяжёлой стадии генерации — длинном видео-denoising — вычисления становятся примерно вдвое дешевле. Показательнее сам формат: low-bit-техника из свежей статьи за считанные недели превратилась в открытый воспроизводимый код BSD-3-Clause с документированной интеграцией в SGLang, а не осталась приватным преимуществом одной команды — вычислительные рвы вокруг самописных ядер внимания быстро обесцениваются. На ближайшие месяцы вероятна траектория поглощения: приёмы ExpCast и управления ошибкой по бюджету могут подхватить serving-стеки и конкуренты ядер вроде FlashAttention-4 и cuDNN, стоит ждать сравнений на большем наборе моделей и первых портирований за пределы видео-внимания. Если независимые воспроизведения подтвердят заявленные цифры, FP8-внимание с настраиваемым бюджетом ошибки может стать опцией по умолчанию в видео-serving, а в горизонте пары лет low-bit-внимание с регулируемой точностью рискует стать дефолтом инференса для видео и длинного контекста — тогда конкуренция сместится с самих ядер на управление бюджетом ошибки и продуктовое качество.
Почему это важно для пользователей
Сразу применить релиз могут команды с профилем B200 или B300 и длинным видео-denoising: MHA с head dim 128 и длиной последовательности от ~32768. Ядро ставится через pip — Linux, Python 3.10+, PyTorch с CUDA 13, для B200 нужна архитектура SM100, для B300 SM103 — и вызывается как open_vc_attn.attention(q, k, v) с BF16-входами. Степень допустимой ошибки задаётся бюджетом V residual repair: в примере из репозитория используется budget=0.005. Практичная последовательность пилота: установить пакет, прогнать прилагаемую smoke-проверку, затем замерить свою модель по опубликованной методике бенчмарков. Выгода реальна только при совпадении профиля; командам вне этого коридора ядро сегодня напрямую не подходит, но открытый код с методикой позволяет разбирать приёмы ExpCast и точечного ремонта значений V для собственных экспериментов.
Что пока неизвестно / ограничения
Формулировка «ошибка как ручка» на уровне продукта преждевременна: значение budget=0.005 — параметр V residual repair, подобранный на одном 15-секундном ролике одной модели, а зависимость между бюджетом ремонта и визуальным качеством не валидирована на других моделях, промптах и сценах. Заявленная относительная L2-ошибка — численная метрика, которая до перцептивной валидации не заменяет проверку качества на собственных данных. Заявленные цифры ускорения пока не подтверждены независимыми воспроизведениями. Наконец, применимость ограничена узким профилем железа и нагрузки, описанным выше, поэтому вне этого профиля измеренная выгода не гарантирована.
Источники
- Open-VC Attention: Open-Source, Error-Tunable VC-Attention Variant — MachGen blog
- MachGen/open-vc-attention — открытая FP8-реализация VC-Attention для Blackwell (GitHub, BSD-3-Clause)
- VC-Attention: Value Smoothing and Softmax Casting for Low-bit Attention (arXiv 2609.15810)
Автор
Look at AI, редакция