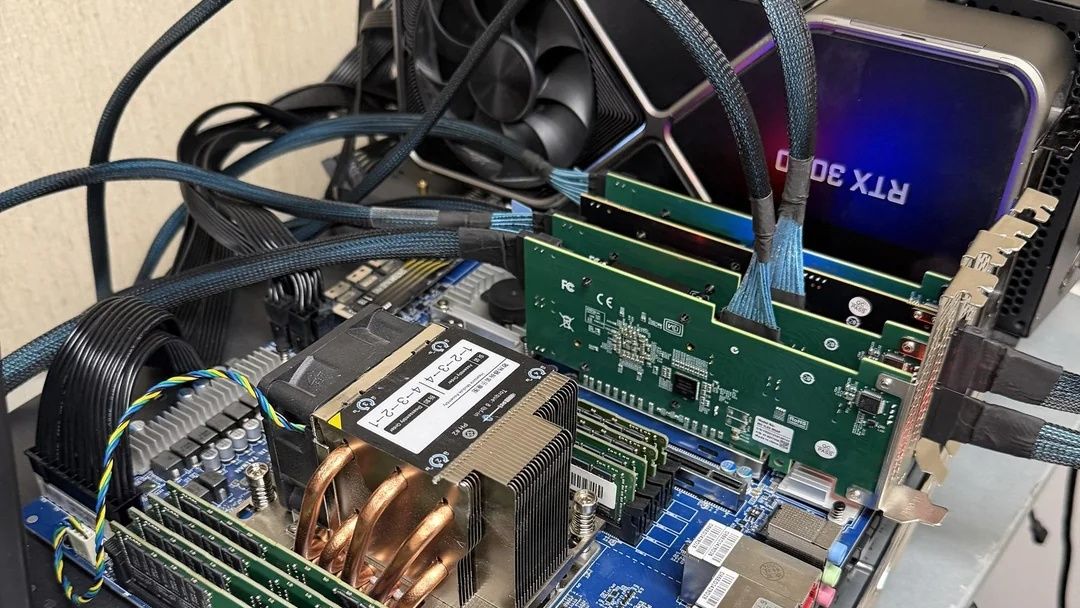
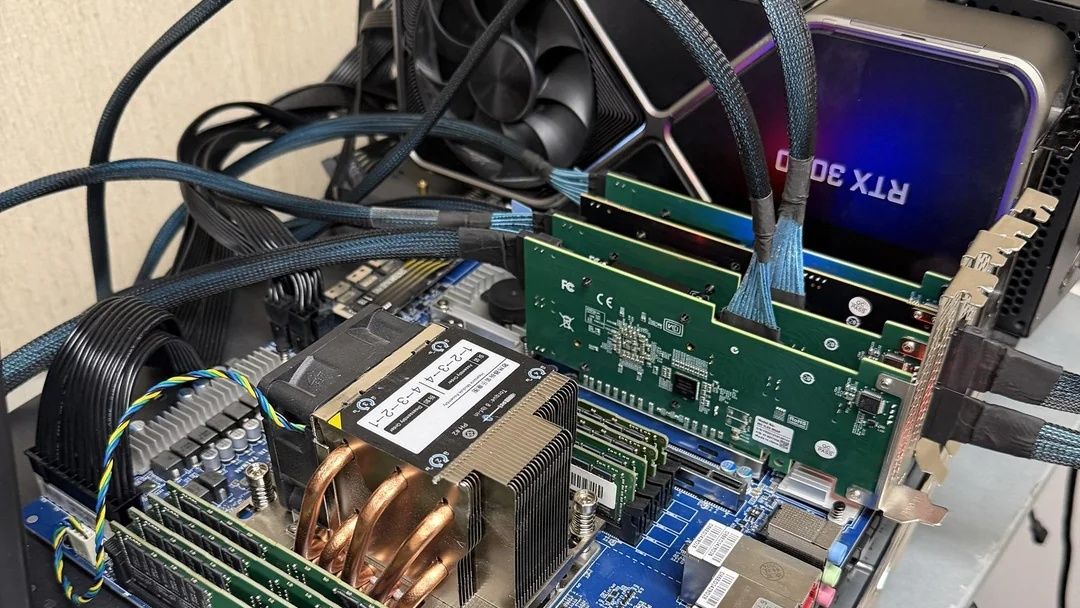
Адвокат Ник Мермиджес (Nick Mermiges) из Колумбии (Южная Каролина), основатель PLI Labs и proprietarylegal.ai, обновил свой домашний сервер на восьми б/у Nvidia V100: на нём запускается DeepSeek V4.1 Flash в режиме «near-NVFP4», где 4-битный формат Nvidia NVFP4 применён к «горячим» экспертам MoE-модели, а остальные эксперты работают в 2 бит. Апгрейд памяти, установка RTX 3090 и замена сбойного блока питания подняли совпадение токенов с эталонной NVFP4-версией DeepSeek до 95,1% и существенно расширили контекстное окно — ценой части скорости. Кейс показателен как пример сборки приватной LLM-инфраструктуры из устаревшего датацентрового железа для профессий, где данные не должны покидать офис.
Что произошло
Апгрейд шёл по нескольким направлениям. Массив памяти доведён до 1 ТБ восемью модулями по 128 ГБ, работающими на 2933 MT/s; в системе появился RTX 3090; источник повторяющихся крашей обнаружился в блоке питания, который в итоге заменили. Схема квантования стала гранулярной: из 15 360 маршрутизируемых экспертов MoE-модели 5 949, то есть 38,7%, переведены в NVFP4, оставшиеся — в 2 бит. Против эталонной NVFP4-версии DeepSeek совпадение следующего токена выросло с 92,2% до 95,1%, KL-дивергенция снизилась с 0,196 до 0,079 натс, а на авторском тесте из 513 вопросов число изменившихся ответов сократилось с 79 до 8. Контекстное окно достигло 524 тыс. токенов, сервер обслуживает два параллельных запроса; плата за точность — часть скорости генерации. Tom's Hardware в заголовке описывает эту конфигурацию как запуск 80% DeepSeek v4.1 Flash при 4-битной точности NVFP4.
Контекст
Кейс стоит на трёх основаниях. Первое — архитектура mixture-of-experts: DeepSeek V4.1 Flash построена из огромного набора маршрутизируемых экспертов, между которыми роутер распределяет каждый токен, поэтому нагрузка внутри модели распределена неравномерно. Второе — гранулярность квантования: по логике метода качество сильнее страдает от квантования часто используемых «горячих» экспертов, чем редко задействованных «холодных», поэтому их перевод в NVFP4 (4-битный формат с плавающей запятой от Nvidia) при 2-битных «холодных» выглядит обоснованным компромиссом, а не равномерным сжатием всей модели. Третье — железо: V100 — это датацентровый GPU поколения Volta с 32 ГБ HBM2, давно ушедший с первой линии продаж и доступный на вторичном рынке; R580 — последняя ветка драйверов для этой платформы, что задаёт конечный срок жизни подобных сборок. Логика автора связана с профессией: юридическая практика работает с конфиденциальными материалами, которые не должны покидать периметр офиса, поэтому локальный инференс для неё привлекательнее облачного API.
Почему это важно для индустрии
Для индустрии главный сигнал — снижение порога железа: покомпонентное квантование MoE опускает требования к on-premise-инференсу больших моделей до уровня вторичного рынка GPU. Это размывает нижний ценовой диапазон облачных API и открывает нишу «private AI» для юридических, медицинских и финансовых фирм, где данные не должны покидать периметр. Пока это единичный референс, а не стандартизированный метод, но если появятся независимые повторы с метриками против полной модели, эксперт-гранулярное смешанное квантование стоит ожидать как опцию открытых инференс-стеков; рядом вероятны нишевые инструменты — профилировщики горячих экспертов, автотюнеры переменной точности, готовые шаблоны деплоя на Volta-железо, а интеграторы могут начать продавать малым фирмам собранные «частные AI-серверы». В горизонте двух лет этот паттерн способен сместить ценность новых GPU-поколений от «возможности запустить» к латентности и энергоэффективности, а границу «облако против on-premise» — размыть: чувствительные данные обрабатываются локально, массовые нагрузки уходят в облако. Ограничение ниши в том, что б/у Volta-платформы покупаются на исходе жизненного цикла, а потолок производительности устаревших GPU остаётся ниже современных ускорителей.
Почему это важно для пользователей
Читателю, прикидывающему собственную сборку, кейс даёт конкретные ориентиры. Скорость: генерация кода идёт на 150–180 токенов/с против 160–215 в прежней конфигурации, а юридические тексты замедлились на 9–23% — прозрачная плата за прирост точности, которую можно закладывать в планирование ёмкости. Есть и инженерные уроки: расширение памяти до терабайтного масштаба тянет за собой NUMA-тюнинг, а сборка на Volta живёт ровно столько, сколько платформе осталось драйверной поддержки, что важно учитывать при покупке б/у GPU. Для владельцев чувствительных данных сценарий применения ясен: прототипы локального AI внутри периметра офиса или клиента собираются без облачных токенов и API-ключей. При этом кейс не даёт готового коробочного продукта — понадобится точный список компонентов и собственная реализация квантования.
Что пока неизвестно / ограничения
Главная оговорка: прирост измерялся относительно уже квантованной эталонной NVFP4-версии DeepSeek, а не полной модели — это снижение ошибки одного квантования относительно другого, а не улучшение модели; относительно полной точности качество, вероятно, ниже. Тест из 513 вопросов авторский: его состав и эталонные ответы не раскрыты, а «изменившиеся ответы» — не то же, что «правильные», поэтому метрика показывает согласованность конфигураций, а не корректность. Не раскрывается, какие статистики маршрутизации легли в отбор 5 949 «горячих» экспертов и какой фреймворк инференса применялся, так что независимое воспроизведение пока невозможно. Остаются непояснёнными роль RTX 3090 в итоговой конфигурации и соотношение цифры «80%» из заголовка с фактическим распределением экспертов по точностям. Независимой репликации нет: обсуждение на Hacker News насчитывает 1 балл и 0 комментариев, а материалы о кейсе сведены к Tom's Hardware и этому треду. Для продакшена со строгими SLA сборка пока не готова — это единичный стенд, а не тиражируемый метод.
Источники
- Tom's Hardware — статья о модернизации сервера на восьми V100 для запуска DeepSeek V4.1 Flash
- Hacker News — обсуждение кейса модернизации восьми V100 под DeepSeek V4.1 Flash
Автор
Look at AI, редакция