Bespoke Labs совместно с University of Chicago и UC Berkeley Sky Computing Lab представили EnvOpt (arXiv:2611.07372) — фреймворк, который автоматически оптимизирует «стационарное окружение» LLM-агента: структуру файлов, представления данных и набор доступных инструментов, не трогая параметры модели и harness. По данным авторов, на пяти бенчмарках это дало в среднем 48% экономии стоимости на невидимых тестовых наборах при сохранении или росте pass rate. Статья и частично открытый код опубликованы 5 ноября 2026 года.
Что произошло
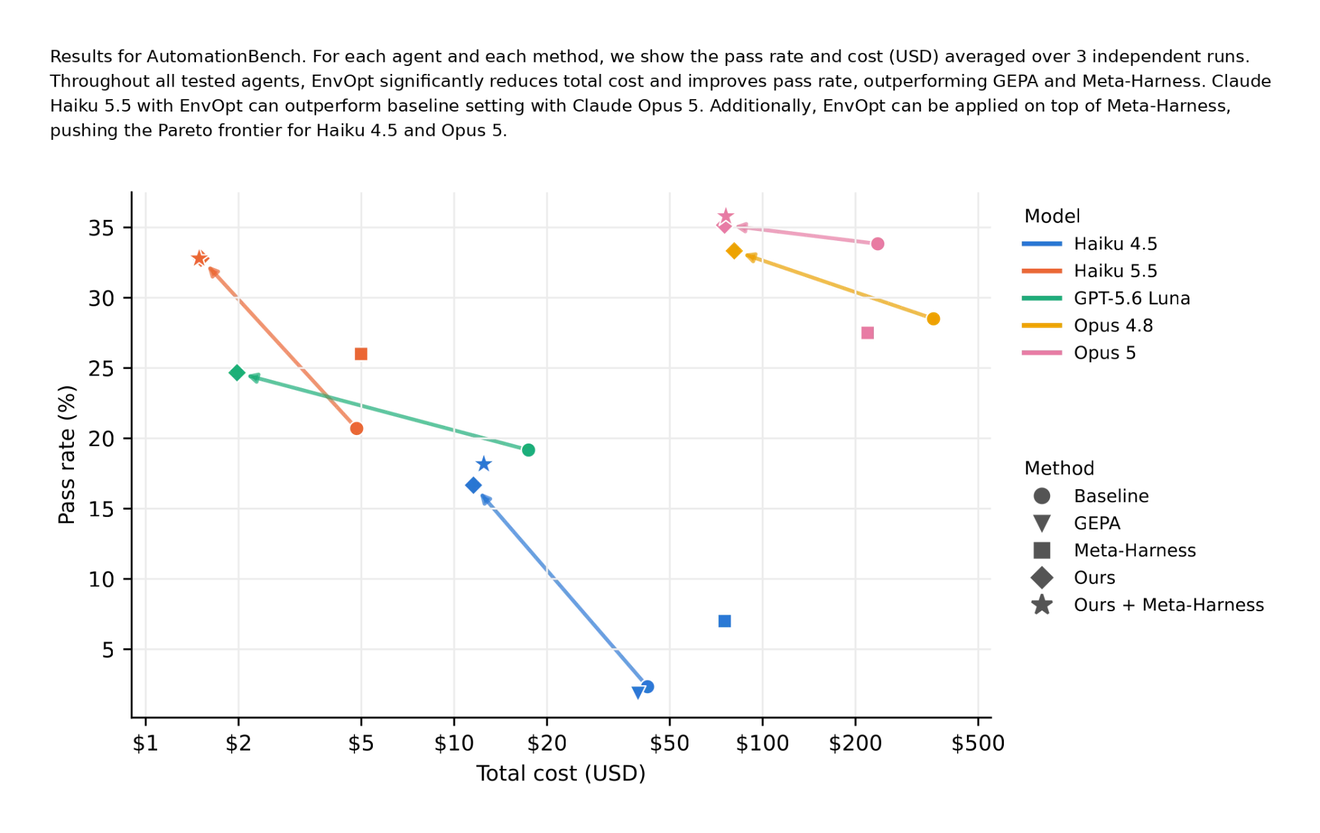
5 ноября 2026 года Bespoke Labs, University of Chicago и UC Berkeley Sky Computing Lab опубликовали статью о фреймворке EnvOpt (arXiv:2611.07372) и выложили часть кода на GitHub. Фреймворк берёт на себя оптимизацию того, что авторы называют «стационарным окружением» агента: структуры файлов, представлений данных и списка доступных инструментов, тогда как параметры модели и harness остаются неизменными. Оптимизацией занимается отдельный Research Agent: он итеративно перестраивает окружение на обучающих задачах, анализируя траектории Target Agent, причём верификаторы на этом этапе сознательно не используются, чтобы исключить reward hacking, а контроль качества вынесен на скрытые проверочные запросы. Результаты проверяли на пяти бенчмарках, включая AutomationBench, Workspace-Bench и Data-Eng-Bench, на невидимых тестовых наборах, где pass rate сохранялся или рос. Конкретная точка на AutomationBench: стоимость самой оптимизации составила около $150, а экономия достигла 77.5% расходов на запуски Claude Opus 4.8.
Контекст
EnvOpt добавляет в стек LLM-агента третью ось оптимизации. Раньше системно настраивали в основном две: параметры модели и harness, то есть обвязку вокруг модели, а окружение, в котором агент работает, менялось вручную. Идея авторов в том, что заметная часть стоимости агентного инференса сидит не в модели, а именно в окружении. Механизм экономии здесь инженерный, а не обучающий: сокращаются входные токены в результатах вызовов инструментов. Агент заранее получает индексы файлов, карты таблиц SQLite и шпаргалки с API-эндпоинтами сервисов вроде Jira, Slack и Xero, а нужные данные подгружаются префетчем, вместо того чтобы каждый раз искать и читать всё с нуля. Такой контекст-инжиниринг окружения, по словам авторов, переносится между моделями и harness. Для калибровки ожиданий полезно сравнение с Meta-Harness: EnvOpt даёт +9.67% pass rate, обходясь при этом в 15% его стоимости.
Почему это важно для индустрии
Для отрасли EnvOpt легализует окружение как полноценный объект инженерии наряду с параметрами модели и harness. Если цифры подтвердятся независимыми воспроизведениями, «environment tuning» может стать стандартным шагом подготовки агентных пайплайнов рядом с выбором модели и промптами, а вокруг него вырастут собственные инструменты и бенчмарки. Юнит-экономика агентных продуктов при этом может улучшаться без переобучения и без смены провайдера модели: часть расходов вырезается из окружения, а не из способностей модели. Переносимость оптимизированного окружения между моделями и harness особенно ценна для корпоративных развёртываний, где стек моделей периодически меняется, а перестраивать окружение заново каждый раз дорого. Важно сохранять масштаб ожиданий: это исследовательская работа с частично открытым кодом, а не готовый продукт, поэтому сегодня она работает скорее как референс для внутренних практик, чем как то, что можно включить в свой стек одним переключателем.
Почему это важно для пользователей
Если вы запускаете LLM-агентов на реальных задачах, главный практический вывод в том, что часть расходов можно срезать, изменив не модель, а то, как ей поданы данные и инструменты. Сами приёмы воспроизводятся руками уже сейчас и без всякого фреймворка: снабдите окружение агента индексами файлов, картами таблиц вашей базы и шпаргалками с API-эндпоинтами, а данные, которые нужны чаще всего, подгружайте заранее, тогда входные токены заметно сократятся. Тем, кому интересна автоматизация процесса, стоит следить за репозиторием itea1001/EnvOpt на GitHub, где опубликована часть кода (на момент публикации у репозитория 5 звёзд): пока доступны бенчмарк Workspace-Bench и окружения на Hugging Face (itea1001/EnvOpt-WorkspaceBench), а Data-Eng-Bench обещают выложить после восстановления сервера. Самая содержательная часть, доступная каждому прямо сейчас, — статья на arXiv: из неё можно выписать приёмы и примерить к собственным пайплайнам.
Что пока неизвестно / ограничения
Все ключевые цифры — авторские и получены на собственных бенчмарках команды: независимых воспроизведений пока нет, как и обсуждений в сообществе. Код опубликован частично, поэтому напрямую «включить EnvOpt» в свой стек пока нельзя, а эффект, вероятно, сильно зависит от типа задач и структуры конкретного окружения, так что средние показатели не являются гарантией для отдельного пайплайна. Отдельная оговорка касается вывода о том, будто оптимизированное окружение позволяет модели уровня Haiku 5.5 догонять Opus 5: по источнику такое равенство показано на авторских бенчмарках внутри оптимизированного окружения и не описывает общий уровень способностей модели. До независимой проверки это нельзя подавать читателю как «дешёвая модель заменяет дорогую».
Источники
- EnvOpt: Automated Optimization for Agent Environments — блог Bespoke Labs
- EnvOpt: Automated Optimization for Agent Environments (arXiv:2611.07372)
- itea1001/EnvOpt — репозиторий кода на GitHub
Автор
Look at AI, редакция