Linux Foundation Research совместно с Red Hat, Futurewei, OpenSSF и LF AI & Data опубликовала отчёт «Navigating Open Source Software Development in the Generative AI Era» о том, как генеративный ИИ меняет разработку открытого кода. По данным опроса, на котором построено исследование, около четверти входящих pull request в open source-проекты — некачественные массово сгенерированные ассистентами вклады, так называемый «AI slop». Разбор таких изменений ложится на мейнтейнеров вручную, а приток сгенерированного кода растёт быстрее, чем возможности его проверять.
Что произошло
Отчёт подготовили Сэм Бойзел (Linux Foundation) и Анни Лай (Generative AI Commons), предисловие написал Брайан Проффитт (Red Hat); работе присвоен DOI 10.70828/BUHS3754. В его основу лёг опрос участников open source-экосистемы: выгорание мейнтейнеров крупных проектов респонденты назвали главной проблемой. Полный текст в формате PDF объёмом 6,6 МБ выложен бесплатно, а исходные данные исследования опубликованы на Zenodo, то есть выводы можно проверять по первичным материалам. Публикация отчёта также стала темой отдельного обсуждения на Hacker News.
Контекст
Обычная модель open source держится на людях: внешние разработчики присылают pull request, а мейнтейнеры — часто волонтёры — проверяют и принимают изменения в проект. Генеративные ассистенты резко удешевили производство кода, и центр тяжести сместился с написания на проверку: создать вклад можно за минуты, а разобрать его по-прежнему способен только человек. Термин «AI slop» обозначает массово сгенерированные ассистентами вклады низкого качества, которые засоряют очередь ревью. Дополнительный вес отчёту придаёт организационный бэкинг: за ним стоят Linux Foundation, OpenSSF и профильные подразделения вендоров, поэтому документ может стать ориентиром при выработке правил приёма вкладов в крупных проектах.
Почему это важно для индустрии
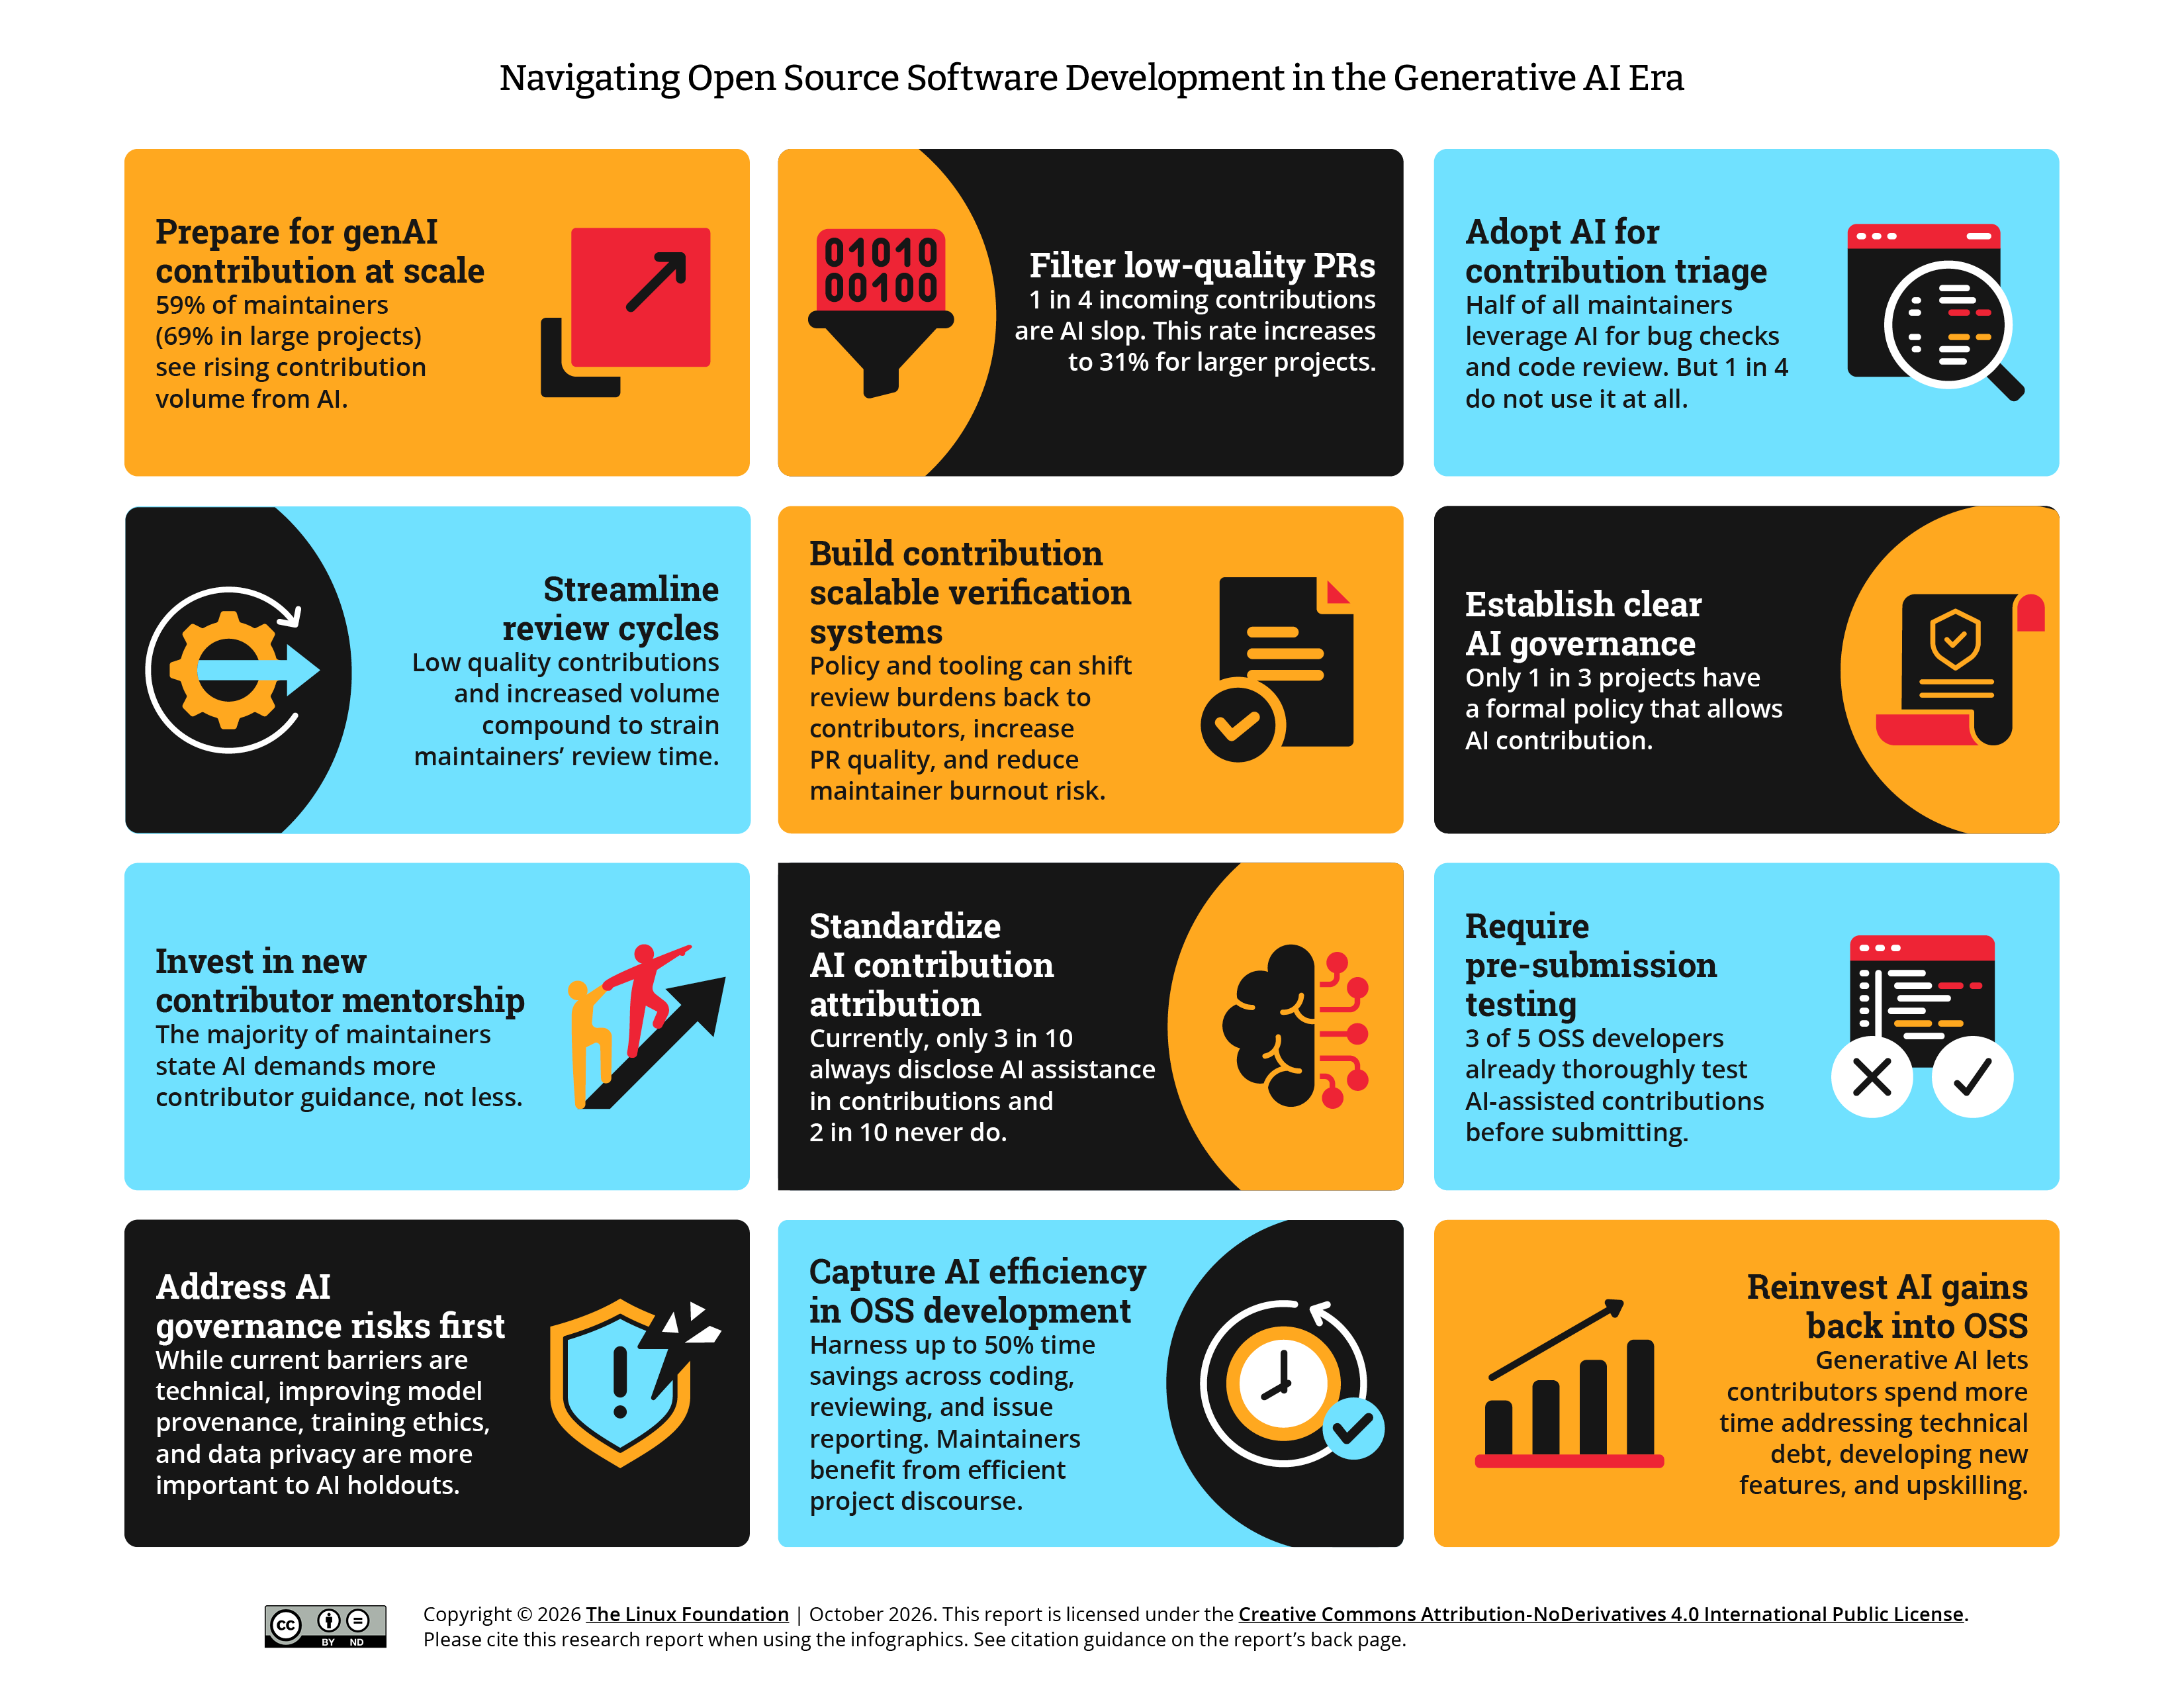
Для индустрии дефицит в open source смещается: если раньше не хватало контрибьюторов, теперь не хватает доверия к вкладам. Формальные политики приёма ИИ-вкладов есть лишь примерно у трети проектов, поэтому приём изменений держится на ручной модерации, которая при массовом притоке сгенерированного кода перестаёт масштабироваться. Авторы отчёта призывают переходить от реактивной модерации к формальному AI-governance и системам верификации вкладов. Для билдеров это читаемый сигнал спроса: инструменты triage ИИ-вкладов, автоматизация политик приёма и проверка происхождения кода. Если тренд подтверждят независимые измерения, ожидаемы первые автоматические гейты качества PR в CI крупных проектов и практика маркировки ИИ-ассистированных изменений — это прогнозная интерпретация, а не факт отчёта.
Почему это важно для пользователей
Если вы отправляете pull request в мейнстрим-проекты или используете кодогенерацию в работе, учитывайте: ИИ-ассистированные вклады всё чаще встречают фильтры качества, так что стоит быть готовым к ручной проверке и отказам, в том числе без развёрнутых объяснений. Перед отправкой изменений разумно проверить, есть ли в проекте правила приёма ИИ-вкладов, и честно помечать использование ассистентов. Обратная сторона тоже важна: по самооценкам разработчиков, ИИ-инструменты экономят от 19% до 52% времени в зависимости от типа задачи — на верхней границе это почти половина рабочего времени. Материалы отчёта открыты: полный PDF и исходные данные на Zenodo доступны бесплатно, поэтому цифры можно проверить самостоятельно, прежде чем опираться на них в своих процессах.
Что пока неизвестно / ограничения
Ключевые цифры отчёта — самоотчётные: из доступного пересказа не видно, кто и по каким признакам классифицировал «AI slop»; если это восприятие мейнтейнеров из опроса, а не аудит диффов, «четверть PR» измеряет мнение, а не фактическую долю вкладов. Оценка экономии времени дана без базовой линии и контролируемого сравнения, так что границы диапазона, особенно верхняя, могут быть завышены. Это отраслевой опрос экосистемы Linux Foundation с участием вендоров, а не рецензируемая работа, и выборка потенциально может отражать интересы инфраструктурных компаний. Рекомендации авторов остаются на уровне governance: готовых технических инструментов верификации вкладов отчёт не предлагает, а автоматическое выявление сгенерированного кода — по сути нерешённая задача eval-методологии. Смягчающий фактор: DOI и открытые исходные данные на Zenodo дают материал для независимой репликации.
Источники
- Linux Foundation Research: Navigating Open Source Software Development in the Generative AI Era
- Полный текст отчёта (PDF, Linux Foundation)
- Обсуждение на Hacker News (id 50497105)
Автор
Look at AI, редакция