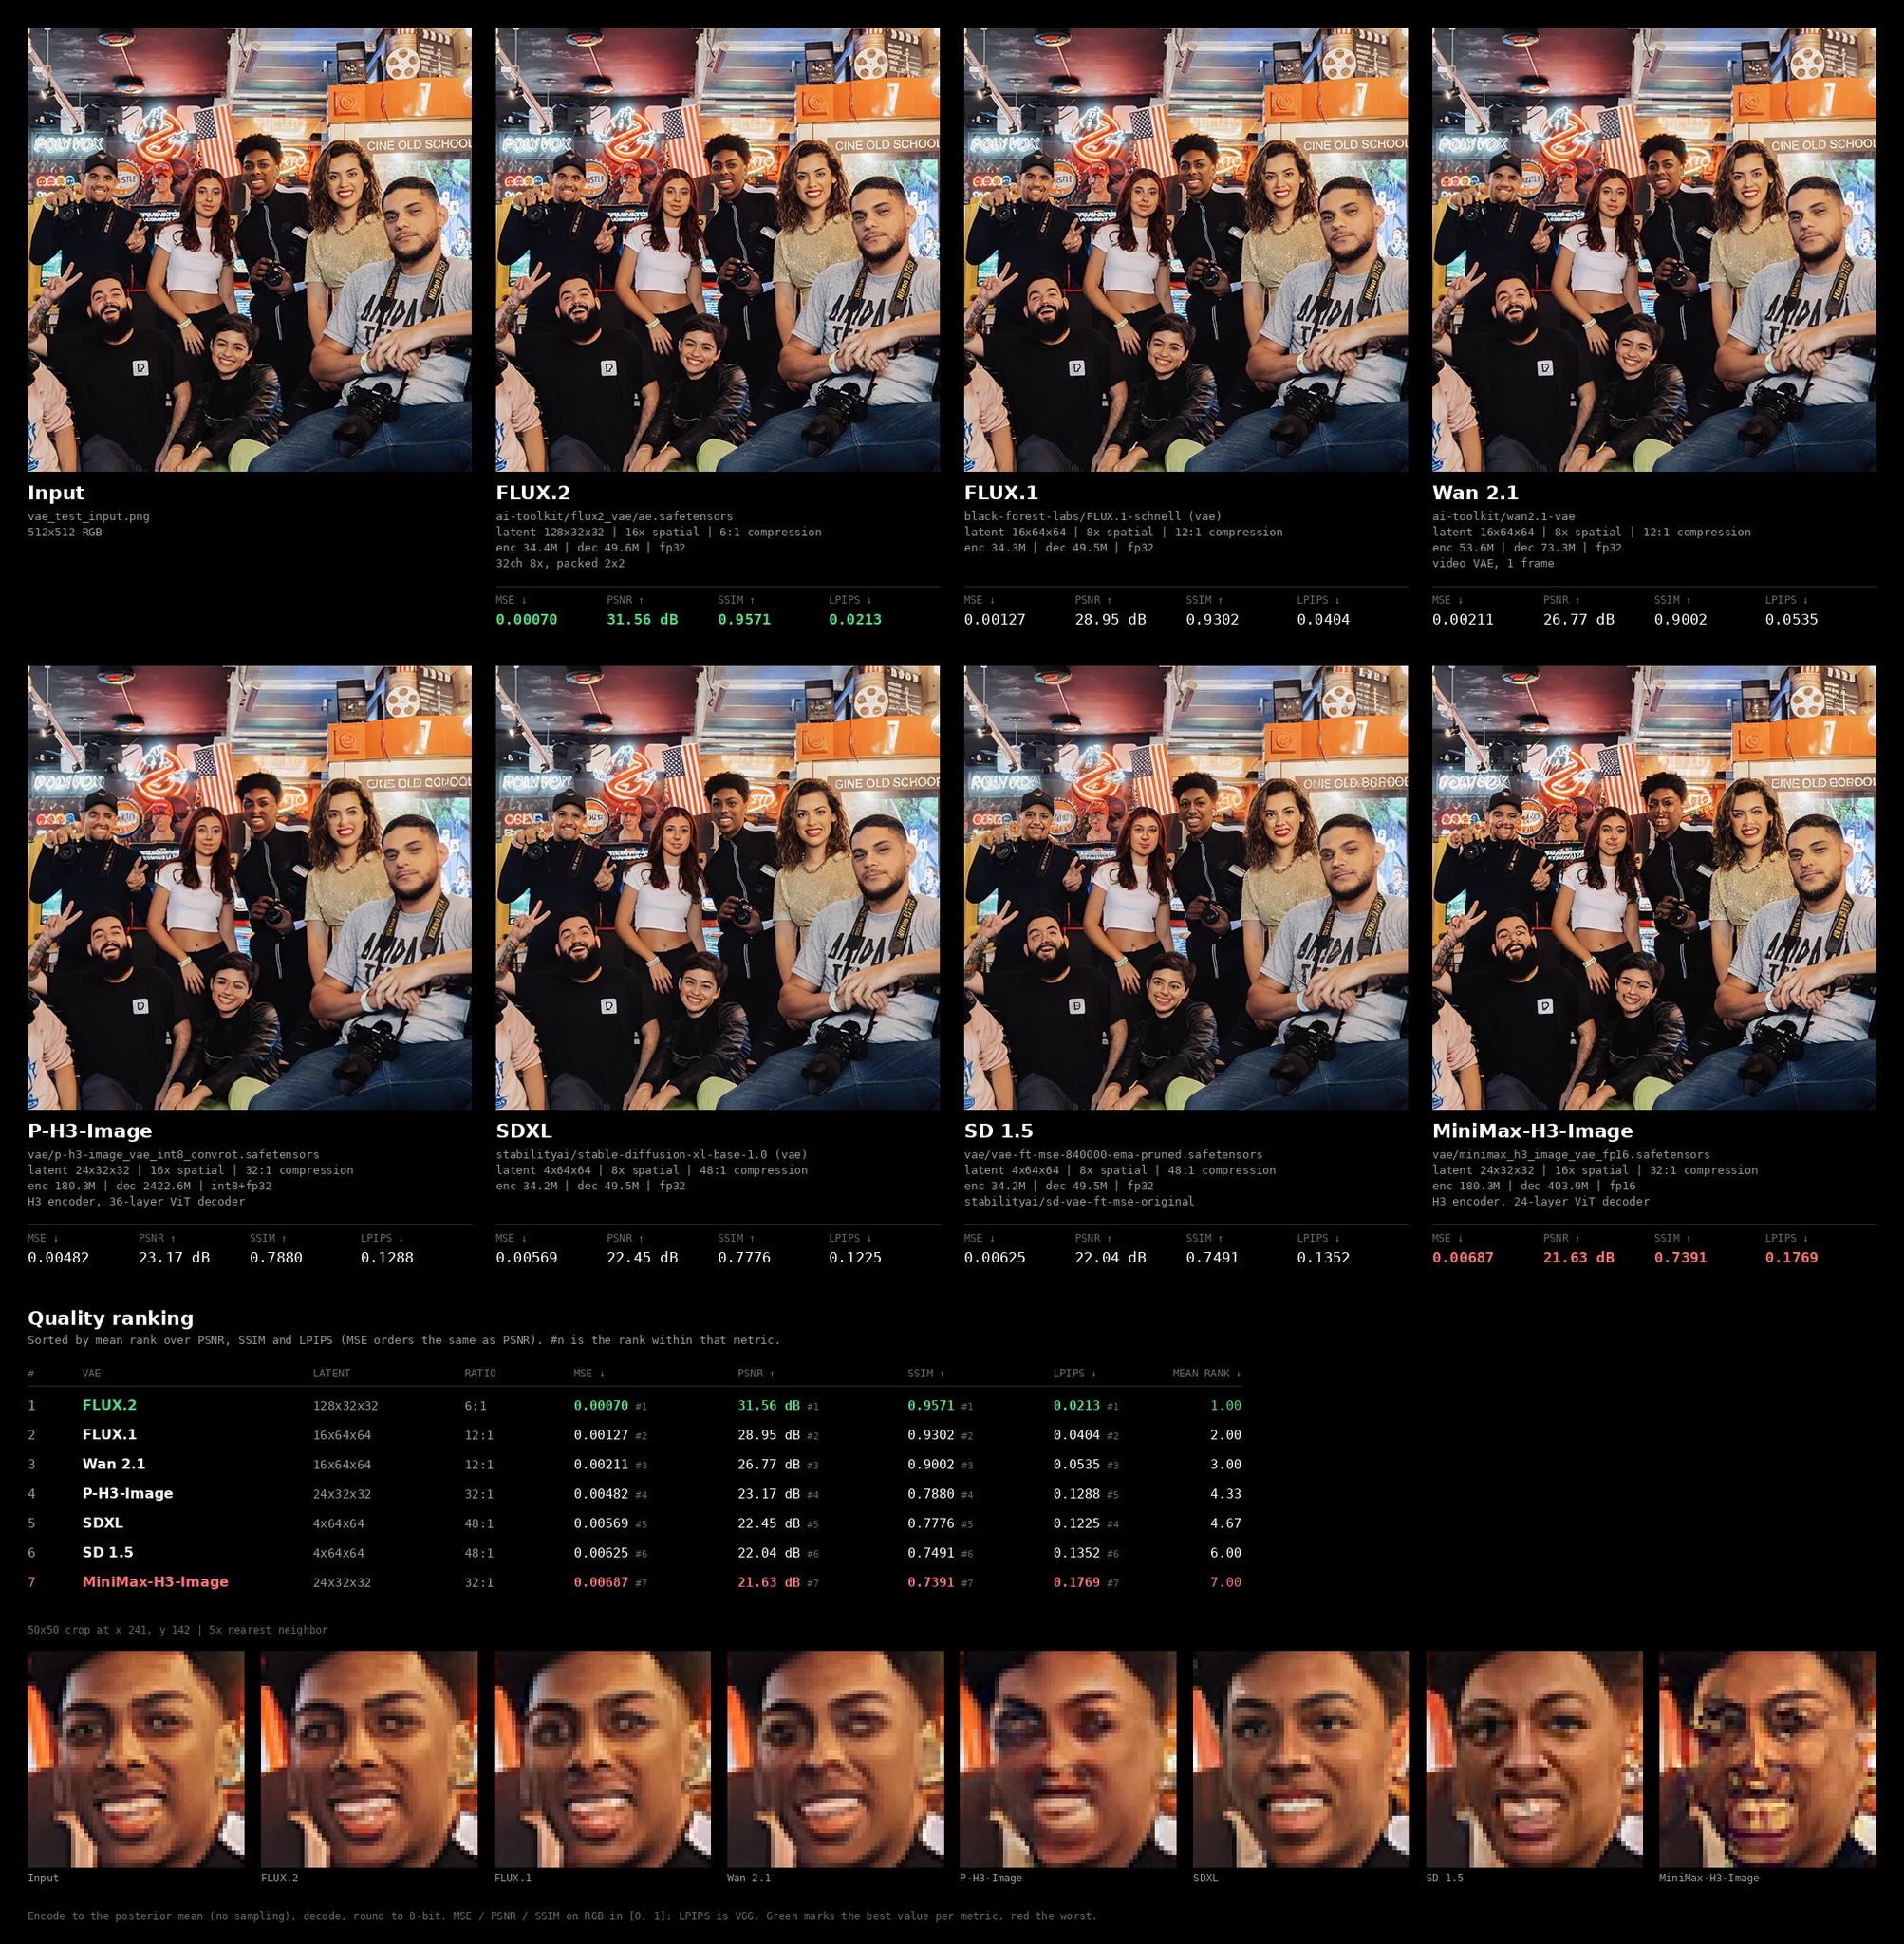
Разработчик Ostris, автор AI Toolkit, опубликовал round-trip-тест популярных автоэнкодеров, и открытая модель MiniMax H3-Image проиграла его по всем метрикам реконструкции, уступив даже VAE из SD 1.5. Виноваты не сборка и не настройки, а архитектура: ради скорости модель наследует у видеомодели H3 вдвое более сжатый латент, чем у класса Flux, и расплачивается детализацией на больших разрешениях. Сообщество ответило быстро: уже существует рабочий обход со сменной VAE от Pruna, хотя он лишь смягчает артефакты, а не устраняет их причину.


Что произошло
11 ноября 2026 года Ostris (@ostrisai, автор AI Toolkit) опубликовал round-trip-тест самых популярных VAE: одни и те же изображения пропускаются через энкодер и декодер, что изолирует качество автоэнкодера от качества генерации диффузионного трансформера. Автоэнкодер открытой модели MiniMax H3-Image, чей анонс и open-weight выпуск состоялись 10 ноября 2026 года (трансформер DiT на 33,1 млрд параметров, заявлена генерация 4K/16 МП менее чем за 10 секунд), проиграл по всем метрикам реконструкции, уступив даже VAE из SD 1.5. Ostris сформулировал вывод напрямую: «The main reason H3 Image struggles on detail is that it has a highly compressed latent space». В обсуждениях на r/StableDiffusion оперативно появился рабочий обход: альтернативная VAE из репозитория Pruna, сэмплеры SA Solver или SGM Uniform и генерация в 16 МП с последующим уменьшением до рабочего размера.
Контекст
MiniMax H3-Image построена на видеомодельной базе H3 и наследует её латентное пространство. Согласно официальному репозиторию MiniMax-AI/MiniMax-H3-Image, Image VAE состоит из CNN-энкодера с 16-кратным пространственным даунсэмплингом и патчем 2×2, что даёт 32×32 пикселя на один токен трансформера при 24 латентных каналах, а за восстановление отвечает 2D ViT-декодер на 24 слоя. У моделей класса Flux сжатие вдвое мягче — 16×16 пикселей на токен. Плотный латент сокращает число токенов, поэтому ускоряет генерацию и экономит VRAM, но переносит больше работы на декодер: чем сильнее сжатие на входе, тем больше деталей необратимо теряется ещё до этапа генерации. Это осознанный компромисс за скорость, а не дефект сборки, и именно он размывает границу между маркетинговым «16 МП» и фактической детализацией — цифра разрешения описывает формат кадра, а не количество выжившей информации.
Почему это важно для индустрии
Для индустрии кейс формирует продуктовый шаблон: модель как быстрый DiT плюс сменный VAE, то есть компромиссы big-lab релизов можно исправлять без пересборки основного трансформера. Скорость открытой экосистемы показательна: альтернативная VAE-сборка Pruna набрала около 978 тысяч загрузок примерно за две недели, архитектура штатного VAE уже разобрана в официальном репозитории, а дообучение декодера стало отдельным направлением — им занимается и сам Ostris. H3-Image остаётся пригодной для продакшена как «быстрый режим»: генерация 4096×4096 менее чем за 10 секунд, в том числе на потребительском GPU, при выгодной юнит-экономике по compute. Командам стоит перекалибровать оценку моделей: скорость здесь выкуплена ёмкостью латента (32×32 px на токен против эквивалентных 16×16 у Flux-класса), поэтому обещания «16 МП» из анонсов нельзя читать как метрику качества, а выбор VAE, судя по динамике кейса, превращается в отдельный слой конфигурации инференса наряду с выбором сэмплера и точностью весов.
Почему это важно для пользователей
Тем, кто использует MiniMax H3-Image в ComfyUI, стоит поставить VAE из репозитория PrunaAI/P-H3-Image-Comfy — bf16-версию p-h3-image_vae_bf16.safetensors (5,56 ГБ) либо инт8-версию p-h3-image_vae_int8_convrot.safetensors (3,15 ГБ), попробовать сэмплеры SA Solver или SGM Uniform и генерировать в 16 МП с последующим уменьшением до нужного размера: на этих конфигурациях артефакты сжатия менее заметны. Цена обхода — дополнительные 3,15–5,56 ГБ весов и один-два лишних шага пайплайна. Если на мелких деталях — текстурах, лицах, мелком тексте — картинка всё равно выглядит «мыльной», это свойство сжатого латента, а не ошибка ваших настроек: для таких задач пока лучше подходят модели с менее сжатыми VAE, например класс Flux.
Что пока неизвестно / ограничения
Обход из сообщества корректно считать смягчением артефактов, а не решением: подмена декодера не может восстановить информацию, потерянную при сжатии на этапе энкодера. В пересказе round-trip-теста утверждается, что H3 VAE проигрывает VAE из SD 1.5 по всем метрикам, но сами метрики, тестовый набор и параметры кодирования нигде не названы — результат репутационно сильный, но формально невоспроизводимый. Для сборок Pruna собственные round-trip-метрики также не опубликованы, поэтому выигрыш в качестве пока подтверждается практикой использования, а не числами. Официальная реакция MiniMax на диагностику неизвестна, а дообученный декодер, над которым работает Ostris, — ожидаемое, но ещё не выпущенное дополнение.
Источники
- Ostris on X — round-trip-тест VAE и формулировка о сжатом латентном пространстве H3 Image
- MiniMax-AI/MiniMax-H3-Image — официальный репозиторий модели с описанием Image VAE
- PrunaAI/P-H3-Image-Comfy — репозиторий на Hugging Face с альтернативной VAE-сборкой для H3-Image
Автор
Look at AI, редакция