Компания Lightricks опубликовала техническую статью и arXiv-бумагу (arXiv:2501.00103) о модели LTX-Video — трансформерной латентной диффузионной модели для генерации видео в реальном времени. На Nvidia H100 она создаёт 5 секунд ролика 768x512 при 24 кадрах в секунду примерно за 2 секунды, то есть быстрее, чем длится сам ролик. Video-VAE и денойзинг-трансформер в ней спроектированы как единая система, а код и веса открыты: модель можно запустить локально или через LTX API и LTX Playground.
Что произошло
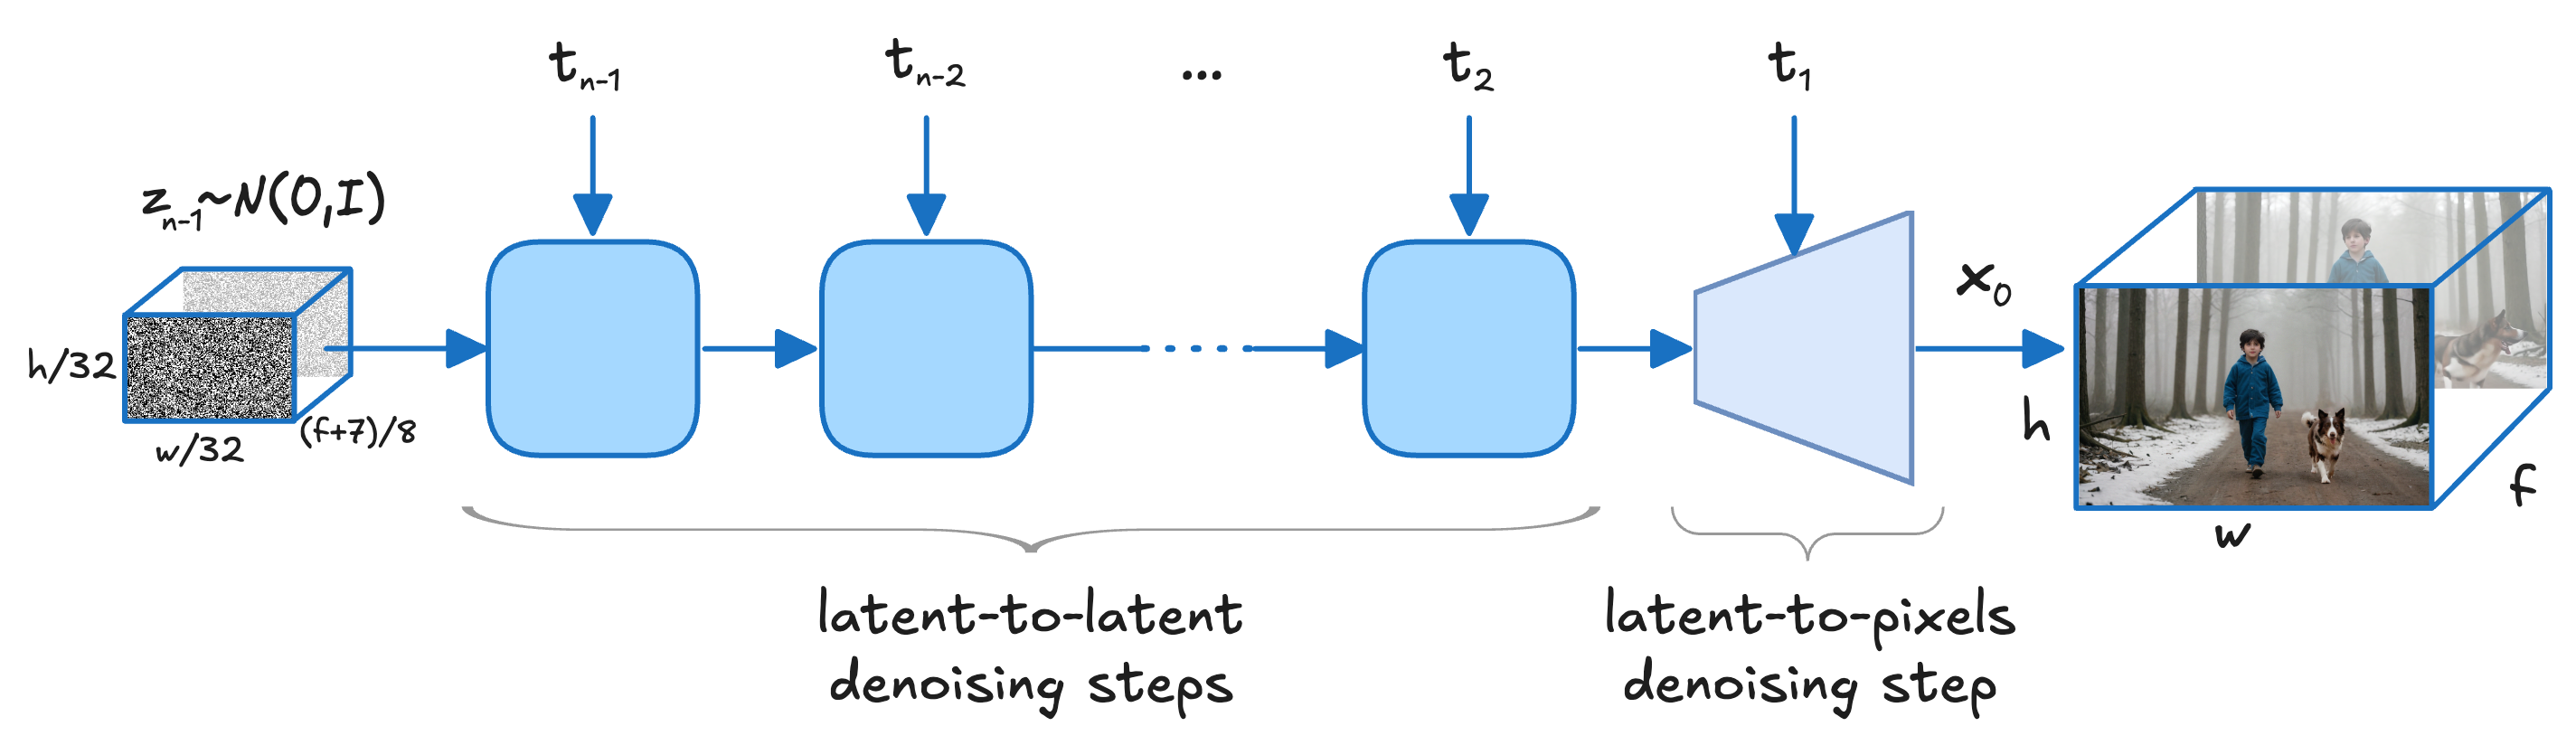
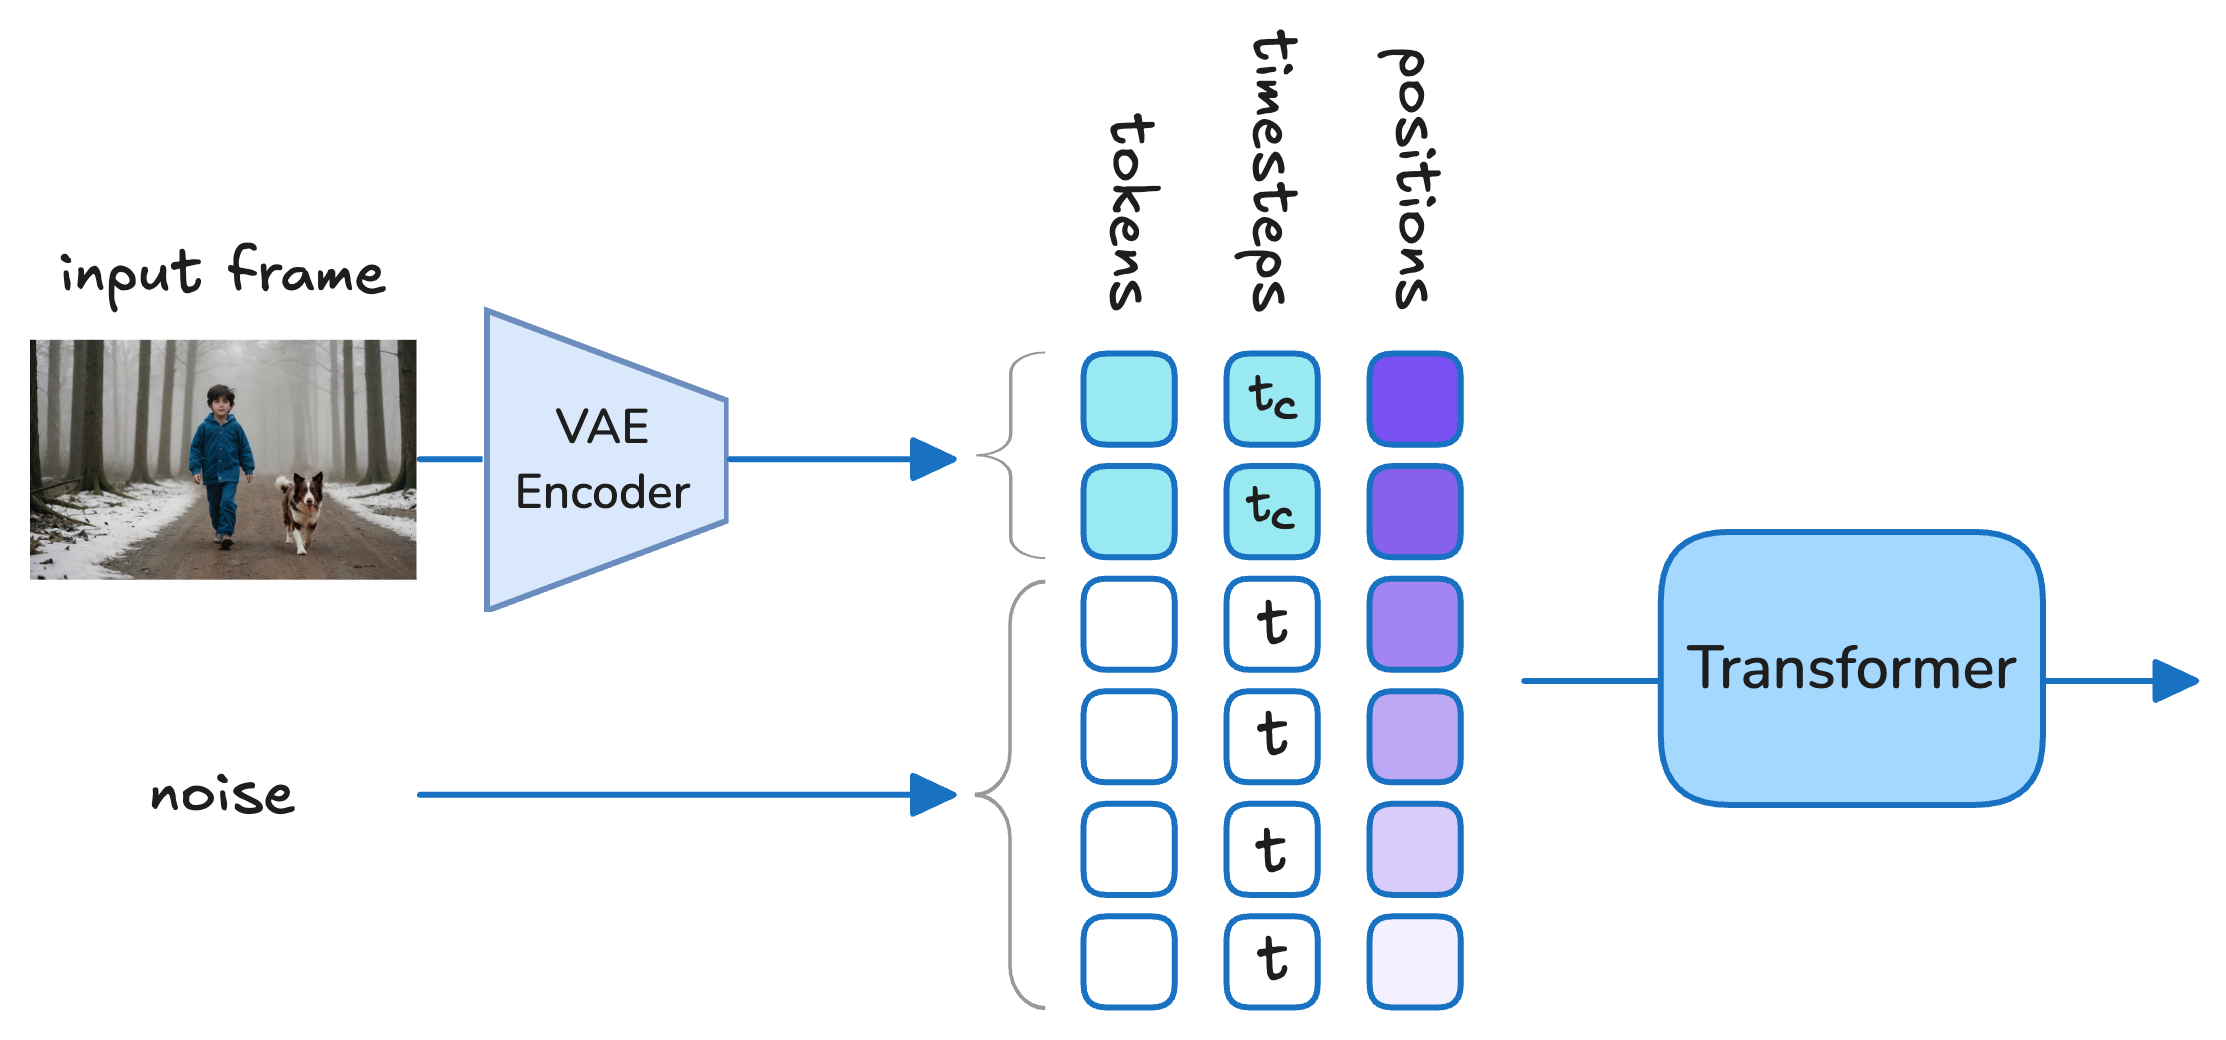
Lightricks выпустила техническую статью «LTX-Video: Realtime Video Latent Diffusion» и сопроводительную работу на arXiv под номером arXiv:2501.00103, описывающую трансформерную латентную диффузионную модель для видеогенерации. Ключевое решение публикации: Video-VAE и денойзинг-трансформер проектировались как единая система, а не как независимые друг от друга компоненты. VAE сжимает видео с коэффициентом 1:192, то есть один токен соответствует блоку 32x32x8 пикселей, благодаря чему трансформер выполняет полное пространственно-временное self-attention и кадры остаются согласованными во времени. Декодер VAE одновременно восстанавливает пиксели и выполняет финальный шаг шумоподавления, поэтому отдельный апскейлер в пайплайне не требуется. Одна и та же модель обучается на задачах text-to-video и image-to-video. Авторы сообщают, что модель превосходит существующие модели сопоставимого размера, а код и предобученные веса выложены в открытый доступ.
Контекст
LTX-Video построен на латентной диффузии: генерация идёт не в пикселях, а в сжатом представлении видео, которое готовит Video-VAE, а трансформер шаг за шагом очищает это представление от шума. Стоимость такой генерации напрямую зависит от количества токенов, которые видит трансформер, поэтому степень сжатия VAE оказывается центральным параметром всей архитектуры, а не технической мелочью. Ставка на агрессивное сжатие делает вычислительно посильным полный пространственно-временной self-attention, при котором трансформер обрабатывает сцену целиком; из этого согласованность движения между кадрами следует из самой архитектуры, а не обеспечивается отдельными модулями движения поверх базовой модели. Совместное проектирование компонентов сокращает и число стадий пайплайна: там, где декодер закрывает сразу две задачи, из цепочки выпадает стадия апскейла, без которой видеогенераторы традиционно не обходятся, а каждая лишняя стадия удлиняет и удорожает генерацию.
Почему это важно для индустрии
Для отрасли LTX-Video показывает, что рилтайм-генерация видео достижима без компромисса на отдельном апскейлере: совместное проектирование VAE и денойзера с агрессивным сжатием латента снижает вычислительную стоимость, а общая модель для text-to-video и image-to-video избавляет от поддержания отдельных веток пайплайна. Для интерактивных приложений, live-контента и API-сервисов, где задержка критична, генерация быстрее реального времени перестаёт быть демо-фичей и становится строительной деталью продукта, а открытые код и веса дают два готовых пути внедрения — self-hosted и API. Если независимые замеры подтвердят цифры авторов, стоит ожидать давления на цены видеогенерации и обострения конкуренции в сегменте быстрых моделей: скорость и цена доступа перестают быть защищаемым преимуществом, и оно смещается в вертикальные данные, дистрибуцию и продуктовый слой, а рилтайм-задержка становится конкурентным полем среди видео-API. В более отдалённой перспективе, если подход выдержит проверку, связка «ко-дизайн VAE и денойзера плюс сильное сжатие латента» может стать стандартным шаблоном проектирования видео-диффузии, а генерация быстрее реального времени — базовым требованием к видео-моделям; тогда конкуренция сместится в качество деталей, управляемость и стоимость минуты генерации.
Почему это важно для пользователей
Уже сейчас можно скачать открытые веса и воспроизвести ключевой ориентир по скорости на арендованной Nvidia H100 либо быстро оценить модель без собственной инфраструктуры через LTX API или LTX Playground. Ориентир по оборудованию для воспроизведения заявленного рилтайма — именно H100: на менее мощных машинах задержка будет иной. Практическое окно сегодня — сценарии, где разрешения 768x512 достаточно: видеопревью по тексту в редакторах и конструкторах, оживление изображений, черновые ролики внутри агентов и автоматизаций. Для читателя это означает, что рилтайм-видеогенерация перестала быть гипотезой из демо: это воспроизводимый результат, который можно проверить самостоятельно на своих промптах.
Что пока неизвестно / ограничения
Заявление о превосходстве над моделями сопоставимого размера — это формулировка авторов: конкретные бенчмарки и методика сравнения в доступных материалах не названы, поэтому до независимых замеров её корректно считать заявкой, а не установленным фактом. Замер скорости привязан к Nvidia H100 — поведение на потребительском оборудовании и других ускорителях не подтверждено. Качество итогового ролика зависит от того, насколько хорошо декодер возвращает детали, потерянные при сильном сжатии, и это требует визуальной проверки на реальных промптах. Горизонт 768x512 ограничивает применимость в сценариях, где нужно высокое разрешение. Прогнозы о давлении на цены и смене конкурентных полей — оценки, а не состоявшиеся события; их стоит перепроверять по мере появления независимых воспроизведений.
Источники
- LTX-Video: Realtime Video Latent Diffusion | LTX Technical Blog
- LTX-Video: Realtime Video Latent Diffusion (arXiv:2501.00103)
Автор
Look at AI, редакция