Независимая организация METR (Model Evaluation and Threat Research) опубликовала оценку ускорения ИИ-разработки в Anthropic, проведённую с 12 августа по 29 октября 2026 года с высоким уровнем доступа к внутренним данным компании. Ключевой вывод: к октябрю 2026 года Anthropic, вероятно, улучшает возможности моделей на хорошо определённых задачах примерно в два раза быстрее, чем в период с марта 2024 по октябрь 2025 года, причём около 80% этого ускорения METR связывает с активным использованием ИИ в собственной исследовательской работе лаборатории. Убедительных бутылочных горлышек, способных остановить этот процесс, отчёт не выявил.
Что произошло
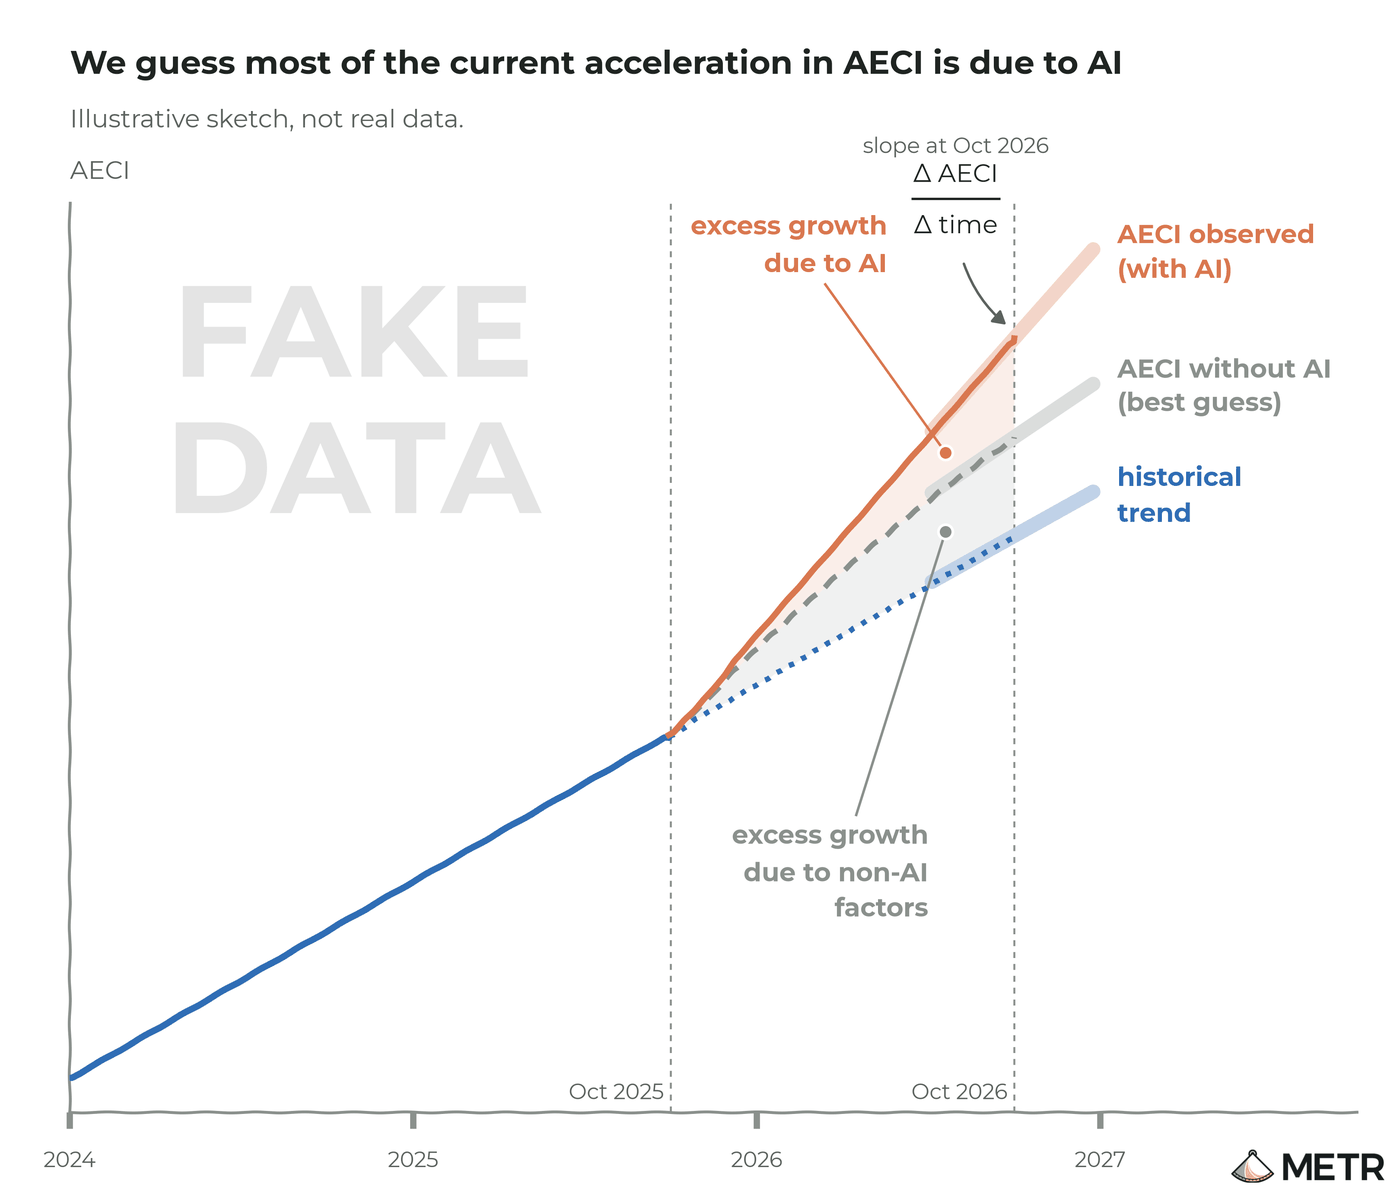
Отчёт опубликован в блоге METR 5 ноября 2026 года и описывает работу, которая велась с 12 августа по 29 октября 2026 года: команда получила высокий уровень доступа к внутренним данным Anthropic и опиралась на триангуляцию — внутренний индекс AECI (Anthropic Epoch Capabilities Index), интервью и самоотчёты сотрудников о скорости работы. Хедлайн-оценка — примерно 2x ускорения улучшения возможностей моделей при полном диапазоне неопределённости 1.3x–3x. По индексу AECI темп роста вырос с примерно 15 до примерно 29 баллов в год, то есть коэффициент 1.9x при 95% доверительном интервале 1.5–2.8x, что согласуется с хедлайном, но допускает и более скромный эффект. Самое громкое число — самоотчёты сотрудников об ускорении до примерно 12x на самой новой внутренней модели Model 4 против примерно 1.2x в начале 2025 года. Наряду с этим METR прямо констатирует, что убедительных бутылочных горлышек — в вычислениях, данных или алгоритмах — выявить не удалось.
Контекст
Спор о том, что ИИ-инструменты ускоряют создание более мощного ИИ, старше этого замера: до сих пор он держался на рассуждениях, прогнозах и косвенных демонстрациях, потому что внутренние данные разработчиков фронтир-моделей сторонние команды раньше не видели. METR — независимая организация по оценке моделей и угроз (Model Evaluation and Threat Research), и её работа стала первым независимым high-access замером подобного типа у одной из ведущих лабораторий. Принципиальная деталь методологии: основной замер выполнен на хорошо определённых задачах, именно там, где ИИ-ассистенты сильнее всего, и перенос результата на открытые и плохо поставленные исследовательские проблемы из этих данных не следует. Внутренняя модель Model 4, фигурирующая в самоотчётах, не является публичным продуктом: в доступных материалах нет данных о её API, цене или латентности. Методологическая рамка отчёта — глубокие интервью, телеметрия, проверенные самоотчёты и индекс темпа роста возможностей вроде AECI — сама по себе часть результата: она задаёт образец того, как измерять вклад ИИ в исследовательскую продуктивность вместо абстрактных прогнозов.
Почему это важно для индустрии
Для индустрии отчёт даёт первую внешнюю точку отсчёта по теме ускорения: у лабораторий и продуктовых команд появился измеримый ориентир, в виде двукратного темпа улучшения моделей с 80-процентной атрибуцией на ИИ, на который можно опираться в планировании и в спорах о таймлайнах. Одновременно отчёт усиливает переговорную позицию лабораторий, которые теперь могут аргументированно наращивать темп; следствие для всех остальных в том, что фичи вокруг фронтир-моделей устаревают быстрее, и командам стоит перепроверить роадмапы, вычистив из них фичи, которые следующая модель заберёт себе в ближайшие два релиза. Если бутылочные горлышка действительно не проявятся, стоит ожидать более плотного графика обновления возможностей: чаще пересобираются eval-сьюты, обновляются RAG-индексы и файнтюны, пересматриваются планы ёмкости и бюджеты под каждую новую модель. В сценарии устойчивого составного ускорения, когда ИИ-инструменты ускоряют создание более мощных моделей, которые в свою очередь усиливают сами инструменты, преимущество вокруг фиксированной версии модели быстро устаревает, а защищаемость смещается к данным, интеграциям, observability и независимым внутренним замерам качества.
Почему это важно для пользователей
Немедленно для продуктов и инструментов, которыми читатели пользуются каждый день, ничего не меняется: это отчёт, а не запуск, новых API или моделей он не открывает, а Model 4 остаётся внутренней разработкой Anthropic. Практическая ценность для читателя в другом: полный отчёт открыт на metr.org, и в одном месте там видно, как независимая организация измеряет ускорение ИИ через индекс роста возможностей, интервью и проверенные самоотчёты. Это наглядный пример отличия контролируемого замера от громкой цифры вроде 12x, которую сотрудник сообщает о собственной скорости, и честная демонстрация того, что субъективные самоотчёты смещены вверх и требуют проверки. Наконец, если выводы METR верны, более сильные модели будут появляться чаще, чем раньше, и независимая оценка задаёт ориентир для ожиданий по таймлайнам, с которым полезно сверяться наравне с анонсами самих лабораторий.
Что пока неизвестно / ограничения
Хедлайн около 2x опирается на внутренний индекс AECI и частично на самоотчёты сотрудников; нижняя граница по AECI, 1.5x, допускает заметно более скромный эффект. Самоотчёты о скорости субъективны, заведомо смещены вверх и не эквивалентны контролируемым замерам, то есть максимальные цифры из них фактом считать нельзя. Замер выполнен только на хорошо определённых задачах, поэтому экстраполяция на весь R&D лаборатории из этих данных не следует. Внешней репликации выводов в доступных материалах нет: триангуляция в значительной мере опирается на данные самой Anthropic. Неизвестно и то, останутся ли узкие места незаполненными дальше: сценарий составного ускорения остаётся гипотезой, а его экономическая сторона, включая растущую стоимость каждой следующей модели, выходит за пределы этой оценки.
Источники
- Independent Assessment of AI R&D Acceleration at Anthropic in October 2026 — METR
- METR: Independent Assessment of AI R&D Acceleration at Anthropic in October 2026 — AI Alignment Forum
- Independent Assessment of AI R&D Acceleration at Anthropic in October 2026 — METR Substack
Автор
Look at AI, редакция