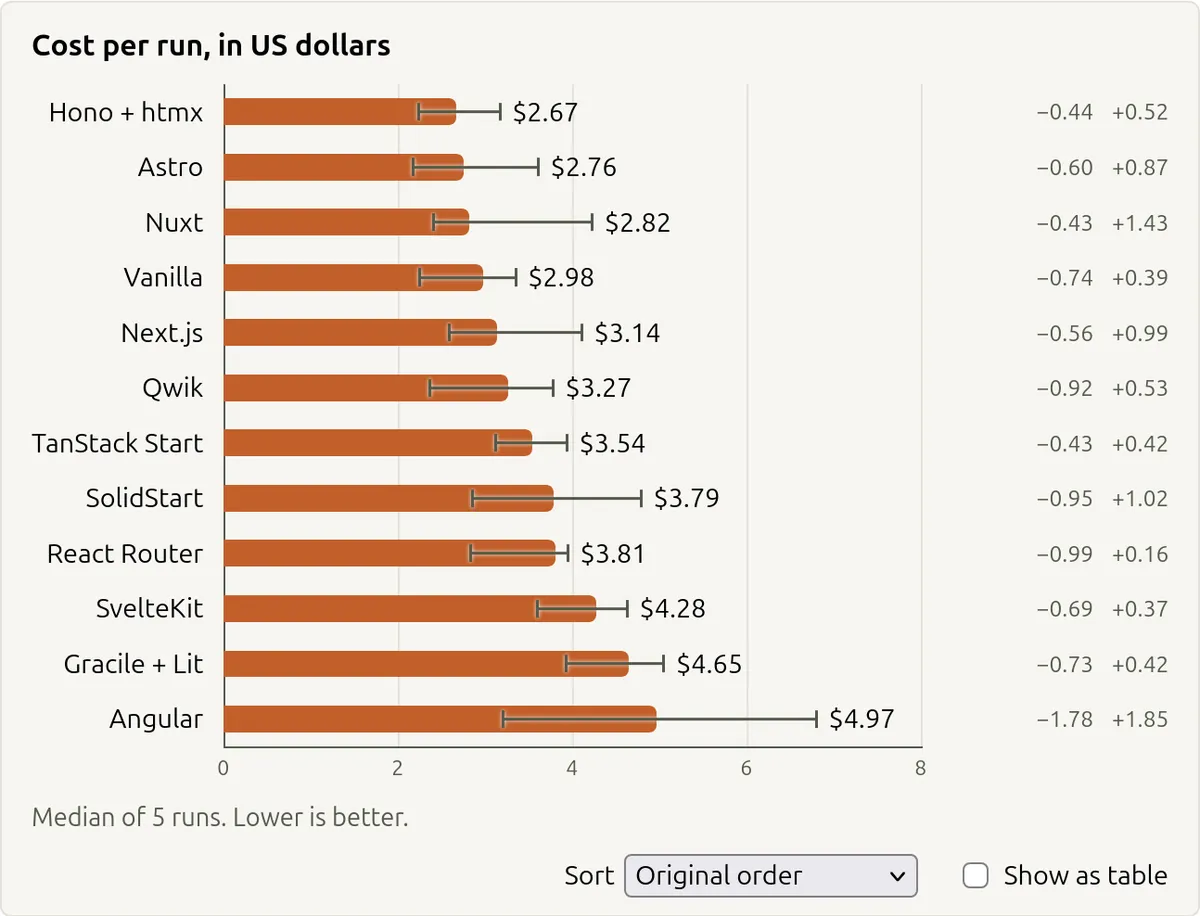
Nolan Lawson, создатель PouchDB и инженер Socket, опубликовал бенчмарк The AI cost of JavaScript frameworks: агент Claude Opus 5.5 (High Effort) строил одно и то же приложение-каталог Pokémon на 11 JavaScript-фреймворках и метафреймворках, и счёт за сборку через API отличался почти вдвое — от $2.67 на Hono+htmx до $4.97 на Angular. Основной вывод автора: в эпоху агентной разработки объём кода, который порождает стек, напрямую превращается в токен-расходы, причём не только на генерацию, но и на будущую поддержку.
Что произошло
28 октября Nolan Lawson запустил агента Claude Opus 5.5 в режиме High Effort в изолированной песочнице и дал ему одну и ту же задачу: собрать стандартное приложение-каталог Pokémon на данных PokéAPI. Эксперимент повторили на 11 JavaScript-фреймворках и метафреймворках, без CSS-фреймворков и без предгенерации HTML, чтобы отсечь посторонние факторы, а стоимость каждой сборки посчитали по реальным API-вызовам. Дешевле всего обошлась связка Hono+htmx: $2.67, 8.6 минуты и 4.26M токенов; рядом Astro с $2.76 и 8.2 минуты. Дороже всех оказался Angular: $4.97, 17.2 минуты и 9.76M токенов, что примерно в 1.9 раза дороже по деньгам и в 2.3 раза по токенам, чем Hono+htmx; в двух из пяти прогонов результат Angular не соответствовал спецификации.
Контекст
Nolan Lawson — создатель PouchDB и в настоящее время инженер Socket, поэтому за бенчмарком стоит практик, а не исследовательская лаборатория или маркетинговая команда. Смысл эксперимента держится на сдвиге в способе создания кода: когда приложение пишет AI-агент, многословность фреймворка перестаёт быть эстетической претензией, ведь каждая навязанная абстракция и каждая строка шаблонного кода оплачиваются токенами — агенту нужно и прочитать, и воспроизвести этот объём. Отсюда центральный тезис автора: размер сгенерированного кода определяет будущие токен-затраты на поддержку, и выбор стека превращается из вопроса вкуса в вопрос экономики.
Почему это важно для индустрии
Для индустрии здесь три следствия. Первое: в матрицы выбора стека добавляется измеримая переменная «AI-стоимость фреймворка» — сколько денег, токенов и времени агент тратит на сборку и сколько прогонов укладывается в спецификацию, что сдвигает аргументацию от ощущений к метрикам. Второе: в контентных продуктах с низкой интерактивностью закономерность склоняет выбор к MPA-подходам вроде Hono+htmx и Astro, показавшим лучшие результаты, тогда как тяжёлые SPA-стеки вынуждены доказывать, что их объём оправдан интерактивностью. Третье: методика готова к переиспользованию — одна эталонная задача, песочница, несколько прогонов и расчёт по API-вызовам дают командам фактически шаблон eval для агентного кодинга. Если репликации на других моделях подтвердят картину, от фреймворков, вероятно, начнут ожидать компактности и предсказуемой структуры для агентов, а следующим шагом могут стать CI-гейты, оценивающие AI-стоимость кодовой базы; это прогноз, а не измеренный факт.
Почему это важно для пользователей
Если вы выбираете стек для нового контентного сайта или пересматриваете текущий, в первую очередь стоит пересмотреть привычные метрики сравнения: в бенчмарке Lighthouse-скоры Performance (97–100) и Accessibility (100) оказались насыщены у всех участников и ничего не различали, поэтому общий балл Lighthouse — ненадёжный критерий выбора. Реальные различия сидели в размере JS-бандла и в Total Blocking Time: у Astro клиентского JavaScript было 0 КиБ против 142 КиБ у Next.js, а по TBT варианты с htmx и Astro показали 0 мс против 103 мс у Angular. Второй практический шаг — дешёвый аудит собственной кодовой базы: замерить, какой объём кода агент читает и пишет при типовой правке, потому что именно этот объём конвертируется в расход токенов на каждой итерации.
Что пока неизвестно / ограничения
У бенчмарка жёсткие границы применимости: тестировалась одна модель, Claude Opus 5.5 в режиме High Effort, на одном типе задачи — контентном каталоге с низкой интерактивностью. Переносить выводы на высокоинтерактивные SPA вроде дашбордов, на другие модели, уровни effort и версии фреймворков нельзя — нужны репликации, которых пока нет. Тезис автора о том, что размер кода определяет будущие токен-затраты на поддержку, правдоподобен, но методика измерения самой поддержки в опубликованных данных не описана, так что это гипотеза, а не измеренный факт. Абсолютные суммы пока невелики: разница между самым дешёвым и самым дорогим стеком составила около $2.3 за сборку простого приложения. Наконец, два провальных прогона из пяти у Angular указывают на заметный разброс внутри одного фреймворка, поэтому выводы о надёжности генерации требуют большего числа прогонов.
Источники
- The AI cost of JavaScript frameworks — Read the Tea Leaves (Nolan Lawson)
- The AI cost of JavaScript frameworks — Hacker News (обсуждение)
Автор
Look at AI, редакция