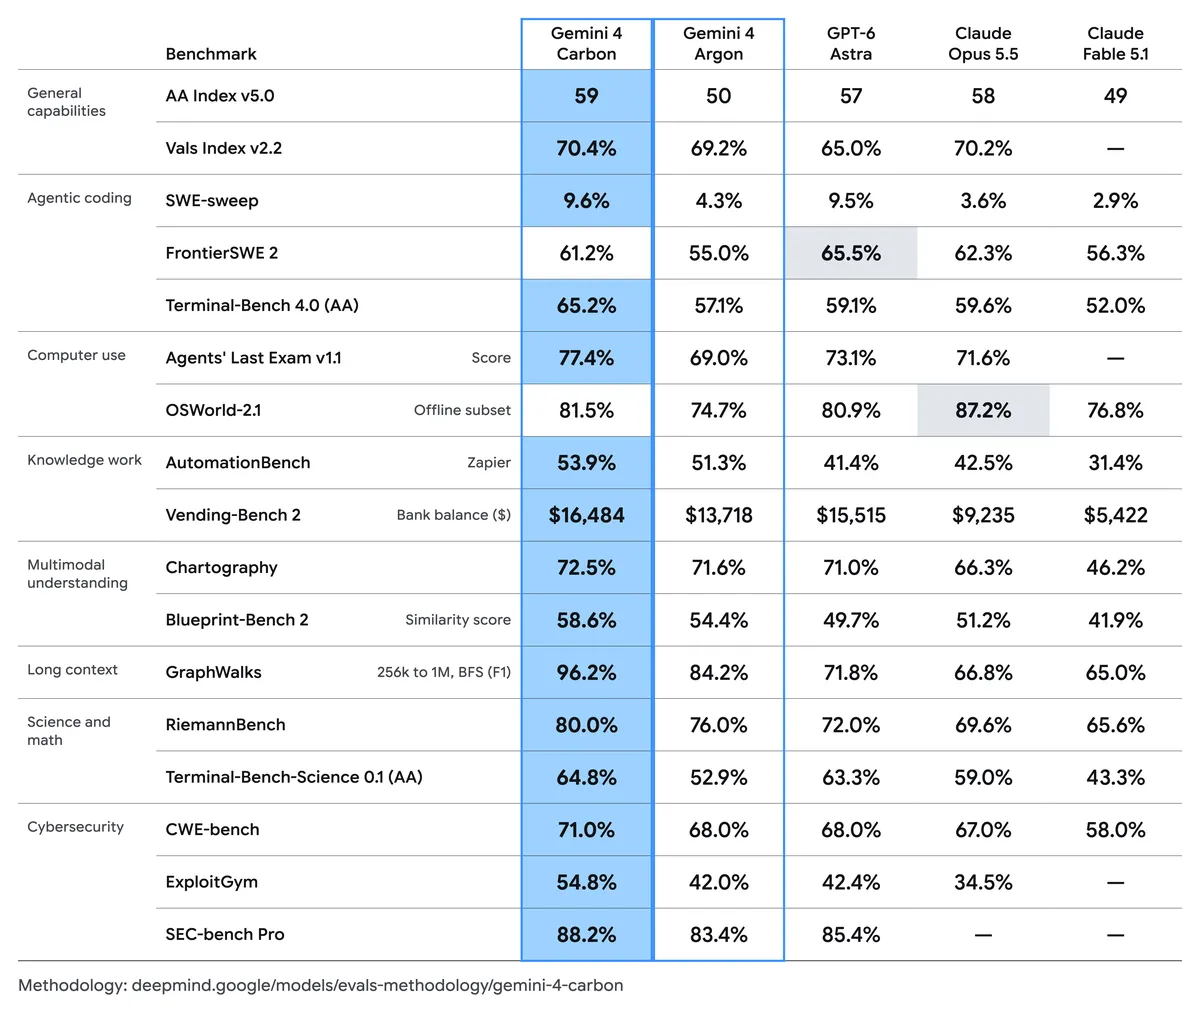
Google представила Gemini 4 Carbon — флагманскую модель, которая вышла всего через две недели после Gemini 4 Argon и заняла первое место в независимом рейтинге Artificial Analysis Intelligence Index v5.0 с результатом 59 баллов. Основная ставка — кибербезопасность: модель заявлена как инструмент полного цикла, от поиска реальных уязвимостей до готовых исправлений. Доступ открывают поэтапно, от узкого круга специалистов по ИБ к общему релизу, дата которого пока не названа.

Что произошло
Google выпустила Gemini 4 Carbon и сопроводила анонс набором метрик вокруг безопасности. Модель набрала 88,2% на SEC-bench Pro, где проверяется поиск реальных уязвимостей, 54,8% на ExploitGym, оценивающем проверку эксплуатируемости, и 71% на CWE-bench, где меряется генерация исправлений. В WebDev Arena Carbon показала 1768 Elo и четвёртое место, улучшив результат Argon на 89 Elo. В бенчмарке косвенного prompt injection от Gray Swan атаки не увенчались успехом ни разу: 0,0% против 0,7% у Argon. По внутренним тестам Google Carbon генерирует безопасный код более чем в два раза лучше, чем у Argon, а команда Chrome оценила её патчи более чем в 10 раз качественнее, чем у другой передовой модели. Заявлено также примерно на 80% меньше серьёзных нарушений инструкций в живых кодинг-средах и вдвое меньше необоснованных утверждений. Вводная цена API — $2 за миллион входных и $10 за миллион выходных токенов со скидкой 95% на кэшированный контекст.
Контекст
Анонс отличается от привычной гонки за общим интеллектом: Google впервые по этим данным позиционирует флагман прежде всего как инструмент защиты и упаковывает цикл «найти уязвимость → проверить эксплуатируемость → написать исправление» в одну специализацию с отдельной метрикой на каждом шаге. Это сдвиг от измерения общего интеллекта к измеримой вертикали — так складывается новая категория capability-репортинга среди frontier-лабораторий. Выпуск организован по схеме контроля доступа: сначала подмножество специалистов по кибербезопасности, затем партнёры через Fairwind Program и только потом общий релиз, причём Google отдала модель на добровольное претестирование правительству США. Так выпускаются frontier-модели с dual-use кибервозможностями: они попадают к пользователям не через открытый доступ, а по управляемой схеме. По метрикам есть развилка: первое место в Artificial Analysis Intelligence Index — сигнал стороннего агрегатора и потому независимый ориентир, тогда как security-бенчмарки предъявлены самим вендором.
Почему это важно для индустрии
Защита, упакованная в доступный API-примитив, — фундамент для нового класса SecOps-агентов и многодневных автономных воркфлоу, а также окно возможностей для слоя сервисов поверх примитива. Оборотная сторона — прямой демонтаж рва у вендоров точечных security-инструментов. Объявленный ценовой уровень не выше, чем у Argon, а глубокая скидка на кэшированный контекст пересчитывает юнит-экономику длинных агентных сессий: работа с большими кодовыми базами становится предсказуемой по деньгам, и этот уровень уже стоит закладывать в бюджетные модели на следующий год. Схема поэтапного выпуска dual-use моделей с претестированием выглядит кандидатом в норму для frontier-лабораторий, поэтому продуктовые планы разумно проектировать с расчётом на управляемый доступ. Практический шаг на сегодня: Argon остаётся рабочим дефолтом в продакшене, а пайплайн «поиск → верификация → патч» стоит строить как оркестратор, не привязанный к провайдеру модели.
Почему это важно для пользователей
Разработчикам и специалистам по SecOps Carbon задаёт ориентир на агентов, которые автономно работают днями: сами ищут причину бага в большой кодовой базе, восстанавливают контекст и возвращаются с готовым патчем; сценарий ночной сессии по техдолгу с утренним отчётом — ожидаемое развитие, а не текущая возможность. Для доверия к длинным агентным сессиям решающими становятся не отдельные рекорды, а честность модели и следование инструкциям: Google заявляет прогресс по обоим пунктам по сравнению с Argon, и именно это позволяет агенту часами работать без ручного контроля. Попробовать Carbon прямо сейчас не выйдет: широкий доступ не открыт, в продакшене рабочим вариантом остаётся Argon. Если вы занимаетесь исследованиями безопасности или работаете с партнёрами, доступ стоит запросить через Fairwind Program. Всем остальным имеет смысл заранее собрать собственные контрольные задачи, чтобы с появлением общего доступа честно сравнить Carbon и Argon на своих нагрузках — тогда же появятся первые сторонние данные о латентности, стабильности и реальной цене.
Что пока неизвестно / ограничения
Ключевые цифры пока требуют оговорок. Конфигурация оценки security-бенчмарков (SEC-bench Pro, ExploitGym, CWE-bench) не раскрыта, поэтому сопоставимость с опубликованными результатами других моделей неочевидна. Заявление команды Chrome о качестве патчей — внутренняя оценка без названия соперника и критериев; то же относится к внутренним метрикам поведения агента, включая честность и следование инструкциям. Независимая проверка невозможна, пока доступ ограничен подмножеством специалистов по ИБ и партнёрами Fairwind Program, а дата общего релиза не объявлена. Нет данных о латентности, размере контекстного окна и лимитах запросов. Первое место в Artificial Analysis Intelligence Index остаётся самым независимым из приведённых сигналов, но и оно говорит о рейтинге, а не о поведении модели в конкретных production-нагрузках.
Источники
- Introducing Gemini 4 Carbon — Google The Keyword (официальный блог Google)
- Google's Gemini 4 Carbon AI finds 88.2% of security flaws — Interesting Engineering
Автор
Look at AI, редакция