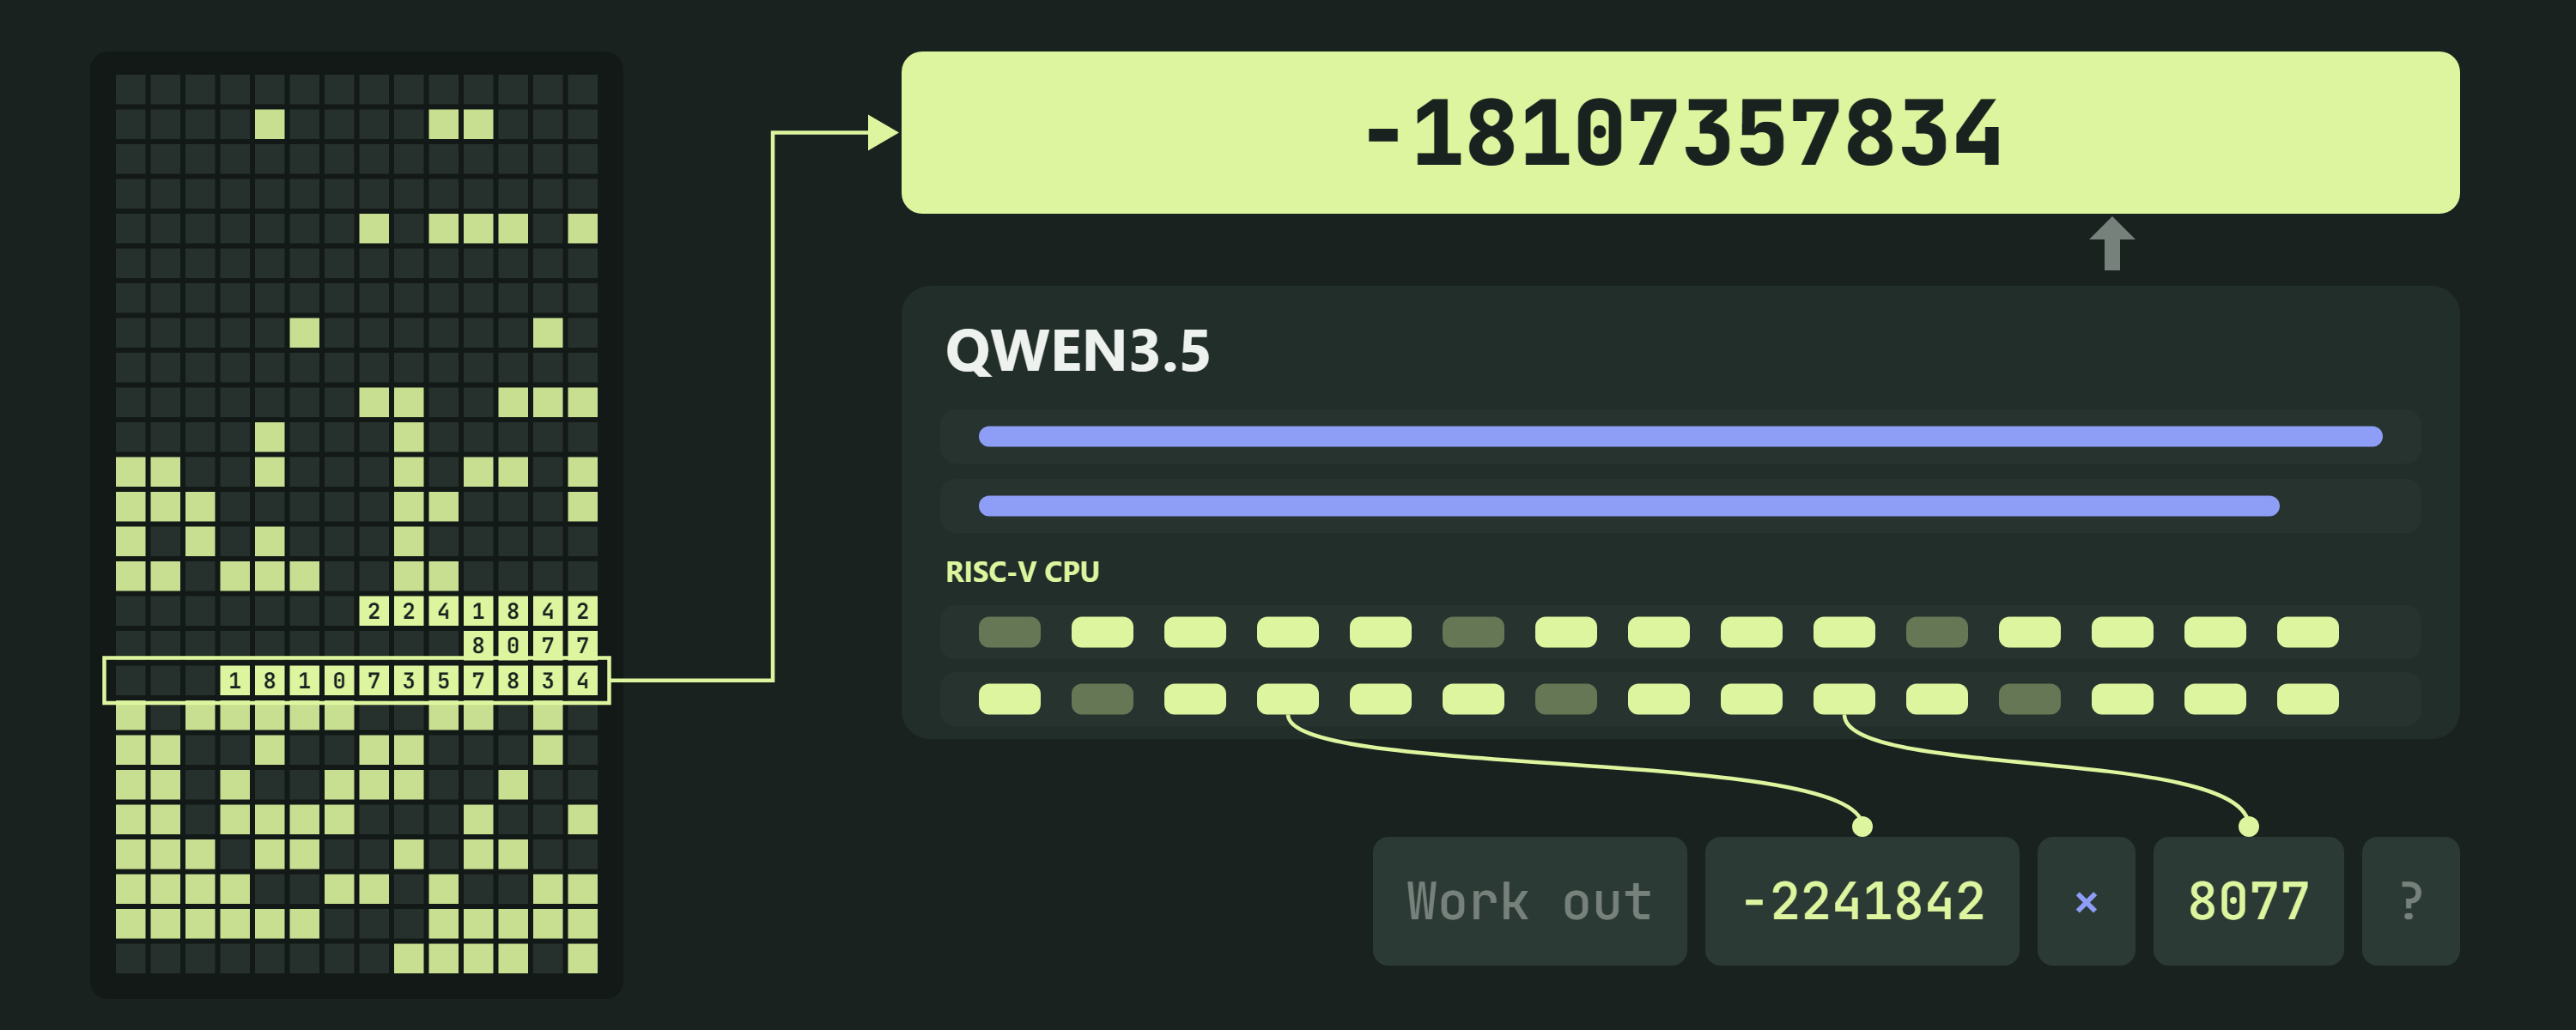
Разработчик Divyansh Agrawal опубликовал Qwenputer — экспериментальную модель Qwen3.5-4B, в веса которой компилятор встроил работающий 32-битный RISC-V-процессор. Оперативной памятью процессора служит состояние Gated DeltaNet-слоёв самой модели, а все веса CPU вычислены без какого-либо обучения. Во время обычного forward pass процессор исполняет программы на C и MicroPython, а опубликованный на Hugging Face checkpoint под лицензией Apache-2.0 запускается на одном GPU с 24 ГБ памяти через стандартный transformers.


Что произошло
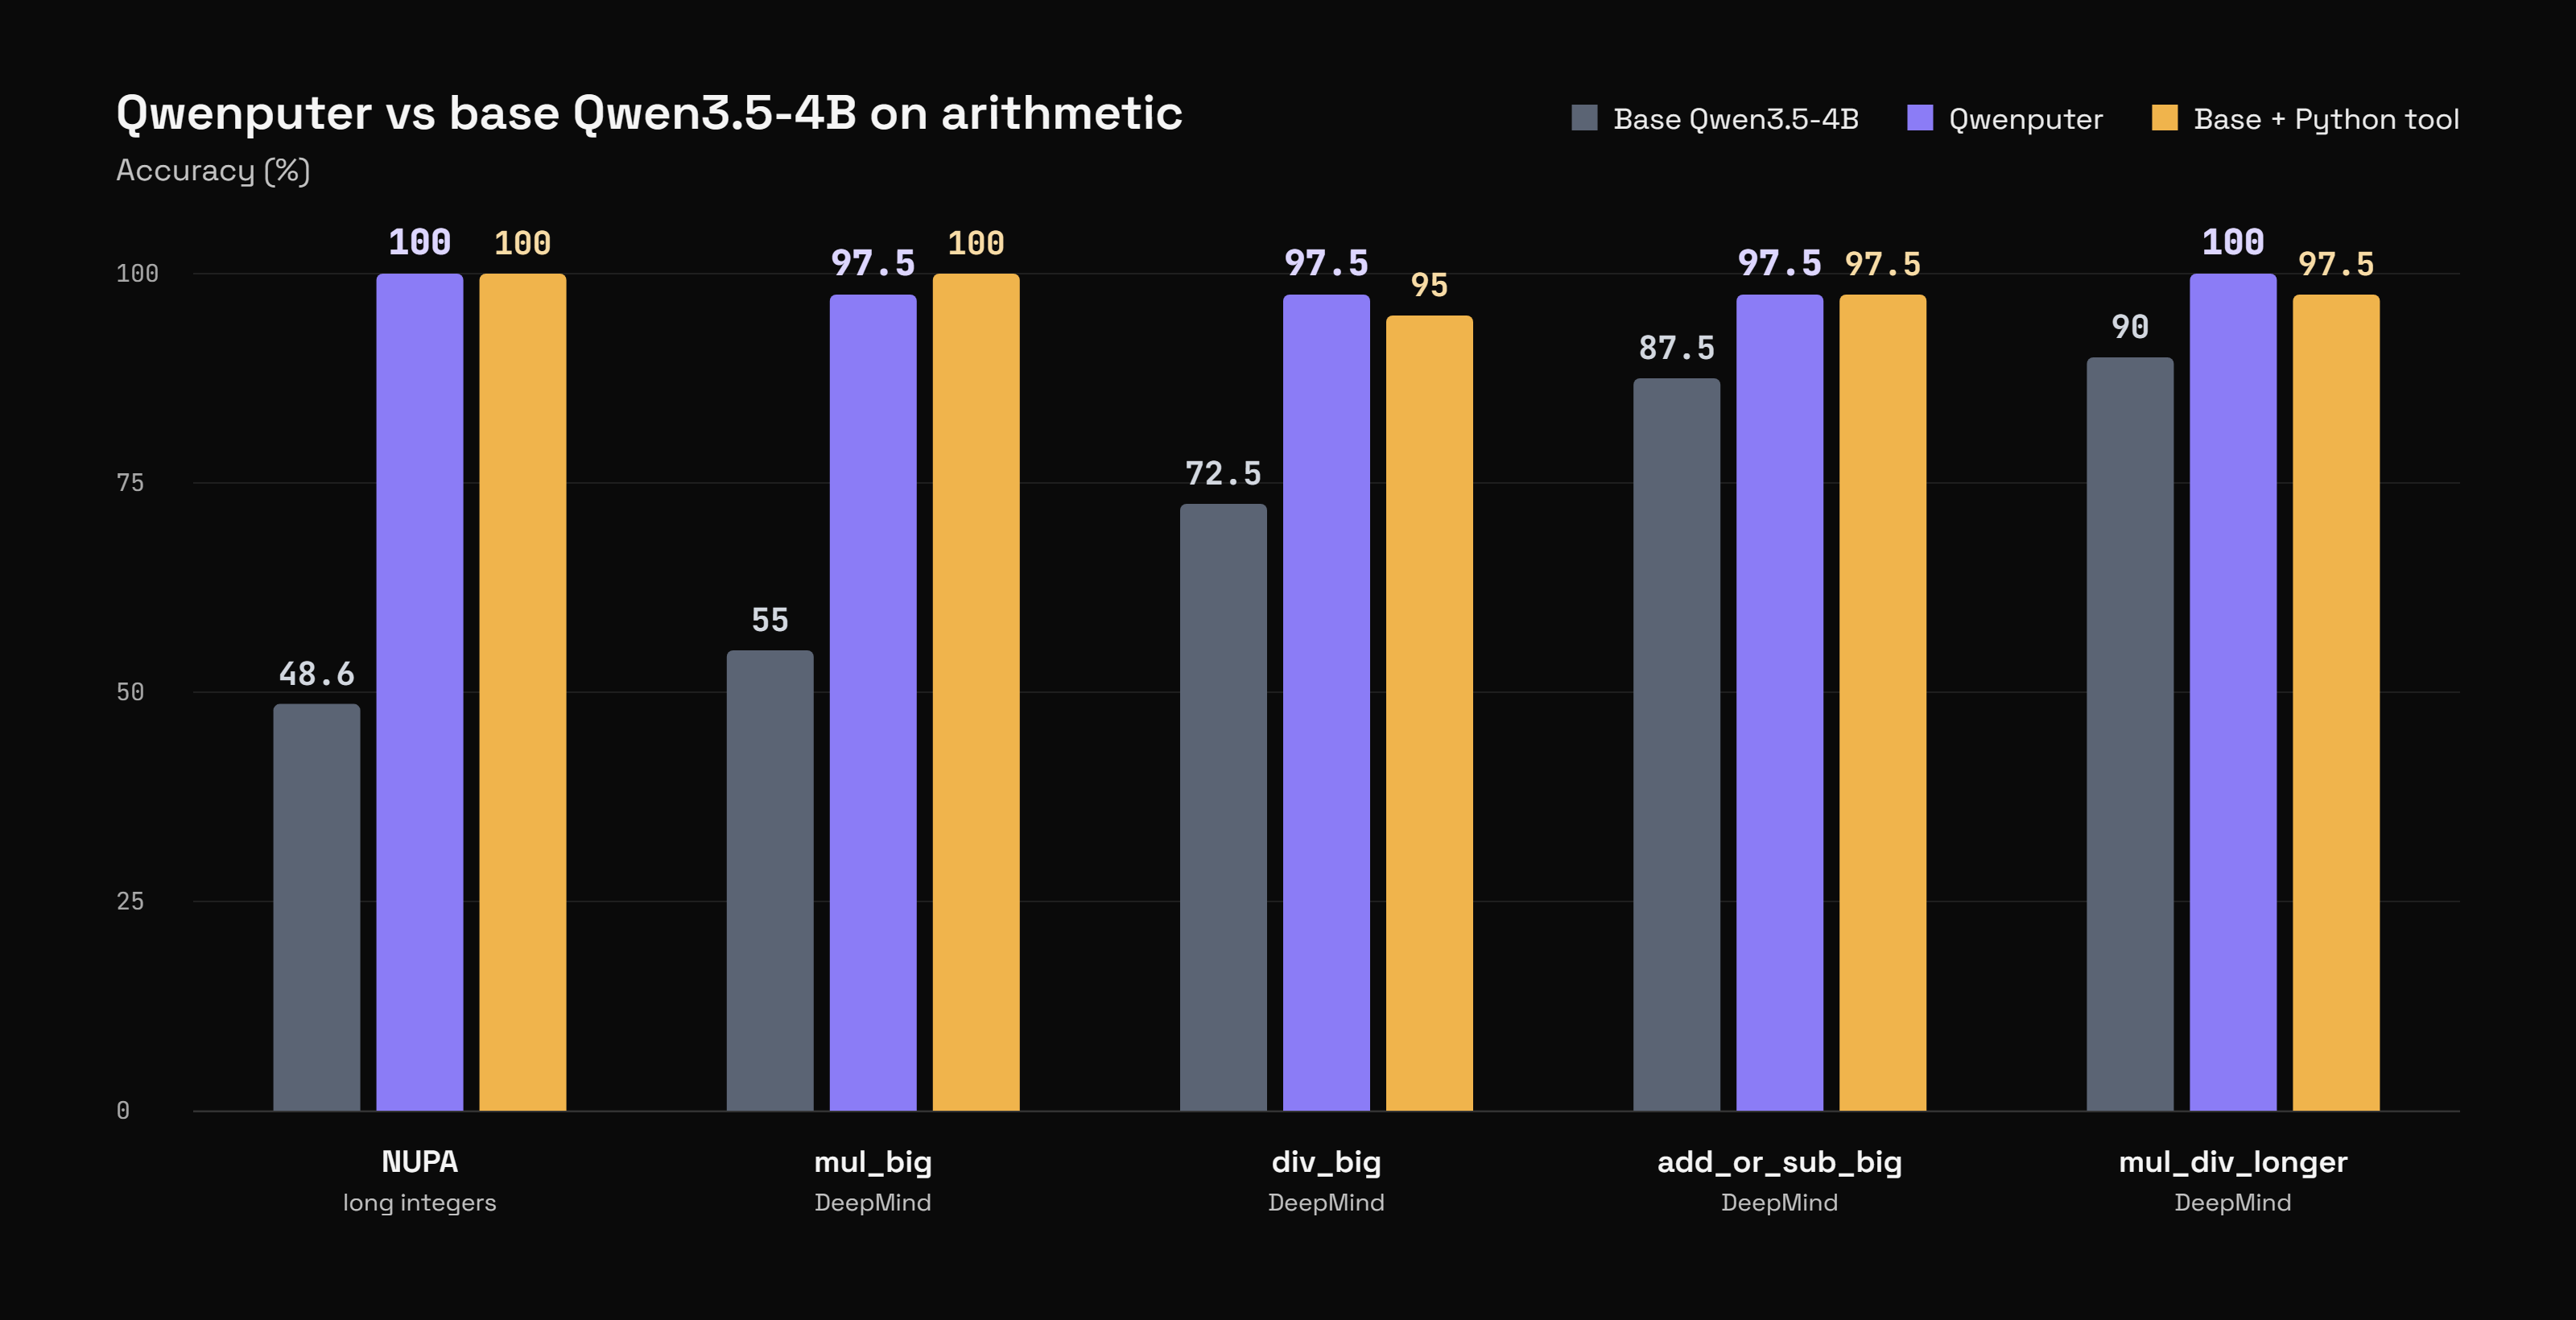
Divyansh Agrawal, известный на GitHub как divagr18, собрал Qwenputer как модификацию Qwen3.5-4B: перед 32 слоями базовой модели добавлены 11 трансформерных слоёв, которые реализуют 32-битный детерминированный RISC-V-процессор с набором инструкций RV32IM, расширением Zba и bignum-сопроцессором. Обучение в проекте не используется, роль оперативной памяти играет матрица состояния Gated DeltaNet: при gate=1 и beta=1 one-hot ключи записывают и считывают отдельные строки этой матрицы один-в-один, поэтому данные сохраняются без искажений. Автор сообщает, что процессор проходит официальный набор riscv-tests и исполняет C и MicroPython прямо во время forward pass, без внешних runtime и tool calls. Проверяемые метрики: около 230 000 позиций вывода воспроизведены с нулём расхождений, скорость составляет примерно 3200 CPU-токенов в секунду на NVIDIA L4. На арифметических бенчмарках Qwenputer набирает 97,5–100% против 55–90% у базовой Qwen3.5-4B. Checkpoint размером 18,8 ГБ содержит 9B параметров и работает на одной 24-гигабайтной GPU.
Контекст
Техническая основа проекта — концепция fast weight programmers (Schlag et al., 2021): состояние линейно-рекуррентных слоёв можно использовать как записываемую память с прямой адресацией. В обычных моделях состояние Gated DeltaNet и похожих Mamba-подобных слоёв служит сжатием контекста; автор показывает, что при gate=1 и beta=1 то же состояние ведёт себя как точная RAM. Вторая важная деталь — разница между компиляцией и обучением: веса процессора не подбирались градиентным спуском, а вычислены компилятором, поэтому поведение CPU полностью детерминировано и результат инференса воспроизводится в точности. В таком прочтении Qwenputer — демонстрация направления in-weight compute, где часть вычислений живёт не во внешних инструментах, а внутри весов самой модели.
Почему это важно для индустрии
Для отрасли продемонстрирован практический механизм компиляции детерминированной логики прямо в веса production-модели без дообучения: линейные RNN-слои превращаются в адресную RAM, и часть вычислений вместо tool calls исполняет сама модель. Схема потенциально дешева в переносе, поскольку компиляция не требует training-рана, значит приём можно попробовать на других гибридных архитектурах с линейно-рекуррентными слоями уровня Gated DeltaNet и Mamba. Если сообщество воспроизведёт результаты, вероятны форки приёма, независимые бенчмарки под батчингом и квантизацией, а со временем нишевые продукты вроде верифицируемых вычислительных слоёв для агентных пайплайнов или песочниц для недоверенного кода без внешнего runtime. Проект одновременно обостряет вопрос безопасности: рассуждения, спрятанные в RNN-состоянии, могут уходить от мониторинга chain-of-thought, и это придётся учитывать при проектировании агентных систем. Пока же это исследовательский релиз одного разработчика, без продукта, покупателей и прайсинга.
Почему это важно для пользователей
Модель открыта для проверки: checkpoint divagr1925/Qwen3.5-4B-Qwenputer выложен на Hugging Face под лицензией Apache-2.0 и запускается через обычный transformers, для чего достаточно одной 24-гигабайтной GPU. Для исследователей и энтузиастов это готовый экспериментальный полигон, на котором можно воспроизводить результаты автора и изучать устройство проекта изнутри. Отдельная образовательная ценность в том, что пример наглядно показывает: стейт-машины на DeltaNet и Mamba-подобных слоях способны работать как точная адресуемая память, а не только как сжатие контекста. Главный барьер для практического применения — скорость: вычисления внутри модели идут секундами, а не микросекундами, поэтому для повседневных задач такой режим пока непригоден.
Что пока неизвестно / ограничения
Вся количественная доказательная база, от прохождения riscv-tests до бенчмарков и измерений скорости, опубликована самим автором на divagr.com, в GitHub-репозитории divagr18/qwenputer и на карточке модели Hugging Face; независимых сторонних воспроизведений на момент публикации нет, поэтому авторская формулировка о том, что это не шутка и не симуляция, пока опирается только на его собственные данные. Арифметический выигрыш получен по построению, так как арифметику исполняет встроенный CPU, и зачитывать его как рост способностей модели нельзя. Каждая инструкция CPU стоит несколько декодируемых токенов, вычисления идут секундами, а готовых интеграций с основными inference-стеками не заявлено. Наконец, при заявленной базовой модели на 4B параметров checkpoint содержит 9B параметров, и почти удвоенный размер сам по себе является частью цены решения.
Источники
- Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5 — Divyansh Agrawal
- GitHub — divagr18/qwenputer: A computer, compiled into the weights of a language model
- divagr1925/Qwen3.5-4B-Qwenputer · Hugging Face
Автор
Look at AI, редакция