S-Agent 2.0 — открытый агент пространственного рассуждения, собранный из готового кодинг-агента OpenHands и консольного набора инструментов восприятия, без обучения новых моделей: весь стек восприятия внутри заморожен. Ключевая идея — «закрыть цикл доказательств»: агент измеряет 3D-сцену инструментами и опирается на измеренные числа, а не на визуальную интуицию. С бэкендом Gemini-3.8-Flash система набирает 74.1% на MMSI-Bench и 90.5% на ReVSI, опережая специализированную SpatialClaw и GPT-6, а код опубликован под лицензией Apache 2.0.
Что произошло
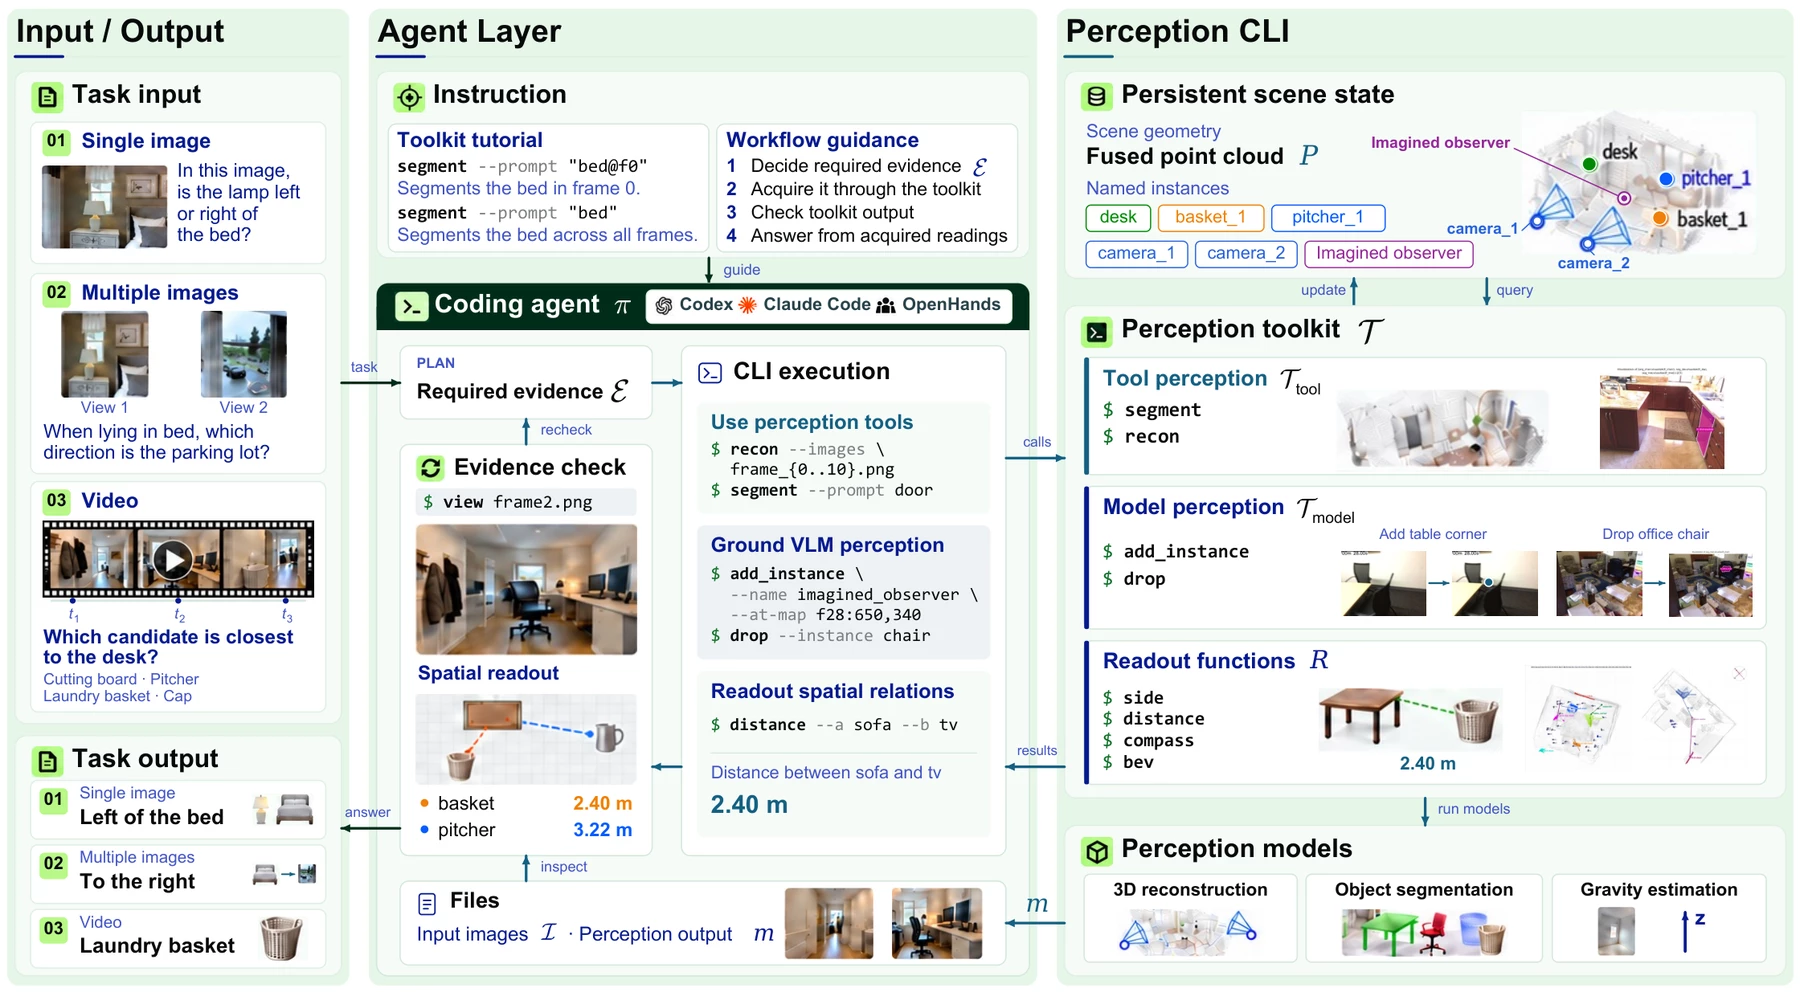
Проект опубликован публично сразу в трех видах: статья на arXiv (2610.28354), страница проекта и репозиторий github.com/Ropedia/S-Agent-2.0 под лицензией Apache 2.0. Агент построен поверх OpenHands: пространственные операции выполняются консольными командами recon, segment, distance, compass и bev, а зрение обеспечивают замороженные модели Depth Anything 3, SAM 3, GeoCalib и Pi3-MOS — новых весов не обучается. Результат каждого вызова инструмента сохраняется в постоянной памяти сцены с позицией, размером, позой и именем объекта, и агент должен интерпретировать замер в пространственном языке, указывая систему отсчета и единицы измерения. В системном сравнении с бэкендом Gemini-3.8-Flash результаты составили 74.1% на MMSI-Bench и 90.5% на ReVSI против 67.0% и 79.7% у специализированной SpatialClaw и 71.0% и 84.2% у GPT-6.
Контекст
Проблема, которую решает проект, знакома всем, кто работает с VLM-агентами: модель видит корректный замер, но игнорирует его в ответе, путает системы отсчета и «угадывает» по изображению. S-Agent 2.0 рассматривает это как ошибку интерфейса, а не модели, и проверяет гипотезу в чистом виде: ни один компонент стека не обучался под задачу, кодинг-агент взят готовый, поэтому весь прирост качества объясняется протоколом «замер инструментом, память сцены, обязательная пространственная интерпретация». Такая постановка превращает пространственное рассуждение в инженерную, а не исследовательскую задачу: превосходство достигается сборкой из общедоступных частей, а не новой архитектурой.
Почему это важно для индустрии
Для отрасли работа означает, что отдельный специализированный пространственный контроллер не обязателен: пространственный интеллект можно встроить в существующий агентный пайплайн силами инженерной сборки, без собственной модели и ML-команды. Порог входа снижается до уровня CLI-инструментов восприятия и постоянной памяти сцены поверх привычного кодинг-агента. Стек модульный и обновляется по частям: замороженные модели восприятия, набор команд и LLM-бэкенд независимы друг от друга, поэтому продукты на OpenHands или аналогичных каркасах могут воспринимать его как обычную библиотеку наряду с поиском и векторными базами. Если независимое воспроизведение подтвердит разрыв, ожидаемо копирование протокола «обязательная ссылка на измерение» в агентные фреймворки и появление готовых наборов пространственного восприятия, а далее — вертикальных продуктов вроде фото-фиксации стройки с метрическими отчетами, инвентаризации с размерами и инспекций с ответами на естественном языке.
Почему это важно для пользователей
Для инженеров и исследователей проект ценен тем, что его можно воспроизвести немедленно: репозиторий под Apache 2.0 клонируется, дообучение не требуется, достаточно CLI-обвязки и доступа к API бэкенда, а бенчмарки MMSI-Bench и ReVSI воспроизводимы. Реалистичный первый шаг — прогнать систему на собственных сценах и собрать свою оценку качества и числа вызовов инструмента, а не полагаться на табличные проценты. Минимальный эксперимент укладывается в один вечер: подключить команды recon, segment, distance, compass и bev к своему агенту и включить в промпт требование ссылаться на измеренные числа вместо угадывания по изображению. Отдельная ценность — возможность разобрать, как устроен принудительный пространственный язык интерпретации замеров, и адаптировать этот протокол под свои задачи в робототехнике или при работе с VLM.
Что пока неизвестно / ограничения
Заявленные результаты подтверждены только для бэкенда Gemini-3.8-Flash, данных по другим бэкендам нет. Сравнение системное: вклад петли замеров и вклад самой LLM в отрыв от конкурентов не разделены, абляций по числу вызовов и латентности не опубликовано. Победа на двух бенчмарках без доверительных интервалов и разбивки по типам задач не доказывает системного проигрыша специализации. Данных по латентности и стоимости каждого шага агента нет, поэтому планировать продакшен-использование на основе этих цифр преждевременно. Авторы сами называют ограничение: ошибки реконструкции и неверно поставленный наблюдатель переносятся в ответ, то есть точность системы ограничена снизу геометрией пайплайна восприятия, и на сложных сценах именно восприятие, а не рассуждение, будет главным источником ошибок.
Источники
- S-Agent 2.0: Spatial Reasoning with a General Coding Agent (arXiv:2610.28354)
- Ropedia/S-Agent-2.0 — GitHub
- S-Agent 2.0 — Project Page
Автор
Look at AI, редакция