Amazon Web Services представила открытый Physical AI Toolchain — набор эталонных архитектур, Terraform-модулей и автоматизации развёртывания, покрывающий полный цикл разработки ИИ для роботов: генерацию синтетических данных, обучение моделей, валидацию в симуляции, деплой на edge-железо и непрерывное улучшение по данным, которые роботы присылают обратно в облако. Проект связывает управляемые сервисы AWS со стеком NVIDIA Physical AI и опубликован на GitHub под лицензией Apache-2.0.
Что произошло
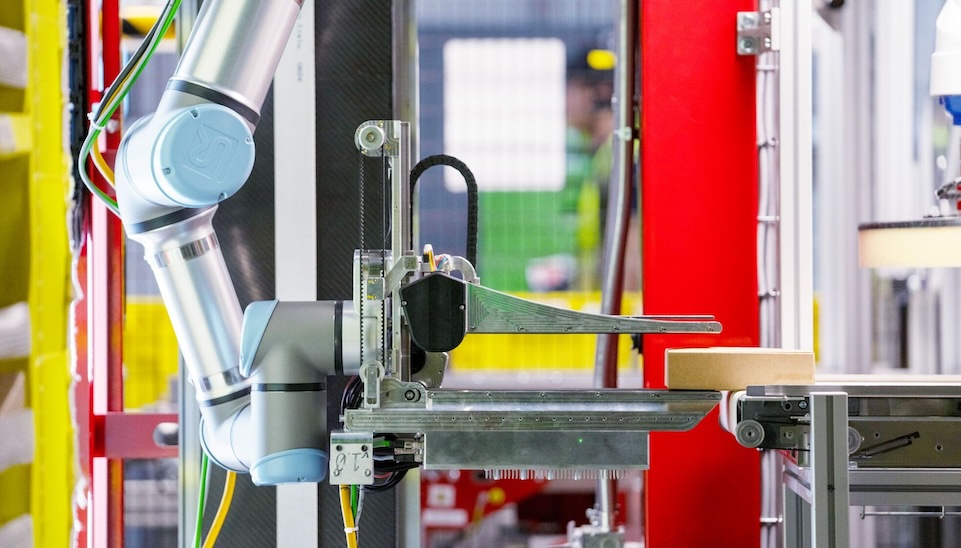
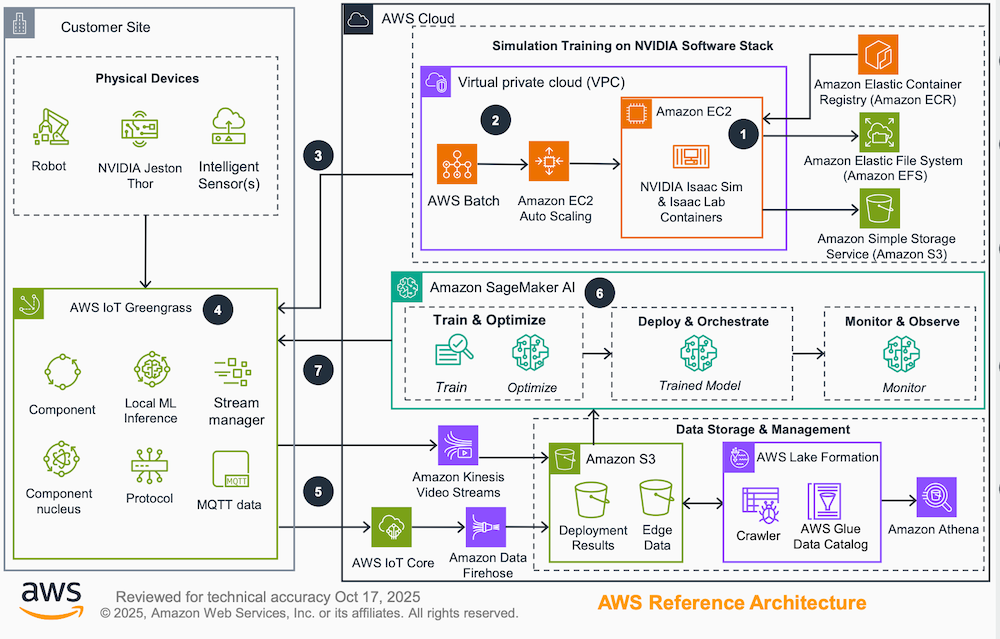
В репозитории aws-samples/sample-the-physical-ai-toolchain-on-aws на GitHub под Apache-2.0 выложены эталонные архитектуры и не зависящие друг от друга Terraform-модули, каждый из которых снабжён рабочим примером. Модули связывают сервисы Amazon S3, SageMaker, AWS Batch, EKS, EC2, ECR и IoT Greengrass с компонентами NVIDIA Physical AI: Isaac Sim отвечает за физическую симуляцию, Isaac Lab — за reinforcement learning в тысячах параллельных сред, GR00T — за дообучение vision-language-action моделей, Cosmos — за генерацию синтетики, OSMO — за оркестрацию этапов. Данные и модели передаются в открытых форматах Zarr, LeRobot, URDF, ONNX и ROS 2. В качестве проверяемого примера в репозитории приведено дообучение GR00T-политики на 27 телеоперационных эпизодах задачи UR3 pick-and-place.
Контекст
Сами компоненты по отдельности не новы: Isaac Sim, Isaac Lab, GR00T, Cosmos и OSMO — уже известные части NVIDIA Physical AI, а облачные сервисы AWS давно применяются для обучения моделей. Новым является их соединение в infrastructure-as-code: после закрытия Amazon RoboMaker в 2025 году у робототехников не было сопоставимого облачного пайплайна, путь от телеоперационных данных до обученной политики приходилось собирать вручную, и на стыках этапов команды теряли месяцы. Сектор при этом велик и растёт: по данным Capgemini Research Institute, 79% компаний уже работают с physical AI. У Amazon есть и собственный опыт эксплуатации более 1 млн роботов, и феллоушип AWS Physical AI совместно с MassRobotics и NVIDIA.
Почему это важно для индустрии
Для компаний и независимых разработчиков меняется сама модель входа в physical AI: конвейер, который раньше собирался из самописных скриптов поверх разрозненных сервисов, теперь разворачивается декларативно, отдельными Terraform-модулями, что резко снижает стоимость и сроки запуска для стартапов. Открытые форматы датасетов и политик уменьшают зависимость от конкретного вендора на уровне данных и позволяют заменить любой этап пайплайна собственным компонентом. Поскольку модули не завязаны друг на друга, а форматы открыты, эта архитектура с высокой вероятностью закрепится как де-факто референсная для сектора, и стоит ожидать сообщественных форков под сценарии вне AWS и NVIDIA. Если каркас приживётся, на горизонте пары лет вырастет сопоставимость исследовательских результатов за счёт общих форматов данных и общего пайплайна обучения и валидации, хотя остаётся риск фрагментации между облачными стеками и зависимости исследований от одного вендора.
Почему это важно для пользователей
Порог входа снижается практически до минимума: для старта нужны только AWS-аккаунт с GPU-квотой, ключ NVIDIA NGC и токен Hugging Face. Terraform-модули разворачиваются по одному, каждый этап сопровождается инструкциями и рабочим примером, поэтому первый узкий сценарий на базе готового примера из репозитория можно поднять за дни даже без предварительной экспертизы в physical AI. Разумная стратегия для первого продукта — не сразу весь пайплайн, а узкий вертикальный PoC, например дообучение политики на собственных телеоперационных данных под конкретную задачу.
Что пока неизвестно / ограничения
В первичных источниках нет ни одной численной метрики: ни успешности обученных политик, ни показателей переноса из симуляции в реальность, ни цифр по стоимости обучения и инференса или латентности edge-деплоя. Пример с 27 телеоперационными эпизодами — smoke-test-масштаб: он доказывает работоспособность пайплайна, а не обобщение или качество политики, и экстраполировать вывод о «десятках, а не тысячах эпизодов» с одного узкого сценария UR3 pick-and-place методологически некорректно, поскольку требования к объёму данных зависят от задачи. Заявления о вендор-нейтральности «к производителю роботов и типу задач» и о непрерывном улучшении по данным из облака остаются маркетинговыми утверждениями без численных подтверждений, а упомянутые кейсы Telexistence (свыше 300 гуманоидов в японских магазинах), Bedrock Robotics и RLWRLD приведены без методологии и результатов.
Источники
- Introducing AWS Physical AI Toolchain — официальный анонс в AWS Physical AI Blog
- aws-samples/sample-the-physical-ai-toolchain-on-aws — репозиторий на GitHub (Apache-2.0)
- AWS launches open-source Physical AI Toolchain for robotics — The Robot Report
Автор
Look at AI, редакция