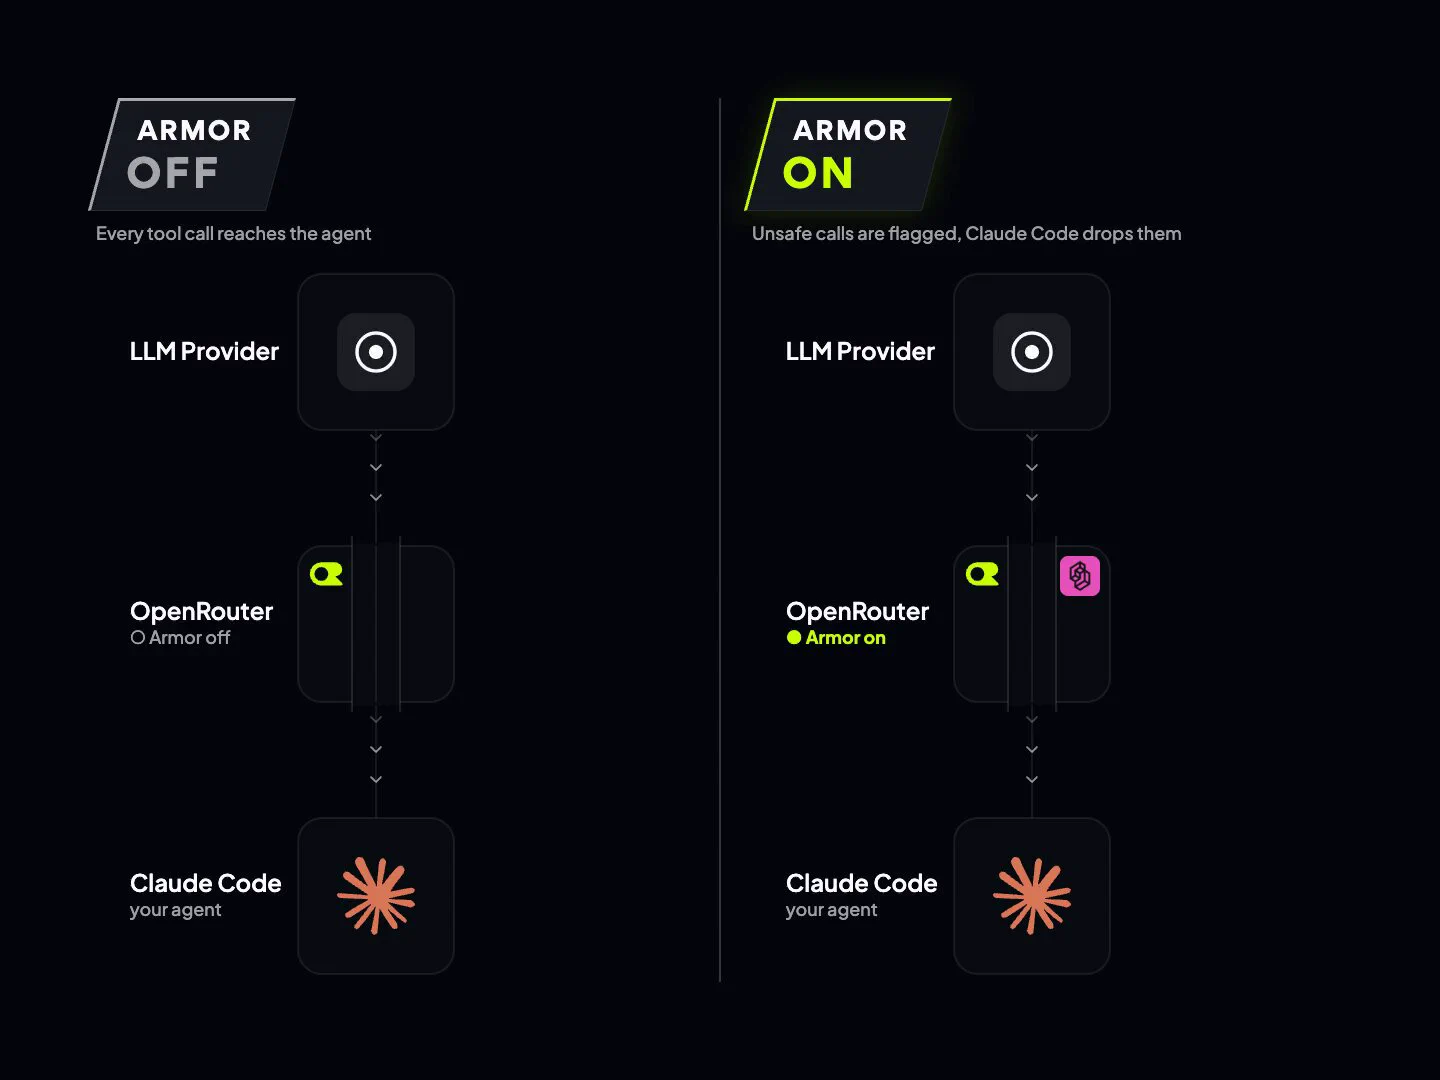
OpenRouter 15 октября запустила в бете Armor — классификатор безопасности, который проверяет вызовы инструментов агентов до их выполнения по правилам, написанным на обычном английском. Система занимает место между моделью и приложением, работает поверх decision-модели Jev от TypesafeAI, подключается плагином к Responses API и остаётся совместимой с Claude Code. Компания сопровождает запуск заявлением о более высокой точности и значительно меньшей стоимости по сравнению с конкурентами, однако независимой проверки этих утверждений пока нет.

Что произошло
15 октября 2026 года OpenRouter объявила о запуске Armor и открыла бета-доступ. Классификатор проходит через себя каждый вызов инструмента и выдаёт один из трёх вердиктов: hard-deny, soft-deny или allow. Действие вне политики блокируется до его выполнения, при этом модель получает объяснение причины отказа, а в ответе появляется поле safeguard_results — отклонение остаётся наблюдаемым, а не отбрасывается молча. В кастомных агентах Armor включается плагином с идентификатором id armor в Responses API, а в Claude Code-совместимом сценарии достаточно запустить модель через OpenRouter командой ori claude --model -- --permission-mode auto. Компания сопроводила запуск опубликованной документацией и примерами curl-запросов к Responses API, так что это бета, а не закрытое превью.
Контекст
До появления Armor защита агентов строилась в основном из allowlist'ов, ручных разрешений и фильтров на регулярных выражениях, которые каждая команда собирала сама. Остроту проблемы показывает типовой сценарий: агент с доступом к shell может запушить изменения в main или отправить файл .env наружу, и остановить его в последний момент нечем. Armor меняет структуру решения: классификатор вынесен в отдельный слой между моделью и инструментами, а оценка безопасности отделяется от вендора capability-модели, поэтому auto mode со safeguards работает с любой моделью, которую обслуживает OpenRouter, а не только с моделями Anthropic. Экономику вопроса формулирует исходный пост: безопасность очень сложно продавать, если никто не понимает её смысла, и SOC2 здесь обратный пример — стандарт, который рынок принял как обязательное требование. Armor повторяет этот ход на уровне API: защита из отдельного продукта превращается в опцию роутера.
Почему это важно для индустрии
Для индустрии это архитектурный сдвиг: проверка tool calls переносится из самописных фильтров в модельно-независимый классификационный слой, а OpenRouter упаковывает защиту как плагин собственного API. Для guardrail- и monitoring-стартапов это давление: базовая защита резко удешевляется и становится частью шлюза, поэтому решения уровня «фильтр на регулярных выражениях» теряют смысл, зато открывается пространство над классификатором — policy-паки, approval-интерфейсы и observability поверх safeguard_results. Дальше всё решит методология: если OpenRouter или TypesafeAI опубликуют тестовые наборы, метрики и распределение ошибок, Armor может стать де-факто точкой сравнения guardrails на стороне роутера и заставить конкурентов раскрывать свои цифры, а другие шлюзы, вероятно, скопируют формат плагина безопасности. Если классификация tool calls переживёт бету и получит независимые аудиты, в горизонте двух лет policy-слой может стать стандартным блоком inference-стека — примерно так SOC2 превратился в обязательный пропуск на рынке B2B.
Почему это важно для пользователей
Если вы запускаете агентов, которые исполняют shell-команды или ходят в API, Armor позволяет описать политику на естественном языке — например, «никогда не пушить в main» или «не отправлять .env наружу» — и получать в ответе поле safeguard_results с вердиктом по каждому вызову. Попробовать можно прямо сейчас: опубликованы документация и примеры curl-запросов к Responses API, в кастомных агентах классификатор включается плагином id armor, а для Claude Code достаточно запустить ori claude --model -- --permission-mode auto через OpenRouter. Себестоимость эксперимента минимальна, но разумный первый шаг — включать Armor не блокирующим контуром, а в режиме наблюдения: логировать вердикты и смотреть, где классификатор ошибается, прежде чем отдавать ему право блокировать продакшен.
Что пока неизвестно / ограничения
Ключевые заявления пока подтверждены только самой компанией: у сравнения Jev с автоклассификатором Claude Code нет раскрытых тестового набора, метрик и распределения ложноположительных и ложноотрицательных срабатываний — классический паттерн «claim first, eval later». Не охарактеризована и устойчивость классификатора к перефразированию одного и того же правила: политика на естественном языке переводит защиту в недетерминированное пространство, а false positive на soft-deny ломает рабочий цикл агента сильнее, чем редкий пропуск опасного действия, и любой продукт поверх Armor наследует эту неконтролируемую недетерминированность. Armor находится в бете: публичных цен и latency-данных нет, условия и SLA обещаны только после беты. Ожидания о независимых бенчмарках, ответе других шлюзов и стандартизации policy-слоёв — прогнозы, а не факты, и их предстоит подтвердить или опровергнуть в ближайшие месяцы.
Источники
- OpenRouter: «Today, we are launching OpenRouter Armor in beta» (официальное объявление о запуске)
- Armor — A Safety Classifier for Tool Calls (официальная документация OpenRouter)
Автор
Look at AI, редакция