SK hynix наметила, как будет меняться иерархия памяти под требования ИИ: линейка HBM продолжится до поколения HBM4E, появится кастомный HBM с логикой заказчика, DRAM будут устанавливать прямо на кристалл ускорителя, а NAND-флеш получит новую роль уровня HBF. Компания описывает происходящее как смещение узкого места ИИ-систем от вычислительной мощности к памяти: к 2030 году требования к ней могут вырасти многократно.

Что произошло
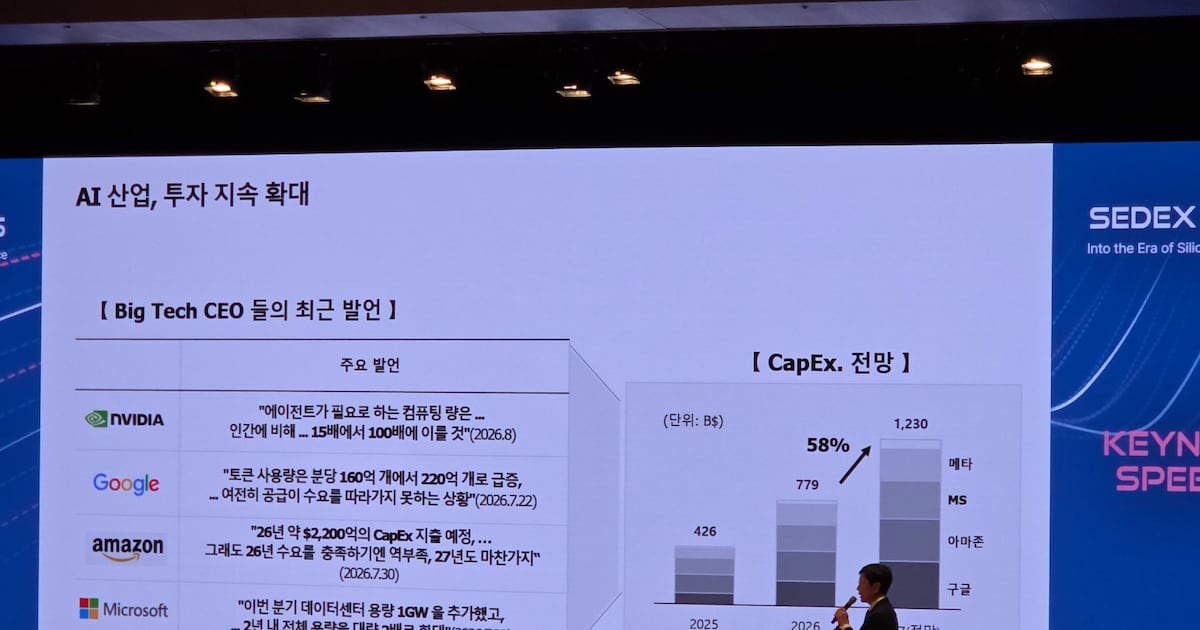
14 октября на выставке SEDEX 2026 в Сеуле CDO SK hynix Ан Хён представил дорожную карту развития памяти, рассчитанную на рост ИИ-нагрузок. Компания объявила о продолжении линейки HBM вплоть до поколения HBM4E, о расширении кастомного HBM, в котором заказчик сможет размещать собственную логику в базовом кристалле (base die), и о работе над 3D Stacked DRAM — технологией вертикальной установки DRAM непосредственно на GPU и NPU. Отдельным пунктом стал анонс HBF (High Bandwidth Flash): NAND-флеш с TSV-стеканьем, который позиционируется как уровень иерархии памяти между HBM и SSD с целевыми характеристиками примерно в половину пропускной способности HBM того же поколения при примерно десятикратной ёмкости. По оценке SK hynix, требования к производительности ИИ-инфраструктуры к 2030 году вырастут примерно в двадцать раз относительно уровня 2026 года; Chosun Biz приводит CAGR 109% за этот период. Рост требований компания связывает с увеличением KV-кэшей, длиной контекстов и объёмом запросов на инференс.
Контекст
Чтобы понять смысл этого шага, стоит вспомнить, как устроен инференс больших моделей. Состояние диалога хранится в KV-кэше, объём которого растёт вместе с длиной контекста и числом одновременных сессий, поэтому в агентных сценариях память расходуется быстрее вычислительных ресурсов. В иерархии памяти при этом остаются разрывы: SRAM на кристалле ускорителя мала по ёмкости, HBM быстра, но дорога и ограничена объёмом, а обычный SSD слишком медлен для активной работы с моделью, и компенсировать эти разрывы приходится программной логикой. Дорожная карта SK hynix в этом смысле читается как план заполнения разрывов аппаратными уровнями — уровнем памяти на самом ускорителе и быстрым флеш-уровнем для больших объёмов данных. Обязательство стандартизовать HBF через OCP совместно с SanDisk дополнительно означает, что новый класс памяти задуман как открытый, доступный всей экосистеме, а не закрытое решение одного вендора.
Почему это важно для индустрии
Для индустрии это сигнал менять базовые допущения планирования: память становится ограничителем ИИ-инфраструктуры наравне с вычислениями, и следующие поколения ускорителей и дата-центров будут проектироваться с учётом заявленной иерархии. Кастомный HBM с логикой заказчика в base die открывает поверхность для ко-дизайна памяти и ускорителя, а значит расширяет пространство архитектурных решений для всех вендоров чипов. Если соотношение полосы и ёмкости HBF подтвердится, он станет естественным носителем холодных слоёв KV-кэша и batched-инференса, где важнее ёмкость, чем пиковая скорость. Память при этом выходит на уровень ценообразующего фактора инференса: юнит-экономику стоит пересчитать с памятью как отдельной строкой затрат, профилировать рост KV-кэша и стоимости длинных контекстов в собственных системах и заложить эти метрики в TCO-модель закупок на следующий цикл. В такой конкуренции скорее выиграют те, кто строит софт вокруг новой иерархии памяти, а не те, кто просто докупает GPU. Командам планирования инфраструктуры дополнительно имеет смысл отслеживать документы OCP по HBF, чтобы вовремя увидеть формирование спецификации нового класса памяти.
Почему это важно для пользователей
Для читателя новость частично объясняет, почему ИИ-сервисы дорожают и почему длинные контексты и тяжёлые агентные сессии ограничены по цене: узкое место таких сервисов — ёмкость и скорость памяти, а дефицит HBM бьёт по рынкам и по стоимости сервисов. Немедленных продуктовых изменений ждать не стоит: это дорожная карта, а не анонс устройств, и сегодня нечего покупать или тестировать. Перспектива в том, что при частичной реализации плана инференс станет дешевле и энергоэффективнее: сценарии, которые сейчас блокирует ёмкость VRAM, например очень длинные агентные сессии и многомиллионные контексты, могут стать экономически рабочими за счёт флеш-уровня с низкой ценой за бит и более близкого размещения DRAM к ускорителю.
Что пока неизвестно / ограничения
Это дорожная карта, а не продуктовый анонс: на 14 октября 2026 года в источниках нет конкретных SKU, цен, дат доступности, измерений латентности и методик тестирования, поэтому внедрять и бенчмаркать пока нечего. Характеристики HBF — примерно половина полосы HBM при десятикратной ёмкости — заявлены как целевые, а не как результаты измерений готового устройства. Состав логики заказчика в base die, её требования к тепловыделению и энергопотреблению, программная модель и методология оценки в источниках не раскрыты. Оценка двадцатикратного роста требований к 2030 году принадлежит самому вендору и не подкреплена независимыми данными. Сроки появления образцов 3D Stacked DRAM не названы, а стандартизация HBF через OCP находится на ранней стадии, поэтому выводы о сроках перестройки иерархии памяти делать преждевременно.
Источники
- SK hynix Ahn says AI surges, drives Korea to develop 3D stacked DRAM and HBF — Chosun Biz
- SK Hynix Unveils Next-Generation Memory Roadmap to Address AI Bottlenecks — Korea IT Times
Автор
Look at AI, редакция