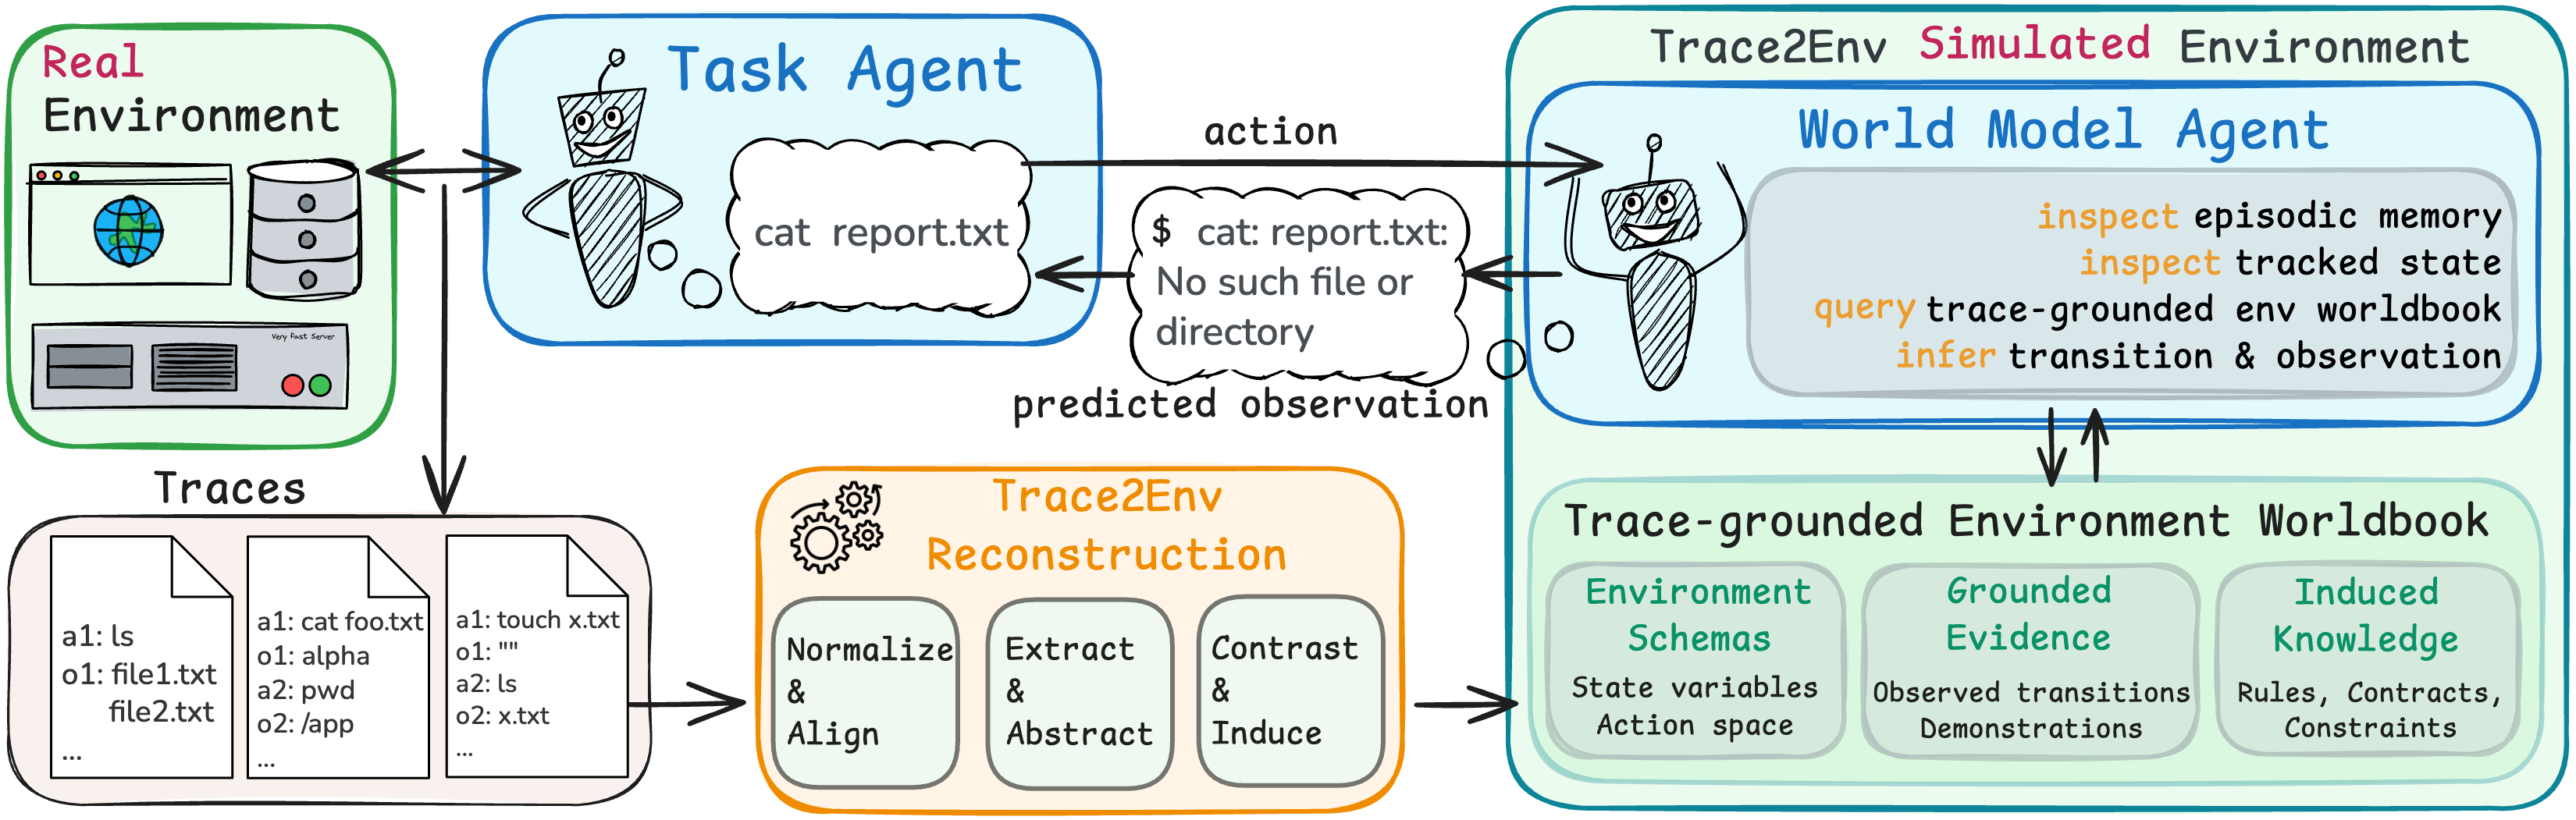
Исследователи Quanyu Long и коллеги 5 октября 2026 опубликовали статью «From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation» (arXiv:2610.06100) и открыли код фреймворка Trace2Env под лицензией Apache-2.0. Это подход без обучения: окружение для агента, решающего задачу, отыгрывает другой агент в роли мировой модели, а оффлайн из записанных логов взаимодействий собирается неизменяемая «книга мира» со схемами действий, правилами и ограничениями. Общий харнесс во время симуляции проверяет предлагаемые состояния и наблюдения и коммитит только допустимые, поэтому получается stateful-симулятор среды без исходников и инфраструктуры реальной системы. Демо уже развёрнуто на Hugging Face Spaces, так что подход можно проверить руками.


Что произошло
5 октября 2026 вышла статья об агентных языковых мировых моделях для симуляции интерактивных сред, ей присвоен идентификатор arXiv:2610.06100; GitHub-репозиторий ruyue0001/trace2env появился днём раньше, 4 октября 2026, и распространяется под Apache-2.0. Фреймворк работает без обучения. Оффлайн из десятков записанных логов взаимодействий собирается неизменяемая environment worldbook: в неё попадают схемы действий, правила, ограничения и исходные наблюдения как доказательства. При симуляции окружение для агента-задачи играет другой агент в роли мировой модели: на каждое действие он выборочно обращается к книге, текущему состоянию эпизода и эпизодической памяти, после чего предлагает эффекты состояния и следующее наблюдение. Харнесс валидирует эти предложения по схемам и инвариантам и только затем коммитит их. Именно поэтому состояние удерживается: после удаления report.txt командой rm чтение файла падает ошибкой много ходов спустя.
Контекст
Для обучения и оценки LLM-агентов нужны живые среды, но реальные системы часто недоступны, приватны или легаси, а их поддержка дорога. Альтернатива — языковые мировые модели, но в простом промптинговом варианте они плохо держат long-horizon согласованность: модель забывает, что произошло в симуляции несколько ходов назад. Trace2Env решает это не новой сетью, а архитектурой вывода: неизменяемое знание о среде отделено от мутабельного состояния эпизода, а часть нагрузки перенесена с языковой модели на детерминированный харнесс, так что ошибки симуляции становятся локализуемыми, а поведение среды — воспроизводимым. Авторы также сделали ставку на переносимость формата: заявлены конвертеры трасс из Terminal-Bench 2.0, WebArena, ALFWorld, SciWorld и EnvScaler, то есть фреймворк ориентирован на многие форматы сред, а не на одну среду. Если конвертеры работают как задумано, цена создания новой песочницы для агентов резко падает.
Почему это важно для индустрии
Для команд, строящих агентов, появляется практичный способ получать учебные и оценочные песочницы там, где реальная система недоступна, приватна или легаси: достаточно логов, из которых собирается stateful-модель среды для тренировки агентов, безопасного тестирования или stateful-моков инструментов и API. Это обесценивает один из самых дорогих входов агентной инфраструктуры — сами среды: симулятор собирается без исходников и без обучения, а Apache-2.0 и 285 оффлайн-тестов снижают порог входа для пилота внутри существующего eval-пайплайна. По данным статьи, действия агента, сгенерированные против Trace2Env, при повторном проигрывании в реальной среде чаще остаются валидными, чем у промптинговых языковых мировых моделей; прирост стабилен на двух бекбонах: 75.94 против 69.51 на GPT-5.6-Sol и 75.75 против 68.71 на DeepSeek-V4.1-Flash. При этом как production-компонент фреймворк ещё не подтверждён: в открытых материалах нет цифр по латентности и стоимости шага, поэтому реалистичная стадия сегодня — eval-стенды и прототипы, а не боевая интеграция.
Почему это важно для пользователей
Всё это можно проверить руками прямо сейчас. На Hugging Face Spaces открыто демо: терминал, который целиком отыгрывает агент, — состояние переносится между командами, а прочитанный файл реально «исчезает» после удаления. Для своих данных достаточно склонировать репозиторий (Python 3.11+): CLI-демо работает без модели и без API-ключа, 285 тестов проходят без сети, а README вместе с docs/WALKTHROUGH.md по файлам показывает, как собрать собственную «книгу мира» из своих логов. Реалистичный первый шаг — прототип stateful-мока одного своего API или терминала и прогон своих агентов против него; затраты на этом этапе ограничены инженерным временем.
Что пока неизвестно / ограничения
Единственная количественная оценка фиделити в открытых материалах — домашний бенчмарк AgentWorldBench, где официальный судья с пятью критериями на шкале 0–100 контролируется авторами метода; внешнего валидатора пока нет, а пул базлайнов ограничен Direct Prompting, что ослабляет сопоставимость цифр. Метрики латентности и стоимости шага симуляции не опубликованы. Наконец, переносимость подхода не подтверждена независимыми репликациями: остаётся неизвестным, сохранится ли превышение валидности действий на средах, не совпадающих с исходными трассами, — это ключевой маркер ближайшего полугодия.
Источники
- arXiv — From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation (2610.06100)
- Trace2Env — проектная страница Quanyu Long
- GitHub ruyue0001/trace2env — официальный репозиторий Trace2Env под Apache-2.0
Автор
Look at AI, редакция