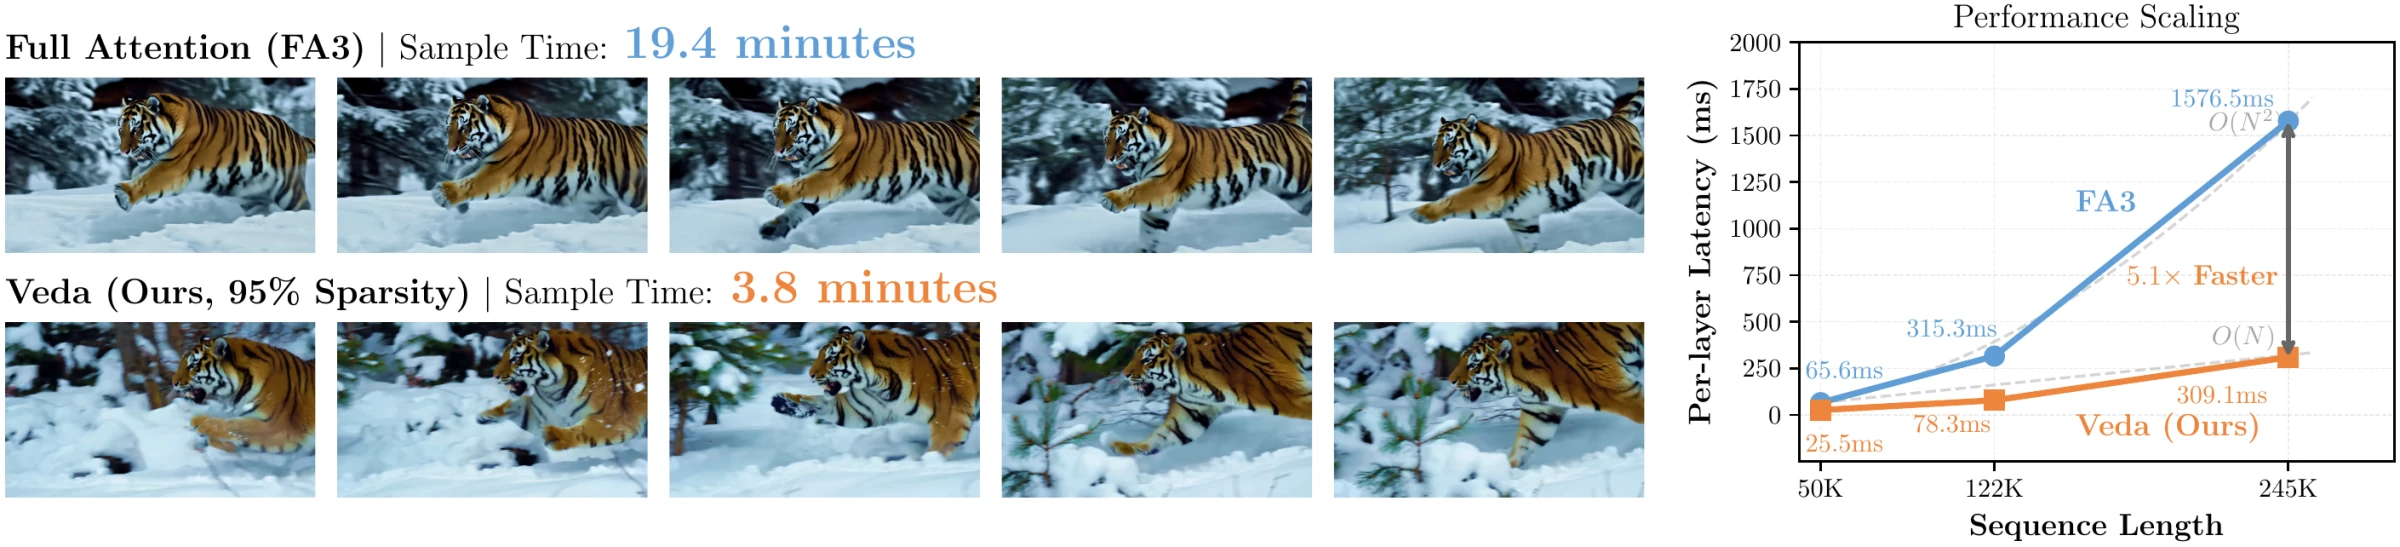
Команды ByteDance, Гонконгского университета (HKU) и Университета науки и технологий Китая (USTC) открыли реализацию Veda — метода разреженного внимания для видеодиффузионных трансформеров; статья принята на ICML 2026 (arXiv:2605.30325). Вместо полного внимания, стоимость которого растёт квадратично с длиной последовательности, лёгкий предиктор определяет, какие блоки ключей действительно нужны каждому запросу, а вычисляется только выбранная часть внимания. На модели Waver-T2V-12B генерация клипа в разрешении 720P длиной 241 кадр ускорилась с 19,4 до 3,8 минут — в 5,1 раза при 95% разреженности. Качество при этом осталось на уровне полного внимания, код опубликован под лицензией MIT, веса предиктора в fp8 выложены на Hugging Face, а заявленные цифры воспроизводимы на одной RTX 4090.
Что произошло
Репозиторий Miowtion и веса предиктора опубликованы 23–26 сентября 2026 года, одновременно с принятием статьи Veda: Scalable Video Diffusion via Distilled Sparse Attention на ICML 2026. Метод устроен так: предиктор на 275 миллионов параметров в формате fp8 работает отдельно для каждого слоя и каждой головы и решает, какие 128-токенные тайлы ключей реально нужны запросу, а block-sparse-ядро на базе FlashAttention-4 вычисляет внимание только в выбранных блоках вместо полного внимания со сложностью O(N²). На модели Waver-T2V-12B послойное внимание оказалось в 10,5 раза быстрее FlashAttention-3: 309 миллисекунд против 1576 на последовательности из 245 тысяч токенов. В человеческом сравнении на бенчмарке WaverBench1.0 при 90% разреженности зрители предпочли Veda полному вниманию в 50% случаев против 49%.
Контекст
Квадратичное внимание считалось главным узким местом видеодиффузии на длинных клипах: с ростом числа кадров и токенов стоимость полного внимания растёт квадратично, поэтому длинная генерация в высоком разрешении требовала десятков минут и серьёзных GPU. Ранние training-free подходы к разреженному вниманию критиковали за потерю локальной структуры сцены, потому что решение о том, какие токены отбросить, принималось эвристически. Veda отвечает на этот упрёк сменой постановки задачи: важна не доля отброшенных токенов, а точность воспроизведения структуры плотного внимания. Маску разреженности здесь дистиллируют через KL-дивергенцию от max-pooled плотного внимания ещё до бинаризации, а форму тайлов подбирают отдельно для каждой головы и каждого слоя — головы и слои получают свои формы тайлов. Именно такой дизайн объясняет, почему при 90–95% разреженности качество не проседает.
Почему это важно для индустрии
Внимание перестаёт быть узким местом дважды. По доле вычислений: в видеодиффузионных трансформерах на него приходилось 92% расчётов, с Veda эта доля падает до 50%. По железу: вендорный патч fa4_sm8x включает block-sparse-ядро FlashAttention-4 на потребительских картах SM8x, включая RTX 30 и RTX 40, хотя upstream FlashAttention-4 на таких картах молча откатывает блок-разреженность к плотному режиму. Ускорение в 3–5 раз на железе уровня одной RTX 4090 переводит видеогенерацию в новую ценовую категорию: стартапу больше не нужен GPU-флот, чтобы продукт на базе 33-миллиардной MiniMax-H3 имел нормальную юнит-экономику. Наконец, код под MIT и открытые веса предиктора делают быстрый инференс воспроизводимым извне — защищаться в такой конкуренции придётся данными, UX и дистрибуцией, а не скоростью генерации.
Почему это важно для пользователей
Всё описанное собирается на своём железе уже сегодня. Достаточно склонировать репозиторий Miowtion и скачать fp8-предиктор с Hugging Face: файл занимает 263 МиБ против 525 МиБ у bf16-версии, а recall отличается лишь на 2e-5. Деплой-инструкции в AGENTS.md покрывают RTX 4090 (SM89), Hopper (SM90) и Blackwell (SM120), а скрипт scripts/generate.py рендерит dense- и Veda-версии одного промпта бок о бок с таймингами, так что разницу видно сразу. На одной RTX 4090 с 24 ГБ памяти 33-миллиардная MiniMax-H3 генерирует клип с ускорением до 2,76x end-to-end, а на клипах длиной 14,4 секунды при 90% разреженности — около 3,1x; команда может проверить эти цифры за рабочий день.
Что пока неизвестно / ограничения
Пока распространяется preview-чекпоинт предиктора: он обучен всего 600 обновлений и только на клипах длиной 5,17 секунды — на клипы 10,1 и 14,4 секунды метод обобщается, но на них не обучался. Конфигурация рассчитана на 8 шагов денойзинга, а предиктор привязан к своим 12 тайл-планам (4 соотношения сторон на 3 длительности) и бесполезен без парного плана. Результат 50% против 49% на WaverBench1.0 — статистическая ничья: это отсутствие измеримой деградации, а не превосходство Veda над плотным вниманием. Перенос метода на другие видеодиффузионные модели не проверен, поэтому говорить о том, что быстрый инференс уже стал коммодити, можно будет только после независимых воспроизведений вне исходных команд. Ожидания полновесных чекпоинтов вместо preview и расширения сетки тайл-планов — интерпретации, а не подтверждённые факты.
Источники
- Veda: Scalable Video Diffusion via Distilled Sparse Attention (проектная страница, ICML 2026)
- GitHub: veda-sparse/Miowtion — разреженное ускорение (Veda) и LoRA-файнтюн MiniMax-H3
- Hugging Face: Veda-Sparse/Minimax-H3-T2VA-Veda-8NFE-600Step-Preview
Автор
Look at AI, редакция