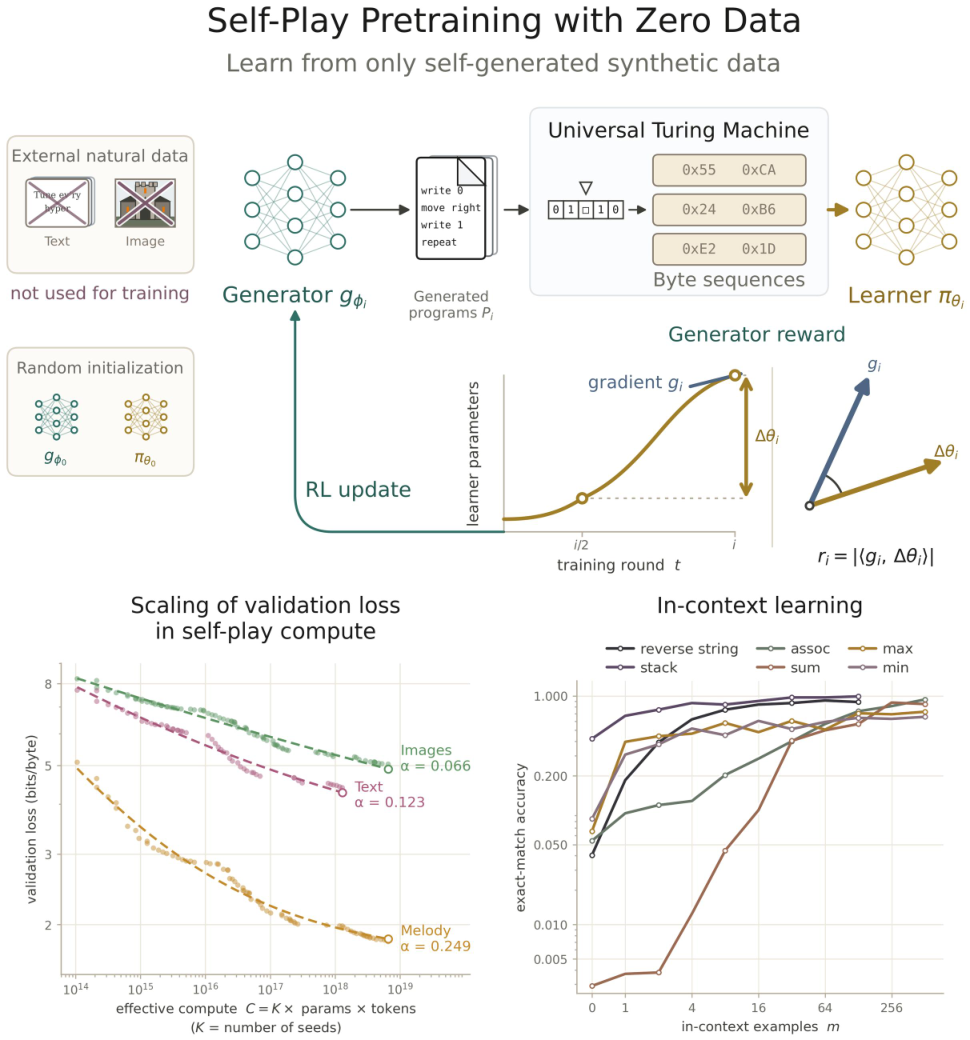
На arXiv 24 сентября 2026 года вышел препринт 2609.30063 «Self-Play Pretraining with Zero Data» — первый proof-of-concept претрейна языковой модели вообще без человеческих данных. Генератор и ученик стартуют со случайной инициализации и обучаются исключительно на данных, которые генератор создаёт сам через программы для универсальной машины Тьюринга, подстраивая их под границу возможностей ученика. На нескольких естественных датасетах zero-shot-лосс предсказуемо падает с ростом compute self-play. Пока это proof-of-concept малого масштаба, но с воспроизводимым скейлинг-сигналом, за которым стоит следить.


Что произошло
Препринт подготовили Адитья Коусик, Кфир Долев, Майкл Ю. Ли, Г. Бруно Де Лука, Нурья Коэн, Ноа Д. Гудман и Йоав Левин; первый трое внесли равный вклад. В эксперименте ни генератор, ни ученик ни разу не обучаются на естественных данных: генератор получает RL-награду за создание последовательностей ровно на границе возможностей ученика, что формирует адаптивную учебную программу (curriculum), а ученик стандартной cross-entropy авторегрессионно предсказывает байтовые последовательности, порождённые программами, исполненными на универсальной машине Тьюринга (UTM). Авторы показывают предсказуемое масштабирование zero-shot-лосса на нескольких естественных датасетах в зависимости от compute self-play, возникновение in-context learning и самостоятельное нахождение моделями узнаваемых математических последовательностей.
Контекст
Процедура вдохновлена индукцией Соломоноффа — постановкой, в которой поиск ведётся по пространству всех вычислимых порождающих процессов; в этой логике self-play означает поиск кратчайших программ, порождающих полезные для обучения данные, а UTM задаёт пространство поиска, покрывающее все такие процессы. Честность дизайна важна для измерения переноса: поскольку ни генератор, ни ученик не видят естественных данных на всём протяжении обучения, рост zero-shot-качества на природных датасетах является чистой метрикой генерализации, а не утечкой из человеческих корпусов. Отличать эту работу нужно от Absolute Zero (arXiv 2505.03335, май 2025): там самопорождённые RL-задачи без данных применялись только для дообучения reasoning, здесь же претрейн ведётся с нуля — существенно более сильное заявление, которое proof-of-concept лишь открывает, а не закрывает.
Почему это важно для индустрии
Претрейн сегодня упирается в конечный объём отобранных людьми данных, и в работе предложен конкретный механизм снятия этого потолка: RL-награда генератору за последовательности на фронтире возможностей ученика связывает объём полезных учебных данных с compute, а не с запасами текстов. Для бизнеса это гипотеза демонтажа дата-моатов и переноса ценности из накопленных корпусов в вычисления — пока именно гипотеза, а не установленный факт. Для билдеров это ранний сигнал о смене ограничений: если претрейн без человеческих данных масштабируется, кастомные и нишевые модели под домены и языки без корпусов становятся обучаемыми за compute. При подтверждении тренда на горизонте порядка двух лет реалистичен не полный отказ от человеческих данных, а гибридный претрейн, в котором self-play-данные закрывают часть бюджета данных и дефицитные домены.
Почему это важно для пользователей
Для читателя это исследовательский результат, а не продукт: weights, API или готовых инструментов у работы нет. Статья открыта для чтения — доступны PDF и HTML-версия на arXiv, а Figure 1 со схемой self-play-цикла (генератор → программы → байтовые последовательности → ученик) позволяет понять механику без погружения в математическую часть. Если претрейн входит в ваш круг наблюдения, препринт стоит зафиксировать в мониторинге: в ближайшие месяцы ожидаются воспроизведения независимыми группами, рост параметров и compute self-play, а также абляции генератора и функции награды. Практически полезный маркер — держится ли предсказуемое масштабирование zero-shot-лосса при росте compute на порядки.
Что пока неизвестно / ограничения
Заявление «объём полезных учебных данных стал функцией compute» пока нельзя считать установленным фактом: в работе показано предсказуемое масштабирование zero-shot-лосса на малом proof-of-concept, а экстраполяция кривой за пределы проверенного compute — интерпретация, а не результат. Между малым proof-of-concept и промышленным претрейном стоят нерешённые вопросы эффективности RL-генератора. Ключевые проверки впереди: сравнения с претрейном на curated human data при равном compute и перенос эффекта на downstream-задачи, а не только на zero-shot-лосс. Кроме того, к препринту не приложены код, веса или API, а масштаб экспериментов мал, поэтому о промышленной применимости говорить преждевременно.
Источники
- [Self-Play Pretraining with Zero Data — arXiv:2609.30063 [cs.AI] (аннотация, авторы, дата подачи)](https://arxiv.org/abs/2609.30063)
- Self-Play Pretraining with Zero Data — PDF статьи (arXiv)
- Self-Play Pretraining with Zero Data — HTML-версия arXiv (v1, включая Figure 1)
Автор
Look at AI, редакция