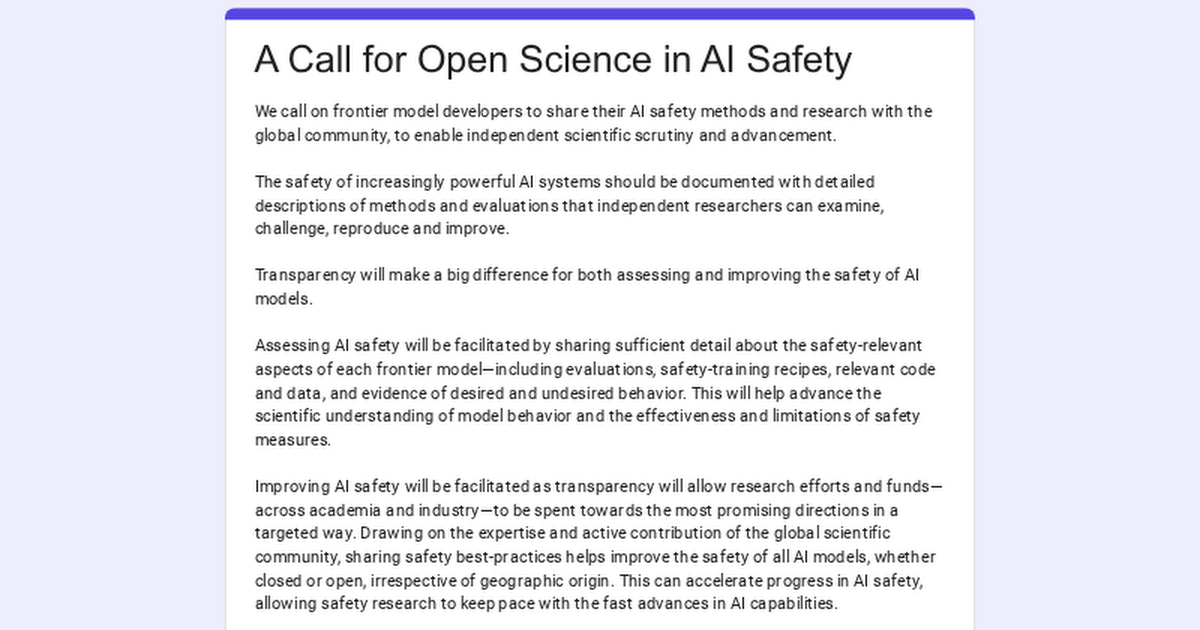
18 сентября 2026 года группа исследователей во главе с Мартином Джагги и Робертом Уэстом (EPFL), Филипом Торром (Оксфорд) и Анной Хедстрём (ETH Zurich) опубликовала открытое обращение «A Call for Open Science in AI Safety». Авторы просят разработчиков фронтирных, то есть самых мощных, ИИ-моделей публиковать методы обеспечения безопасности: оценки (evaluations), рецепты safety-обучения, код, данные и свидетельства желаемого и нежелательного поведения моделей, чтобы независимые исследователи могли проверять, воспроизводить и улучшать эти меры. К моменту проверки обращение подписали около 208 человек, включая сотрудников Google DeepMind, Hugging Face и EleutherAI, при этом все подписи заявлены в личном качестве.

Что произошло
Обращение размещено на отдельной странице make-safety-open.github.io, там же ведётся список подписантов и форма подписания. Авторы требуют от лабораторий раскрывать проверяемые артефакты безопасности: проведённые оценки (evaluations), рецепты safety-обучения, соответствующий код и данные, а также свидетельства того, как модели ведут себя в желаемых и нежелательных сценариях. В тексте закреплена оговорка: misuse-чувствительную информацию можно не публиковать, но каждое такое исключение должно быть точечным и соразмерным. Среди подписавших значатся Фабиан Педрегоса и Александр Рам (Google DeepMind), Льюис Танстолл (Hugging Face) и Стелла Бидерман (EleutherAI), а также исследователи из MIT, Принстона, Стэнфорда, Оксфорда и Цюрихского университета. Авторы обещают обновлять документ и список подписей.
Контекст
Дискуссия о безопасности ИИ до сих пор во многом строилась вокруг закрытости: лаборатории проверяют собственные модели сами и публикуют лишь краткие отчёты, а внешние исследователи остаются с заверениями, которые нельзя проверить. Стандартное возражение против раскрытия хорошо известно: рецепты обучения и данные могут выдать коммерческие секреты или помочь злоумышленникам. Авторы обращения отвечают на это выбором единицы раскрытия: они запрашивают методы и свидетельства, а не веса моделей, поэтому научная проверяемость отделяется от самой коммерчески и misuse-чувствительной части разработки. Состав подписантов показывает, что идея находит отклик и внутри самих лабораторий, хотя ни одна из них как организация никаких заявлений не делала.
Почему это важно для индустрии
Для отрасли обращение смещает фокус спора о безопасности ИИ с закрытости на проверяемость: лабораториям, вероятно, придётся доказывать безопасность артефактами, а не формулировками. Если давление академического сообщества сработает, фронтир-лаборатории могут ожидать требования публиковать safety-рецепты и отчёты об оценках в проверяемом виде, что затронет практику model cards и порядок safety-отчётности перед релизами. Для стартапов это ранний рыночный сигнал: вокруг независимой верификации и safety-инфраструктуры — репозиториев eval-датасетов, harness'ов, шаблонов отчётности — может сложиться отдельный слой рынка. Пока это давление сообщества без обязательств адресатов, и самый честный индикатор один: появится ли у хотя бы одной фронтир-лаборатории воспроизводимый артефакт в ответ на обращение.
Почему это важно для пользователей
Для читателя обращение полезно как разъяснение того, из чего на практике состоит безопасность ИИ: это не абстрактные заверения, а набор конкретных проверяемых документов и артефактов, которые можно читать, запрашивать у вендоров и сравнивать между собой. Текст обращения и список примерно из 208 подписантов открыты на сайте, подписать обращение можно через форму, а документ обещают обновлять, поэтому за списком удобно следить как за картой сообщества. Инженерам и руководителям команд рамку обращения можно применять уже сейчас: переносить её во внутренние требования к вендорам и подрядчикам, запрашивая методы и свидетельства проведённых проверок, а не только итоговые заявления о безопасности.
Что пока неизвестно / ограничения
Обращение не задаёт ни метрик, ни форматов отчётности, ни порога достаточной прозрачности: неизвестно, что считать достаточной публикацией evals, кто выступает арбитром и как проверять полноту раскрытия, поэтому риск декларативности высок. Это метанаучная декларация, а не технический результат: у неё нет API, релизов или бенчмарков, и разворачивать пока нечего. Практический эффект на сегодня нулевой, обсуждение на Hacker News на момент проверки ограничилось одним баллом без комментариев, а институциональных обязательств нет ни у одной лаборатории, так что доказательной базы изменения практики не существует. Число подписантов зафиксировано на момент проверки и будет меняться, а любые прогнозы о реакции лабораторий остаются интерпретациями до появления конкретных опубликованных артефактов.
Источники
- A Call for Open Science in AI Safety (petition page)
- Hacker News discussion: A Call for Open Science in AI Safety
- Sign the petition (Google Forms)
Автор
Look at AI, редакция